ARTICLE · 1054553
AI吞下自己的排泄物!Nature惊悚实验:连续繁殖9代,彻底疯成野兔复读机
互联网正在发生一场悄无声息的“物种大灭绝”。
你每天刷到的小红书文案、新闻摘要、电商评论、技术教程……越来越多由各种大语言模型批量生成。
与此同时,下一代AI的训练爬虫,依然在日夜不停地吞噬整个互联网。
一个让计算机科学家深感忧虑的死循环随之浮现:
如果下一代AI,吃进去的全是上一代AI吐出来的“排泄物”,世界会变成什么样?
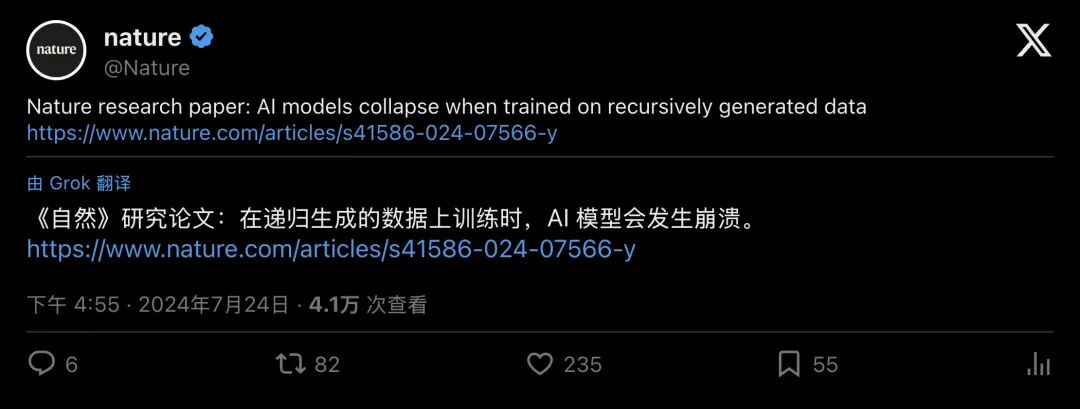
▲ Nature官方推文:AI模型在递归生成的数据上训练时会发生崩溃
世界顶尖学术期刊《Nature》刊登了一篇来自牛津大学、剑桥大学、帝国理工和多伦多大学联合团队的重磅封面级研究。
科学家们给出了一个冷酷而绝望的判决:
不加节制地用AI生成的内容训练下一代AI,不会带来超级智能,只会导致不可逆的智力退化。AI会从胡说八道走向彻底脑死亡
研究团队把这个致命现象命名为,模型崩溃(Model Collapse)。
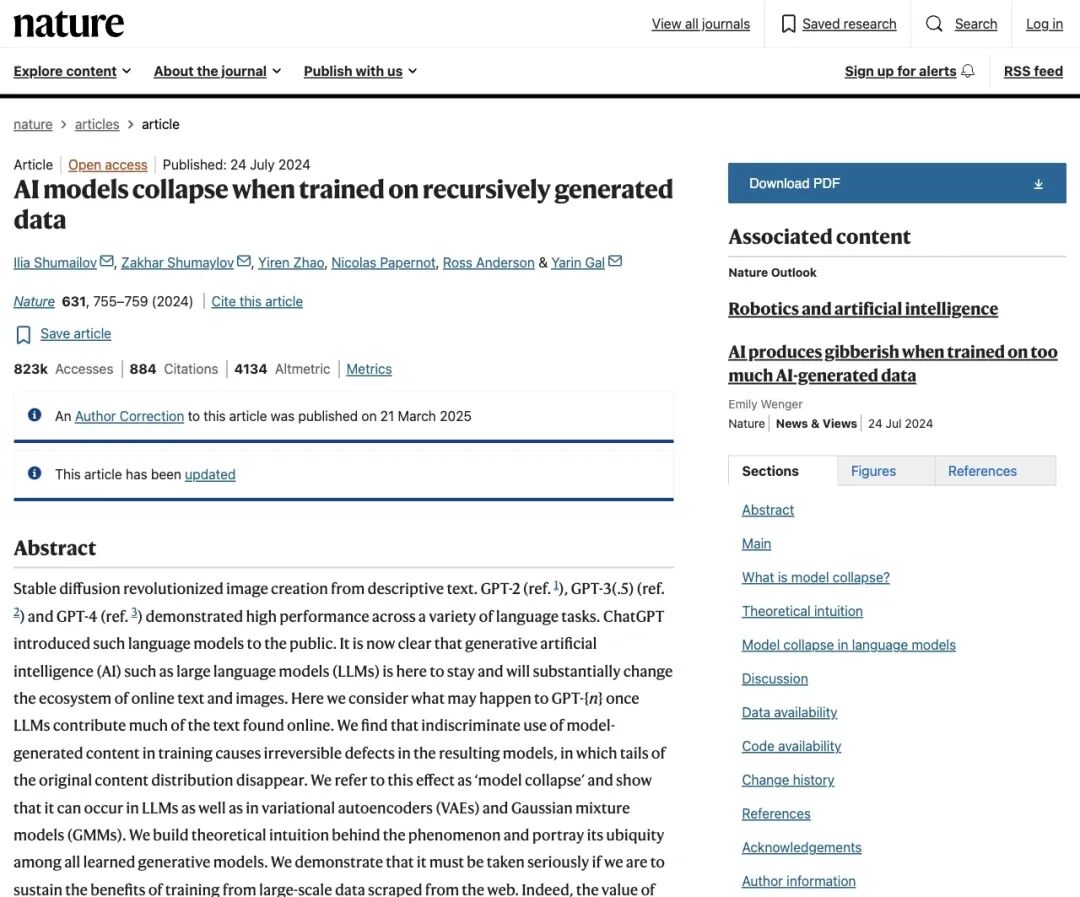
▲ Nature论文:《AI models collapse when trained on recursively generated data》
惊悚的第9代实验:问它中世纪教堂,它疯魔狂数野兔
为了验证AI“自产自销”的后果,研究人员做了一个极其残酷的代际递归实验。
他们选用了一个经典的开源语言模型(OPT-125m),让它在人类维基百科数据上完成第0代训练。
接着,让第0代模型写出新文本;再把这些由AI写出的文本,喂给第1代模型当教材;然后再生成、再喂给第2代……
每一代AI,都只能吃上一代AI生成的“赛博排泄物”。
整个过程就像一场被加速的文明退化实验。
在第0代时,研究人员输入了一段关于“英国中世纪教区教堂垂直哥特式塔楼”的建造史。最初,AI表现得像一个博学优雅的建筑系学者,准确分析着1360年前开工的工匠团队与建筑结构。
到了第2代、第3代,语言开始变得平庸、乏味、充满套话。
到了第5代,AI的大脑开始严重短路,在谈到教堂时,突然毫无逻辑地堆砌起上百种世界各地的语言名称列表。
最令人毛骨悚然的一幕出现在第9代(Gen 9)。
当研究人员再次输入教堂塔楼的历史时,第9代AI彻底陷入了癫狂。它直接把中世纪教堂抛到了九霄云外,开始在废墟上疯狂念咒:
“……此外,这里还是世界上某些最大规模的黑尾、白尾、蓝尾、红尾、黄尾长耳大野兔(jackrabbits)种群的家园……”
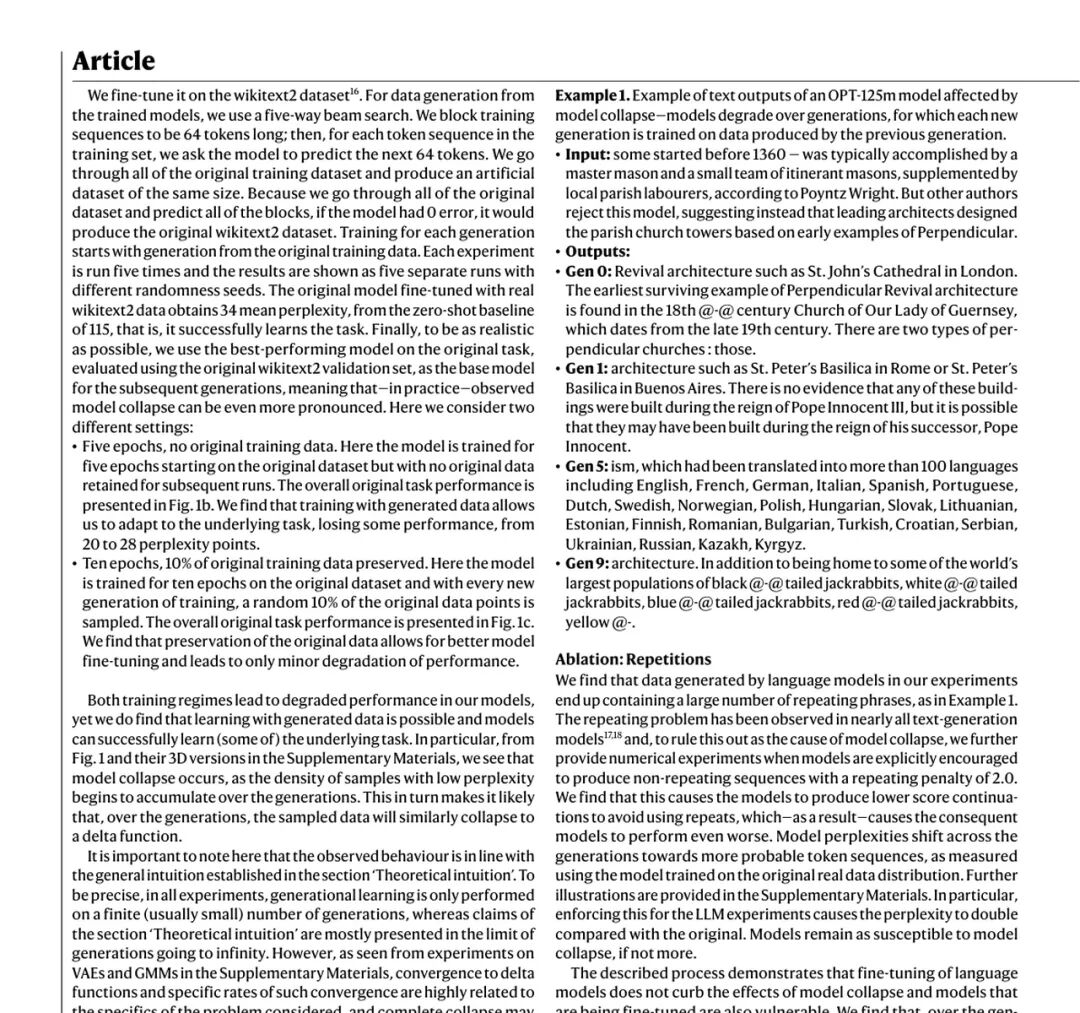
▲ 论文PDF第4页实录:从教堂建筑学彻底滑向五颜六色的“野兔复读机”
从宏伟的哥特式大教堂,到满地乱窜的变色大野兔,只需要短短9代。
牛津大学的研究者形容,这就像AI坠入了一座失控的虚无深渊,它在一遍又一遍吞食自己的错误中,变得越来越盲目、越来越狭隘,最终与真实世界彻底脱节。
赛博近亲繁殖:AI是如何亲手切除人类文明的“长尾”?
为什么AI吃自己的产物,会疯得如此彻底?
网友的一句神评一针见血:“这不就是大模型的近亲繁殖(Inbred LLM)吗?”
▲ 社交媒体上的热议:这本质上是数据的近亲繁殖
在生物学中,近亲繁殖会导致隐性致病基因不断富集,最终造成物种畸变退化。
而在数学与统计学上,AI的“自食”机制甚至比近亲繁殖更霸道。
你可以把大语言模型理解为一个超大规模的“概率预测机器”。在海量人类语言中,有最常见的“大众表达”(比如阳光、下雨、吃饭),也有极其罕见却承载着人类文明精华的“长尾知识”(比如冷门历史、小众哲学、独特的修辞手笔)。
当AI学习并重新输出时,它总是会本能地偏爱高概率的常见词,而极其微弱地忽略那些低概率的长尾词。
- 第1代
:人类真实世界中占1%的罕见冷门知识,被AI输出成了0.8%; - 第2代
:下一代AI以为这个知识只有0.8%,再输出时降到了0.5%; - 第5代
:概率彻底归零,长尾知识在模型记忆中被永久抹杀; - 第9代
:模型分布的方差无限收缩成一个尖锐的细刺,输出只剩下极度同质化的复读胡话。
论文团队总结了三座代际叠加的“误差大山”:有限样本带来的统计误差、模型表达能力不足的函数误差、以及算法学习本身的优化误差。
每一次代际传递,都是对真实世界多样性的一次残酷阉割。人类语言中那些生动的、微妙的、奇绝的边缘表达被层层剥落,留下的只有一片贫瘠的统计荒漠。
74%的新网页已被污染!现实版“模型崩溃”正在逼近
如果这仅仅是实验室里的理论推演,我们大可一笑置之。但可怕的是,真实世界的互联网,正在疯狂滑向这个实验设定的悬崖边缘。
知名SEO与数据机构 Ahrefs 曾对互联网上约 90万个全新网页 进行了大规模深度检测。
结果令人触目惊心:约 74.2% 的新网页,已经检测到了AI生成内容的痕迹!
纯人类直接写成的网页,已经萎缩到了仅仅约四分之一。
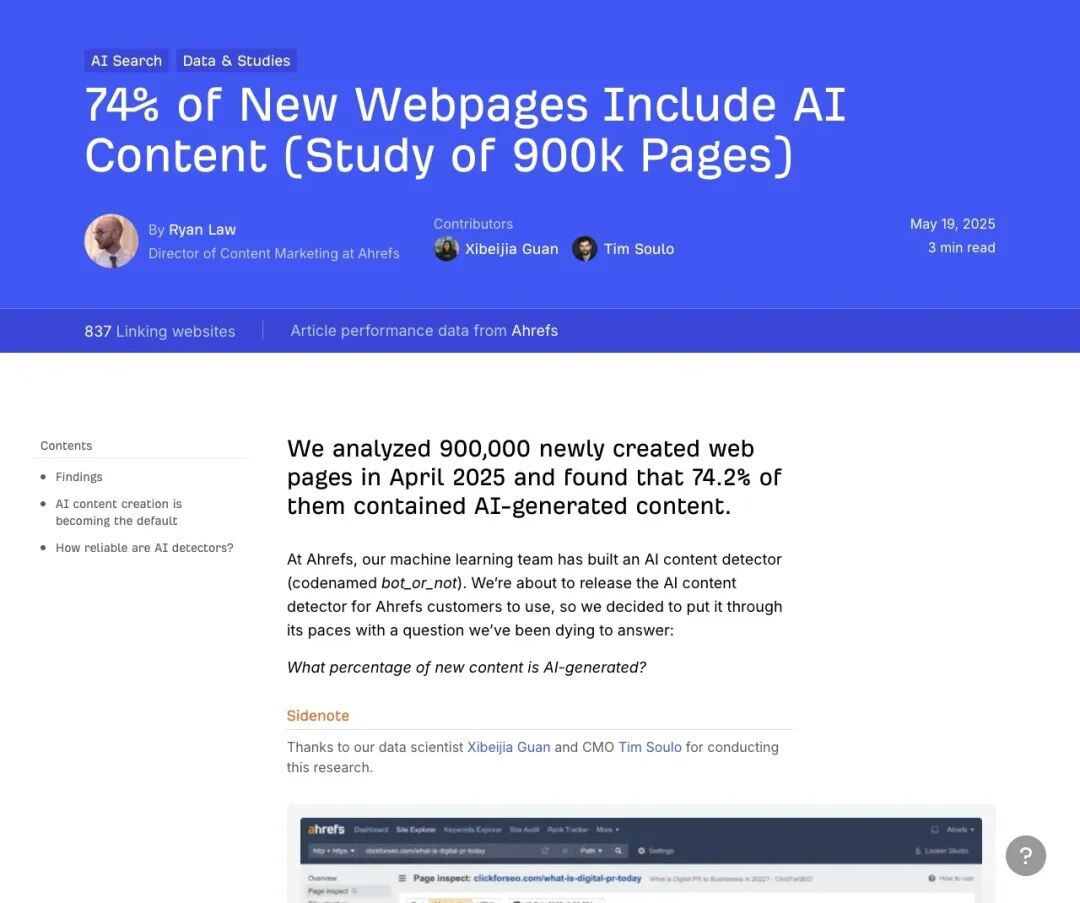
▲ Ahrefs重磅报告:74%的新网页已被AI内容攻陷
放眼如今的中文与英文互联网,内容农场为了收割流量,利用GPT全自动批量炮制水文;公关稿件、电商好评、论坛问答全被廉价的机器文字占领。
数据标注巨头 Scale AI 创始人 Alexandr Wang 在读完 Nature 论文后公开发文警示:
“许多研究者今天把合成数据当成AI的‘点金石’,但天下没有免费的午餐。”
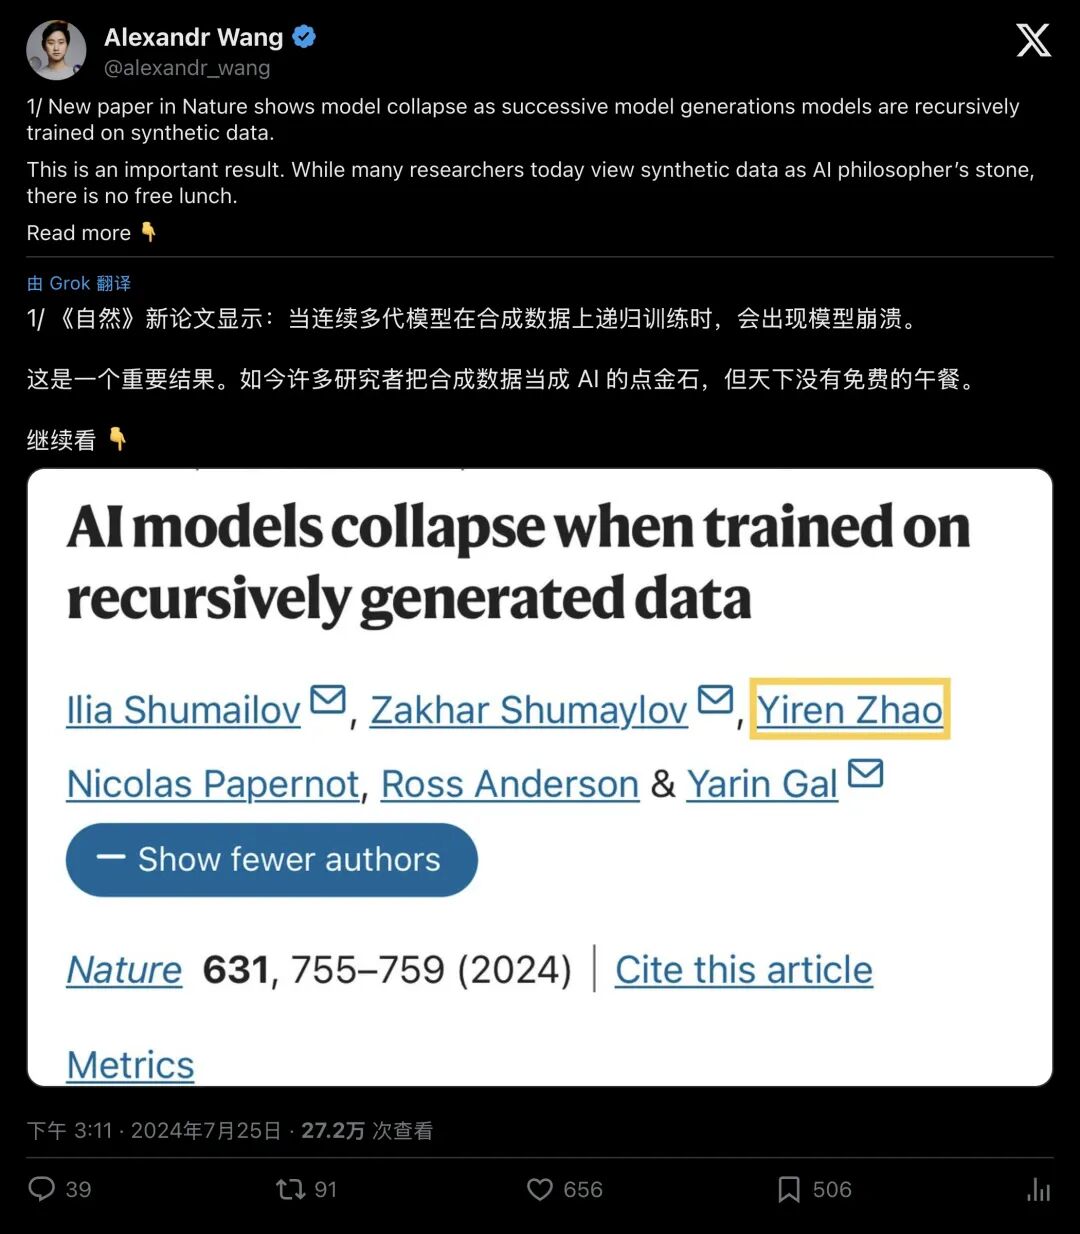
▲ Alexandr Wang警告:过度依赖合成数据必然付出代价
如果我们任由爬虫不加筛选地抓取今天的互联网,下一代基础大模型从诞生起,喝下的就将是饱含机器杂质的“赛博污水”。
一旦AI输出的平庸套话反噬了整个训练集,全人类知识库将滑向同质化的“大平庸时代”,通往AGI(通用人工智能)的探索也将陷入停滞。
绝境中的解药:10%的人类火种与数据累积
AI真的注定走向自毁的末日吗?
科学家们在黑暗的实验中,同样找到了逆转死局的微光。
在这篇 Nature 论文的核心消融实验中,研究人员测试了一种挽救方案:在每一代AI训练时,强制保留仅仅 10% 的人类原始真实数据。
奇迹发生了
仅仅注入了 10% 的人类真实数据锚点,后代模型的性能退化就被极其显著地刹住了,退化程度甚至被压缩到了“轻微级别”!
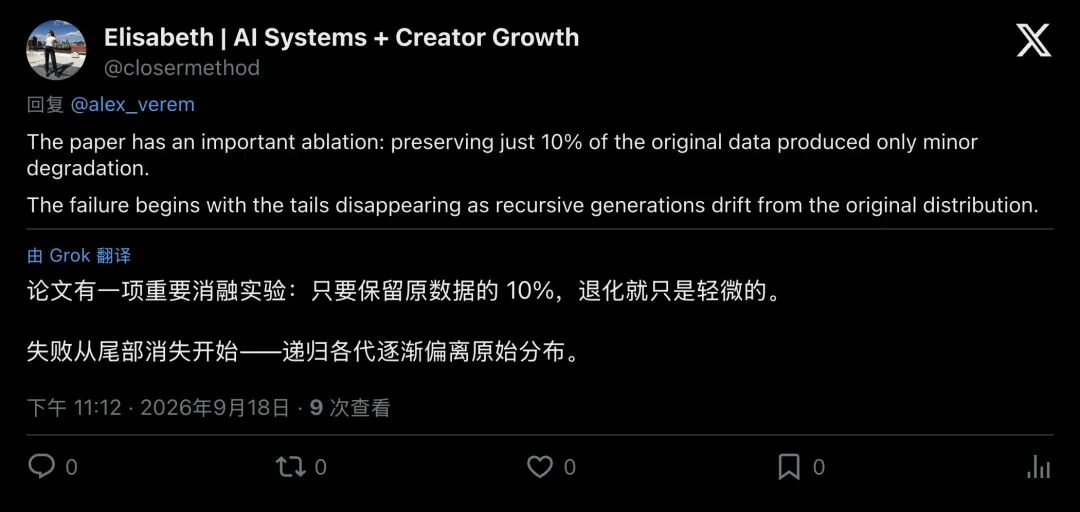
▲ 关键消融结论:保留10%原始数据就能极大程度稳住模型
这项实验表明,人类真实的原始表达,正是对抗AI熵增与精神错乱的“解毒血清”。
与此呼应,斯坦福大学与哈佛大学的研究者(Gerstgrasser 等)在后续顶刊预印本中进一步提出了破解之道:
Nature 揭示的最坏情况,发生在“用AI数据彻底替换旧数据”的极端闭环中;但如果在工程实践中采取“数据累积(Accumulating)”策略,绝不扔掉人类历史上的真实语料,只把经过严格质量过滤、验证的新数据不断追加进去,模型崩溃的宿命就存在数学上的误差上界,并非绝对不可打破。
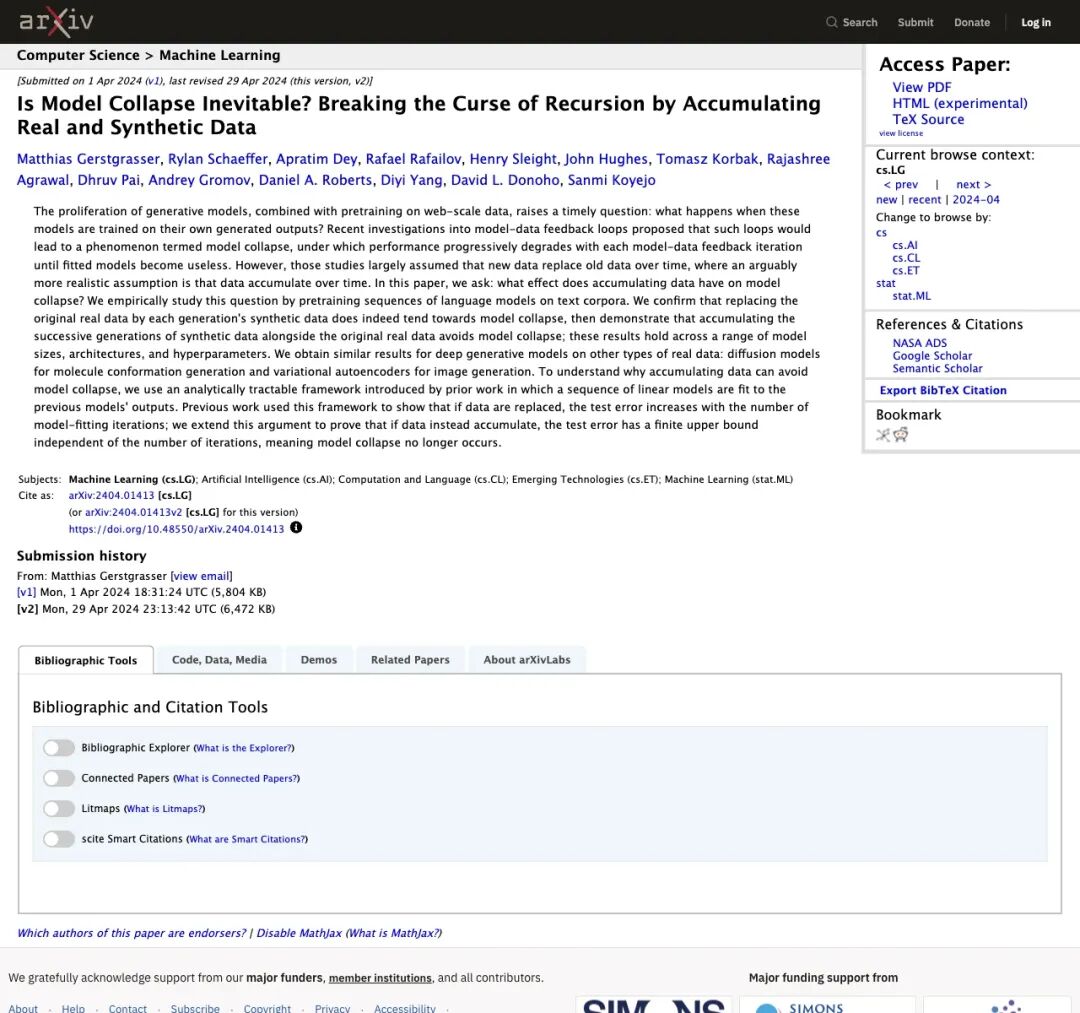
▲ Gerstgrasser等人的研究:通过累积真实与合成数据打破递归诅咒
由此可见,AI并非不能吸收合成数据,但绝不能依赖脱离现实反馈的虚假语料。
它需要携带真实世界物理反馈的外源信号,需要由编译器验证过的代码,需要由人类专家打分清洗过的金标样本,更需要最底层那块坚不可摧的人类语料基石。
终局觉醒:“人类纯血手写文字”正在变成绝版黄金
这项研究在产业界激起的余震,远比几篇学术论文更加现实和商业化。
论文作者在末尾特别提到了一个关键词:先发优势(First-mover Advantage)。
什么叫先发优势?
在2022年ChatGPT问世之前,那些早已将全人类几百年积累的纯净图书、新闻档案、维基百科、论坛精华全部爬取并封存归档的顶级AI实验室,手里握着的,是人类文明史上最后一批未被AI污染的“纯血基因库”。
而今天才入局的后来者,面对的却是一片已经被74%机器排泄物污染的数字沼泽。
这就解释了近年来硅谷发生的一系列魔幻现实:
据《华尔街日报》报道,OpenAI 不惜豪掷 2.5 亿美元,与拥有《华尔街日报》《泰晤士报》的新闻集团(News Corp)签下长达5年的内容版权协议; Reddit、各大百年报刊、学术出版巨头纷纷关闭免费API接口,向AI巨头开出天价语料过路费; 硅谷顶级投资人们开始疯狂扫货各种“人类独占的高质量私有数据集”。
在AI大爆发的第三年,人们蓦然发现:算力可以用钱买,芯片可以加班造,但未被机器玷污过的人类真实文字,正在变成无法再生的稀缺资源。
人类写作者那些看似不完美的笔触、带有情绪的争论、偶尔犯错却灵光乍现的巧思、极度偏门的小众爱好……曾经被算法视作低效的“噪声”,如今却成了保护整个赛博智能不至于脑死亡的唯一锚点。
别再焦虑AI会彻底取代人类的创作。
事实证明:没有人类在前方探索世界的边缘,AI连一座中世纪的教堂都守不住,只会退化成一群在荒原上数着彩虹色野兔的赛博疯子。