ARTICLE · 1068262
Jev来了,软件测试可能要重新定义"AI测试"了
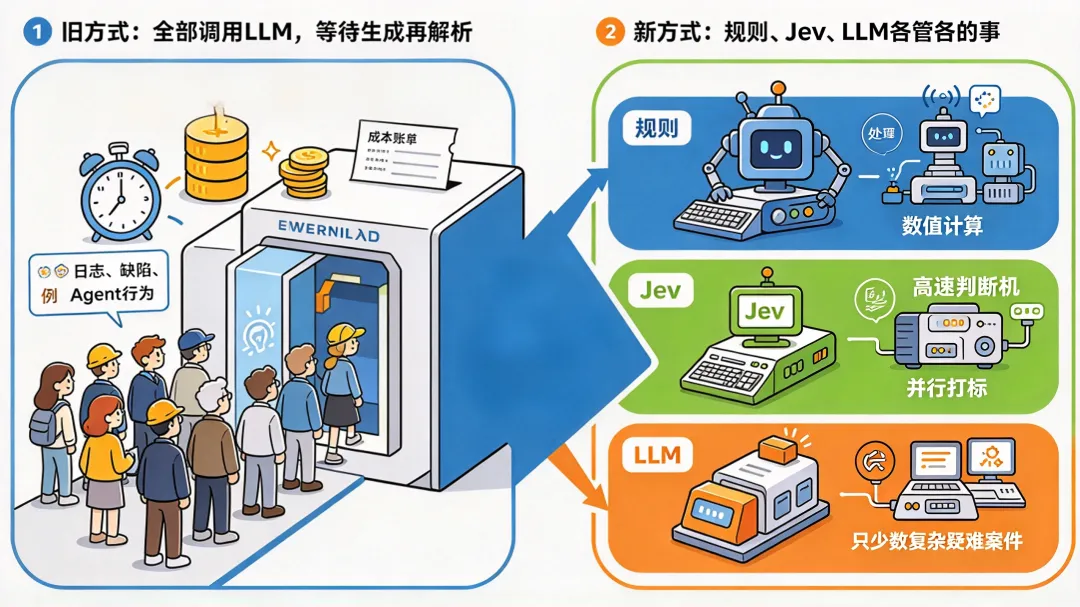
过去两年,测试团队说起"用AI做测试",默认动作往往是同一个:把判断类的活儿——这条日志算不算异常、这个缺陷该定多严重、这批用例哪些值得跑——统统打包成一个提示词,扔给ChatGPT或Claude,等它生成一段带结论的文字,再从里面解析出想要的字段。这套路好用,但代价也很直接:每一次小判断都要等一次生成式模型组织语言,成本和延迟跟着判断次数线性堆起来。TypeSafe在9月15日发布的Jev,给出的不是一个更聪明的模型,而是一个提醒——这个问题本来就不该由一个模型层来扛。
一、Jev在解决什么:把判断从生成里拆出来
Jev被TypeSafe定义为"System One Model":给它一段上下文和几个提前限定好答案类型的问题(选择、打分、真假判断),它并行处理,直接返回结构化结果和对应的置信度,不走"生成一段话再解析"这条路。它上线24小时内被近13%的Vercel AI Gateway付费团队用上,是这个平台历史上采用最快的一次模型发布,但独立评测很快也给出了冷静的一面:在与同价位模型的对比测试里,Jev的完整准确率约64%~65%,并没有拿下第一;它真正碾压的是速度和成本——平均单题响应0.73秒左右,50道题总成本约0.002美元,明显低于测评里的其他模型。
一个真实的生产场景数据更能说明判断类任务的量级:有团队做过一次小规模试用,37段文本各自要过21项检查,Jev一口气返回777个判断结果,总耗时不到0.7秒,估算费用约0.0025美元。如果这777次判断每一次都要调用一次生成式大模型组织语言,成本和延迟根本不是一个数量级。这才是Jev真正想解决的问题:不是让判断更聪明,而是让"这么多本该很快出结果的小判断",不再被绑在生成式模型的响应速度上。
二、三层架构:规则、Jev、LLM,各管各的事
把这个思路铺开,测试系统里的AI能力其实该拆成三层。
确定性规则层负责能被代码算清楚的事——计数、数值运算、日期比较、字符串精确匹配。这类任务本就不该交给任何模型判断,TypeSafe自己在说明Jev局限时也明确把这几项排除在外:模型算概率和语义判断很擅长,但算清楚一笔金额或一个时间差,代码永远比模型稳。
Jev这一层接住的是边界清楚、选项有限、但用规则写不完的语义判断——这条反馈是投诉还是咨询、这次操作看起来是否可疑、两条日志是不是同一类故障。它的价值不是"看得比大模型准",而是能把这类高频小判断的成本和延迟压到可以大批量跑的程度。
LLM层留给真正需要开放式推理和表达的工作——分析一份异常复杂的根因、生成一段可读的测试报告、判断一个从未见过的Agent行为模式是否合理。这层慢、贵,但不可替代,所以只该留给规则和Jev都处理不了的那一小部分。
开发者实际使用Jev时,通常把它放在LLM前后两个位置:任务开始前,用它判断该不该调用更贵的模型、调用哪一个;LLM给出结果后,再用它检查这个结果是否合格、流程该不该继续。这种"前置分流+后置校验"的位置,本身就是三层架构里Jev该待的地方。
三、套进测试流程的四个环节
把这套分层直接映射到测试工作里,此前测试团队常见的做法是不管判断难度,一律走同一条"调用大模型—解析文本"的路径,四个环节的成本和延迟因此被拉到了同一个量级。分层之后,这四个环节该各自落在哪一层,大致是这样:
缺陷严重度判断:涉及"影响了多少用户""耗时多久能修复"这类可以查数据库、算清楚的部分留给规则层;"这段描述听起来像不像阻断性问题"这种语义判断交给Jev式的轻量模型;只有描述模糊、历史上没见过的新型故障,才升级给LLM深入分析。 日志分类:绝大多数日志的分类边界是清楚的(超时、权限、参数错误),适合Jev一次性批量打标;只有聚类之后依然无法归类的长尾异常,才值得叫醒LLM去读上下文做推理。 用例是否值得执行:判断一条用例和历史用例是否高度重合、优先级该打几分,是典型的Jev任务;但要不要为一个新特性重新设计一整套用例,仍然需要LLM或人来想。 Agent行为是否异常:Jev可以先做第一轮快速标记——这一步工具调用是否偏离了预期模式,命中率高、成本低;一旦被标记为可疑,再由LLM去还原完整轨迹、判断这究竟是正常的探索路径还是真正的问题。
四、"AI测试"要测的东西也跟着变了
如果判断被拆成了三层,测试团队的工作重心也得跟着挪。过去测的是"这一次大模型判断对了没有",现在要测的是三件新事情:规则层和Jev层之间的分界线画得对不对——哪些判断被错误地留在了规则层里(算不清楚却硬用规则堆条件),哪些又该从Jev层升级但被漏判了;Jev层给出的置信度阈值是不是真的可信,而不是照抄一个"0.9就自动放行"的默认值;升级到LLM层的触发条件够不够灵敏,会不会把该升级的疑难案例挡在了便宜层里,一直没被人发现。
下面是一个简化的路由骨架,展示三层分工如何落地成代码,也标出了测试该盯住的三个位置:
def classify_defect(defect):# 规则层:能算清楚的,不进模型if defect.affected_users is not None and defect.affected_users > 10000:return "P0", "rule" # 测试点①:规则边界是否覆盖了所有该硬判的情况# Jev层:语义判断 + 置信度result = jev_judge(defect.description, question_type="severity_score")if result.confidence >= 0.85:return result.label, "jev" # 测试点②:0.85这个阈值是否用校准曲线验证过# LLM层:兜底的复杂推理return llm_analyze(defect), "llm" # 测试点③:升级条件是否漏掉了疑难案例
这三个测试点不是三次独立的抽查,而是一条完整链路:测试点①漏判的用例,会原样流入测试点②的样本池;测试点②阈值偏高,又会把本该升级的疑难案例悄悄挡在Jev层。所以验证顺序也该反过来走——先从最终没有被人工复核过、却长期"自动通过"的那批结果里抽样倒查,看它们本该停在哪一层;再回头检查每一层的分界线,而不是只在系统上线前测一次三层各自的独立准确率。
结尾
Jev没有重新定义"更聪明的AI",但它逼着测试团队重新想清楚一件事:AI测试从来不是"选一个模型来判断",而是"给每一类判断找到成本和可靠性都匹配的位置"。规则层管确定性,Jev层管高频的小判断,LLM层管开放式推理——测试的对象,也从"这次答对了吗"变成了"这三层之间的边界画得对不对"。等这道边界成为测试用例设计里明确要覆盖的一部分,"AI测试"这四个字才算真正被重新定义过。