ARTICLE · 1068900
AI 技术面试题・Agent 篇(二)|工具调用、任务规划、多智能体高频 10 问
AI 技术面试题・Agent 篇(二)|工具调用、任务规划、多智能体高频 10 问上周发布 Agent 面试第一辑之后,不少同学反馈:面试深挖不再只考基础定义,面试官更爱追问工具调用、任务规划、多智能体协作这类工程落地问题。只会背概念,遇到闭环流程、异常处理类问题,很容易直接卡壳。 Agent 面试第二辑来了!10 道高频真题,覆盖「LLM 应用对比|记忆|工具调用|任务规划|ReAct|多智能体」,从原理到工程实践,面试常问连环考点一次性整理。建议收藏,面试前快速复盘。
考察点:能不能抓住自主性与闭环能力的本质,不只是简单罗列表面差异。 高分答案:传统 LLM 应用以被动问答为主,用户输入 prompt,模型一次性输出文本,没有自主循环决策;Agent 拥有感知 - 思考 - 行动 - 反馈闭环,能够自主拆解目标、调用外部工具、迭代修正,直到完成任务。 传统 LLM 应用:依赖模型静态知识,只做内容生成,无法主动执行外部操作,指令模糊时容易输出幻觉; Agent:目标导向,可借助搜索、代码、数据库等外部能力突破模型知识边界,支持长任务持续迭代,具备自主纠错能力。 💡一句话总结:传统 LLM 是回答问题,Agent 是主动完成目标任务。
考察点:区分不同层级记忆的作用、存储介质与适用场景,理解记忆在 Agent 闭环里的价值。 高分答案:Agent 记忆分为瞬时记忆、短期记忆、长期记忆三层,各司其职共同支撑连续任务: 瞬时记忆(上下文窗口):大模型单次推理窗口,读写最快,精度最高,但容量受限,窗口溢出信息丢失,支撑单次思考; 短期记忆(会话记忆):内存缓存,保存当前任务中间状态、工具调用记录,会话结束清空,保证单次任务连贯性; 长期记忆:向量库 / 数据库持久化存储,可无限扩容,存放历史任务、用户偏好、领域知识,依靠检索读取,速度慢,用来复用历史经验。 💡一句话总结:瞬时记忆供推理,短期记忆保会话,长期记忆存经验。
考察点:讲清楚完整闭环,区分模型推理环节和后端执行调度环节。 高分答案:工具调用是 Agent 把思考转化为外部动作的核心能力,完整流程分为 5 步: 💡一句话总结:模型决定调用哪个工具,调度层执行,结果回传再思考。
考察点:从工程落地视角,不是只列举工具,而是从可用性、安全、可观测性多角度阐述。 高分答案:工具系统设计目标:可调用、低错误、可扩展、可管控,核心考虑 6 个因素: 💡一句话总结:工具系统不只是写接口,还要管好选择、权限、异常与日志。
考察点:工程落地能力,区分不同失败类型,给出分层处理策略,不是只写重试。 高分答案:第一步先定位失败类型:参数错误、网络超时、权限不足、返回无效数据等,再分层处理: 💡一句话总结:临时故障重试,推理错误自修正,不可用则降级并反馈用户。 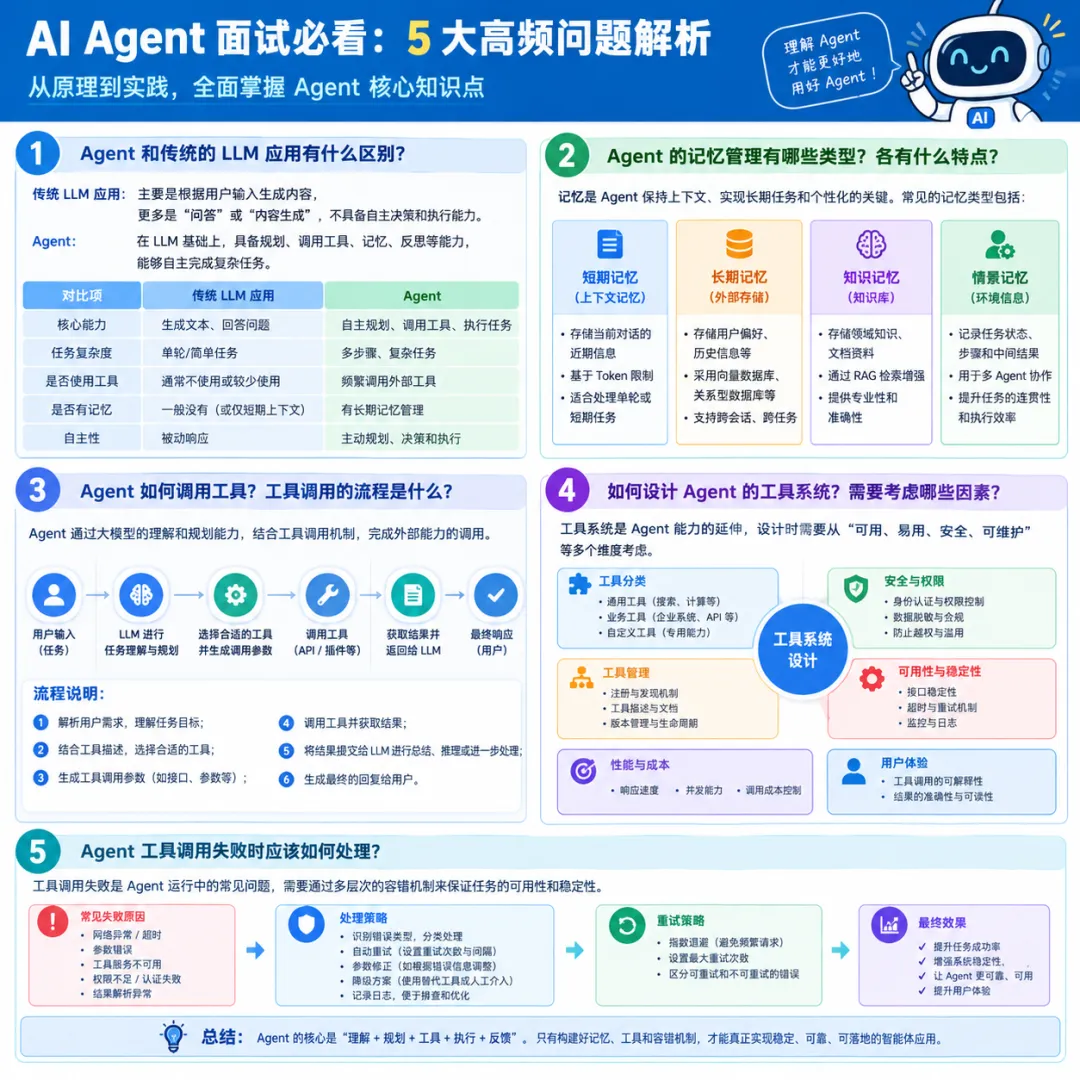
考察点:理解规划的本质是任务拆解,区分 LLM 原生规划与传统搜索规划算法。 高分答案:任务规划的本质,是把高层模糊目标拆解成有序的可执行原子子任务。流程:目标解析 → 任务拆解 → 子任务排序 → 工具匹配 → 分步执行 → 动态校验调整。 主流规划思路 / 算法: 递进式拆解:自上而下拆分任务,落地最简单,通用场景首选; BFS 广度优先:遍历所有可行路径,适合多分支任务,偏向寻找全局解; DFS 深度优先:单路径持续执行,适合线性流程任务; A * 启发式规划:基于代价函数优先选择最优路径; 动态规划:根据执行反馈实时修改任务计划,适配不确定场景。 💡一句话总结:规划就是拆任务排顺序,简单任务靠 LLM 拆解,复杂任务可融合传统搜索算法。
考察点:能给出量化评估维度,并且定位规划失败根因,给出可落地优化方案。 高分答案:评估规划质量 4 个维度: 规划失败改进方案: 💡一句话总结:看规划全不全、顺不顺、稳不稳;出问题就拆细、加校验、动态调整。
考察点:理解 ReAct 核心循环,区分它和纯 CoT 的差异,抓住 Thought-Action-Observation 闭环。 高分答案:ReAct(Reason + Act)是 Agent 最经典基础框架,核心是推理和行动交替循环。 闭环三步: 💡一句话总结:ReAct 就是「想一想,动手做,看结果,再继续」。
考察点:横向对比三者定位,抓住「能不能执行外部动作」这个核心分界线。 高分答案:三者都是增强大模型推理能力的技术,但能力边界不一样: CoT(思维链):纯文本分步推理,没有外部行动,只能依赖模型内部知识,无法调用工具; Self-Ask(自提问):模型主动提出子问题来补全信息,偏向自问自答,早期版本外部执行能力弱; ReAct:融合分步推理与外部动作,支持工具调用,有观测反馈闭环,适合 Agent 复杂任务。 💡一句话总结:CoT 只会想,Self-Ask 会自问,ReAct 能思考还能动手执行。
考察点:理解多 Agent 是团队分工,不是多个 Agent 简单叠加,能讲清楚不同架构适用场景。 高分答案:Multi-Agent 多智能体系统,是多个具备独立能力的 Agent 组成协作团队,每个 Agent 有不同职责,通过通信配合,完成单个 Agent 难以处理的复杂长链路任务。 四大经典协作架构: 💡一句话总结:单 Agent 是单人干活,Multi-Agent 是分工协作的 AI 团队。 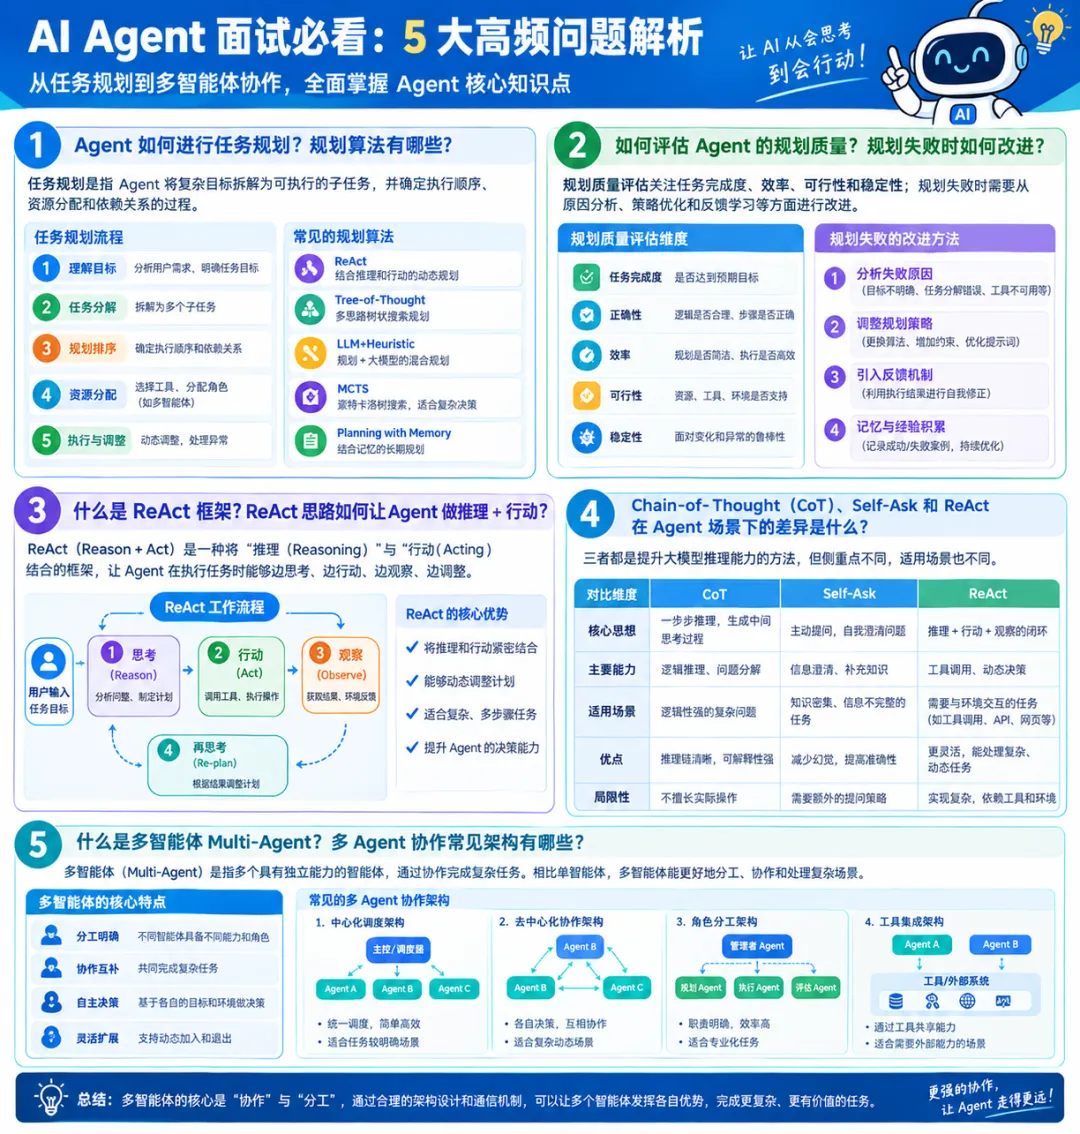
第一辑讲基础概念,第二辑深入工程落地。面试中 Agent 相关问题经常连环追问:问完定义问工具调用,问完工具问规划,再追问多智能体。 吃透这两辑,基本覆盖 Agent 岗位面试 80% 以上的基础 + 工程面试题。 下一期,准备更新 Agent 高阶面试题:Agent 幻觉、反思机制、评估指标、落地踩坑,欢迎持续关注。
承接第一辑 Agent 面试题,延续同款「考察点 + 高分答案 + 一句话总结」卡片式结构,开篇文案衔接上篇
01 Agent 和传统的 LLM 应用有什么区别?
02 Agent 的记忆管理有哪些类型?各有什么特点?
03 Agent 如何调用工具?工具调用的流程是什么?
需求解析:Agent 判断当前信息是否足够,确定是否需要调用工具; 参数生成:模型按照约定格式输出工具名称、入参; 执行动作:调度层解析指令,调用外部 API、搜索、代码解释器; 获取观测:拿到工具返回结果、报错信息; 迭代推理:把结果放回上下文,重新判断任务是否完成,不足则继续调用工具。
04 如何设计 Agent 的工具系统?需要考虑哪些因素?
能力边界:明确每个工具适用场景,避免功能重叠; 工具描述与参数:描述清晰无歧义,精简参数,必填项明确,降低模型错选概率; 调度策略:设置调用优先级,区分串行 / 并行调用,避免重复调用; 容错能力:提前处理超时、空返回、非法参数等异常; 安全权限:区分只读 / 高危操作,增加调用限流、敏感操作二次确认; 可观测性:完整记录调用日志、成功率、耗时,方便后续优化。
05 Agent 工具调用失败时应该如何处理?
瞬时异常(网络波动):有限次数重试,加入退避策略,禁止无限重试; 参数 / 格式错误:Agent 复盘报错信息,自动修正参数重新调用; 工具不可用:自动切换备用工具,或降级输出基础结果; 核心工具完全失效:停止无效调用,向用户说明卡点,支持人工调整任务; 留存日志:保存失败上下文,用于优化工具描述,从根源降低错误率。
06 Agent 如何进行任务规划?规划算法有哪些?
07 如何评估 Agent 的规划质量?规划失败时如何改进?
完整性:子任务能否完整覆盖用户目标,无遗漏; 逻辑合理性:任务顺序符合业务逻辑,无颠倒冗余; 高效性:粒度合适,减少多余工具调用; 鲁棒性:信息轻微缺失时不会直接崩溃。
细化拆解粒度,大任务拆成更小原子任务; 优化规划提示词,增加约束与校验规则; 增加预校验,执行前检查规划方案是否合理; 每完成子任务校验进度,实时重规划; 复杂场景引入传统规划算法,降低纯 LLM 推理不稳定问题。
08 什么是 ReAct 框架?ReAct 思路如何让 Agent 做推理 + 行动?
Thought(思考):基于当前信息判断信息是否充足,决定下一步动作; Action(行动):调用工具或者执行操作; Observation(观测):接收工具返回的真实结果; 循环往复,直到任务完成。 它让模型不再只在文本空间空想,能够基于外部真实反馈持续推理。
09 Chain-of-Thought(CoT)、Self-Ask 和 ReAct 在 Agent 场景下的差异是什么?
10 什么是多智能体 Multi-Agent?多 Agent 协作常见架构有哪些?
流水线串行架构:按流程依次执行,上一个输出作为下一个输入,适合标准化流程; 主管 - Worker 主从架构:主管负责任务拆解分配,多个 worker 执行子任务,业务最常用; 并行投票架构:多个 Agent 并行执行同一任务,结果投票择优,适合高校验场景; 对等自治架构:无中心调度,Agent 之间协商分配任务,科研场景居多,落地难度高。