ARTICLE · 1083700
谷歌AI新帅掀桌:Gemini 4提前杀到!直接跳过3.5,未满月就扔上战场
在大模型的世界里,最残酷的处境莫过于:你在暗处埋头打磨一把自以为天下第一的宝剑,猛然抬头,对手已经换上了冲锋枪。
这一次,巨头谷歌决定彻底掀翻桌子
2026年9月下旬,旧金山,The Information 主办的 AI Agenda Live 峰会现场。聚光灯打在了一个许多人还不太熟悉的面孔上,Google DeepMind 新任掌舵人 Koray Kavukcuoglu。
这是他接替哈萨比斯(Demis Hassabis)执掌日常大权后的首次公开亮相。台下的科技记者和投资人原本以为,这会是一场充斥着公关辞令的“例行画饼”。
但 Koray 开口的第一段话,瞬间让全场陷入了震撼。
谷歌下一代终极旗舰,Gemini 4,已经悄然完成预训练,正式进入早期后训练(post-training)阶段。伴随而来的,是谷歌一个让所有人始料未及的战略决断:
不再等它变成一个完美无缺的完全体。谷歌打算以最快速度把“早期后训练版本”直接扔向市场,然后顶着狂风暴雨高速迭代。
时间表被死死钉在:“远早于年底”
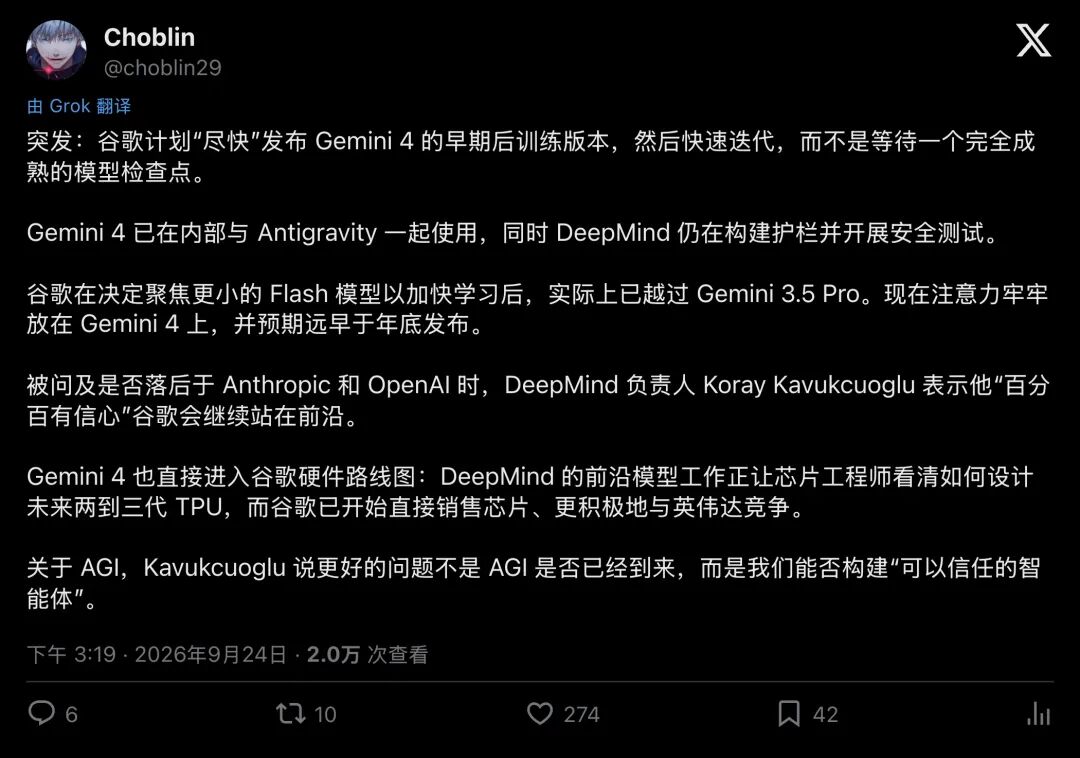
▲ 社区爆料长帖迅速刷屏:谷歌决定放弃漫长等待,Gemini 4 即将提早出货
原本被寄予厚望的过渡旗舰 Gemini 3.5 Pro 被实质性跳过。谷歌放弃了慢条斯理憋大招的传统做派,要把一台引擎还在轰鸣、零件还在微调的超级战争机器,直接开进战壕。
全球大模型竞争的底层逻辑,在这个秋天被彻底改写。
01撕掉“学院派”伪装:把还没满月的猛兽放出来
要看懂谷歌这步棋有多激进,我们得先拆解一个大模型研发的常识。
如果把训练一个 AI 巨兽比作培养顶级特工,整个过程大致分为两步:
第一步叫预训练(Pre-training)。这就像把一个天才关在世界最大的图书馆里,没日没夜地读完上百亿本书、论文、代码和视频。这个过程极其耗费算力和时间,最终产出的模型拥有极其庞大的知识基座,但它还是个“愣头青”,不会听指令,容易胡说八道,也不懂商业软件的规矩。
第二步叫后训练(Post-training)。这相当于把读完书的天才送进特训营,进行长达数月的强化训练、对齐人类偏好、安装安全护栏、训练调用工具和编写复杂代码。
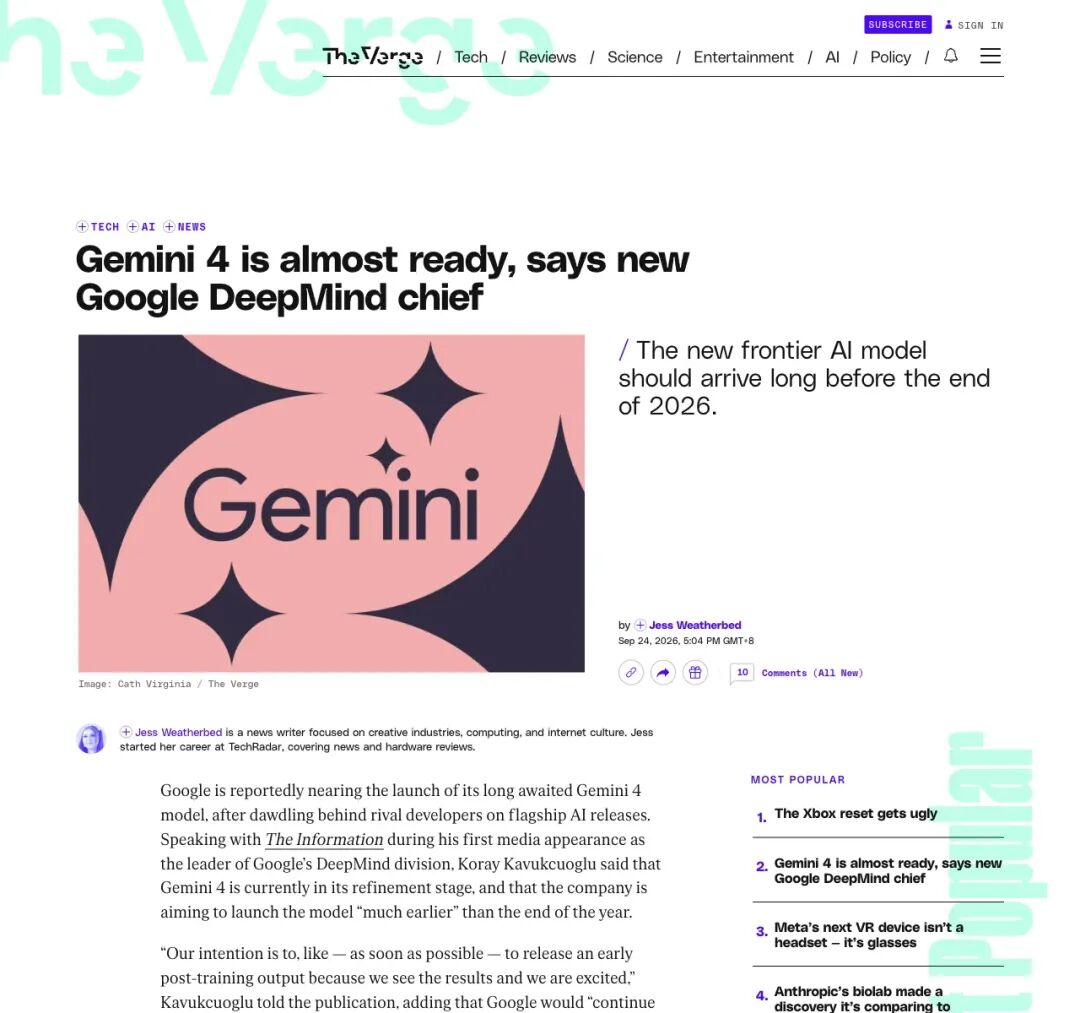
▲ The Verge 报道:Google DeepMind 新帅确认 Gemini 4 早期版本已就绪
在传统的工业发布流程里,模型实验室通常会不断保存快照,这在术语里叫“检查点(Checkpoint)”。他们会挑选一个跑分最高、最安全、最成熟的终极检查点,包装成华丽的产品,再开一场盛大的发布会。
但这一次,谷歌等不及了
Koray 在台上明确表态:Gemini 4 在早期后训练中展现出的能力已经令人极其兴奋,谷歌决定不等最终的“完美检查点”,只要早期版本达到可用门槛,立刻放出来给外部体验,靠后续的高频更新去逐步补全能力。
为什么要冒这个险?
因为过去的教训太痛了今年早些时候,谷歌曾预告 Gemini 3.5 Pro 将在初夏缩小与对手的差距。然而在漫长而谨慎的合作伙伴测试中,时间窗口被一点点吞噬。与此同时,竞争对手的炮火几乎从未停歇,Anthropic 的 Opus 5.5 步步紧逼,OpenAI 的 GPT-6 系列不断压低成本与延迟。
继续在实验室里精雕细琢,等于把阵地拱手让人。
谷歌在过去半年里,靠着轻巧敏捷的 Flash 系列模型尝到了高频快跑的甜头。如今谷歌高层转变了思路:深闺里打磨的“完美神童”可能一出世就过时,他们索性把充满潜力的“年轻战士”直接送上擂台,在实战的泥泞中以战养战。
02秘密练兵场:它已经在内部操控代码了
很多人会问:一个“早期后训练版本”,真的能打吗?
答案其实藏在谷歌内部的一款核心工具里,Antigravity。
这是 DeepMind 和谷歌为下一代“智能体编程(Agent-First Coding)”打造的秘密武器。这个工具跳出了传统代码补全插件的局限,演变成一个可以自己思考、打开终端编译、在浏览器里截屏测试、并在发现 Bug 时主动向人类程序员汇报方案的“数字工程师”。
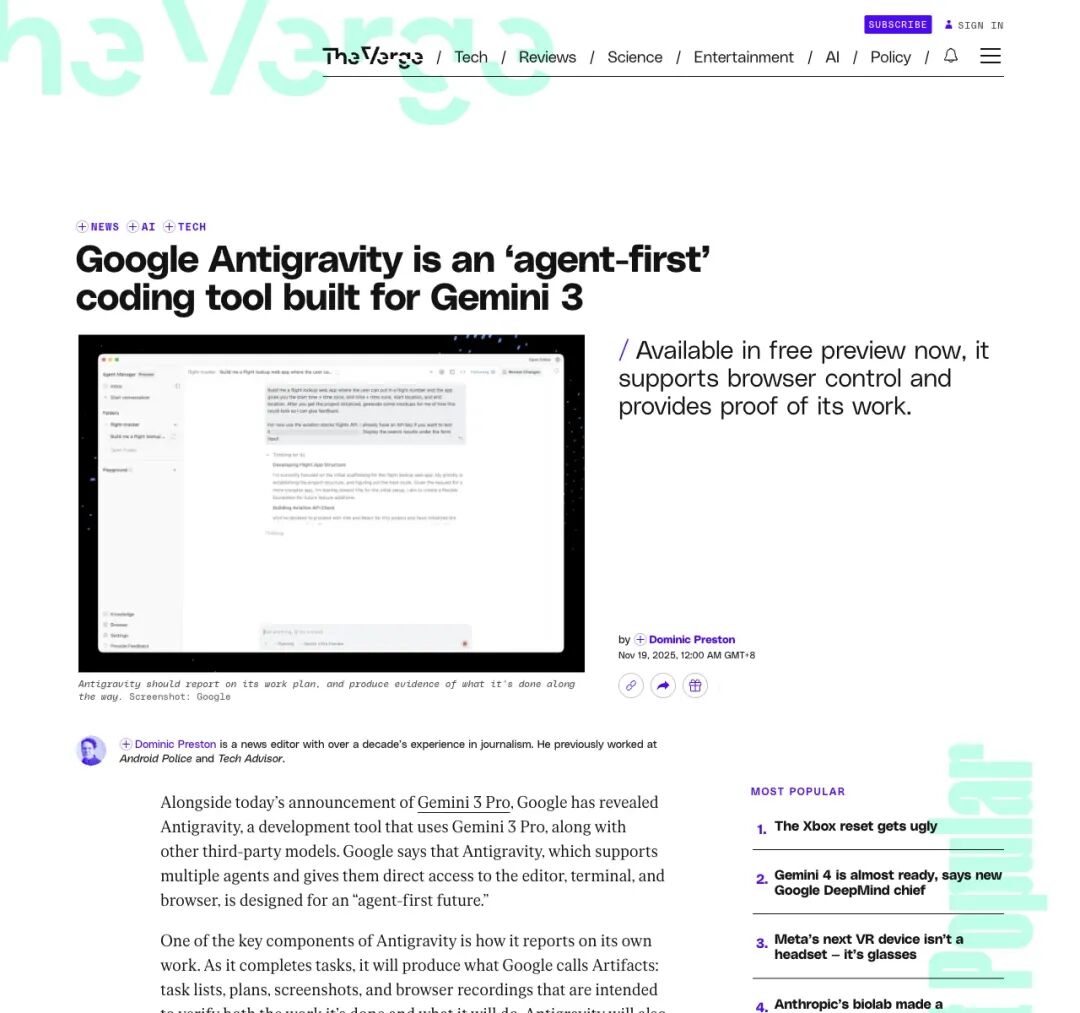
▲ 谷歌内部的智能体编程平台 Antigravity:代码世界的全自动战机
公开报道显示,Gemini 4 的早期检查点,早已经接入了 Antigravity,成为谷歌顶级工程师们的日常生产力引擎。
这就是谷歌敢于“早发”的底气所在
当外界还在猜测参数量和上下文长度时,谷歌自家的上万名工程师已经在用最刁钻、最复杂的真实代码任务,给 Gemini 4 进行极限压力测试。它每一次在内部写崩的代码、每一次被工程师纠正的逻辑漏洞,都在实时转化为后训练的修正数据。
因此,当普通用户在未来几个月接触到它时,它虽然顶着“早期版本”的名号,但骨子里早已在谷歌严苛的代码熔炉里淬炼过一轮。
03灵魂变轨:不再谈虚无的 AGI,只要能干活的“可信打工人”
这次换帅与战略转向,背后还隐藏着 DeepMind 组织文化的剧烈震荡。
过去十年,由哈萨比斯执掌的 DeepMind 一直带着浓厚的学术理想主义色彩。“实现通用人工智能(AGI)”是写在他们墙上的神圣信条。他们像是一群探索宇宙终极奥秘的物理学家,追求的是理论上的完美与神迹。
但新上任的 Koray,身上散发着极其凌厉的工程师与产品经理气质。
在峰会现场,当被问及“人类距离 AGI 还有多远”时,Koray 给出了明确的回答:
“比起探究 AGI 算不算到来,大家更该关注我们能否造出人类可以托付信任的智能体(Intelligent agents that we can trust)。”
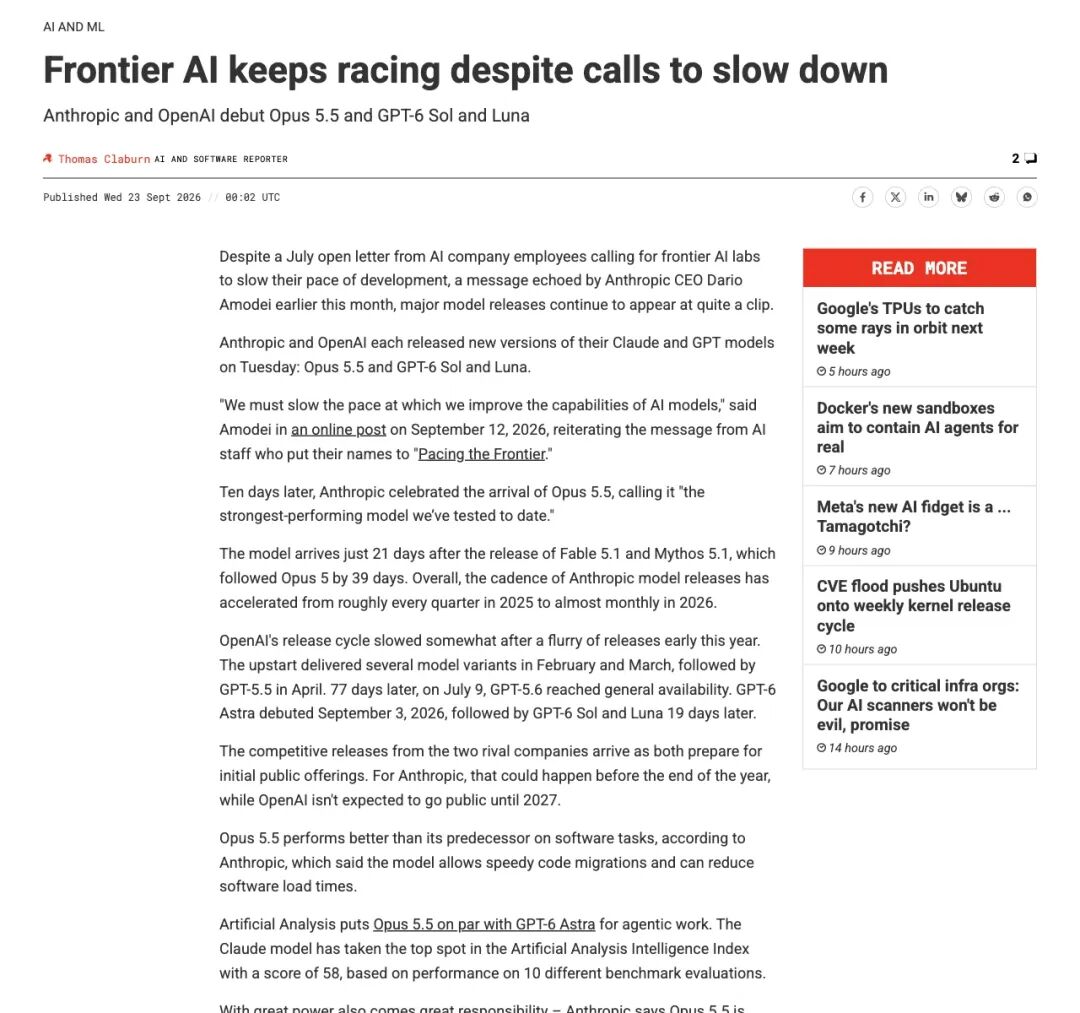
▲ The Register:尽管学界呼吁放慢脚步,但工业界的军备竞赛正在无限加速
这句话,标志着 DeepMind 战略重心的彻底迁移。
从“造神”,变成了“造可信工具”
与软件加速并行的,是 Gemini 4 对谷歌底层硬件的直接反哺。Koray 透露,前沿模型的超大规模训练正在给谷歌芯片团队提供极高的能见度,直接指导着未来两到三代 TPU(张量处理器)的架构设计。
在英伟达 GPU 牢牢钳制算力市场的今天,谷歌正变得越来越激进,他们开始把自研的 TPU 直接卖给外部企业。模型迭代越快,硬件短板暴露得越早;硬件迭代越稳,模型训练的成本就越低。
这种“模型-工具-芯片”的三位一体闭环,才是谷歌敢于正面硬刚任何对手的底牌。面对“谷歌是否正在掉队”的质疑,Koray 斩钉截铁地扔下一句:“我百分之百确信,谷歌会始终留在最前沿。”
04繁荣下的阴影:实验室的狂欢,开发者的噩梦
然而,技术巨头的快意恩仇,落到普通开发者头上,往往就是一场无妄之灾。
根据行业监测机构 Mungomash 的统计,在过去整整一年里,全球前沿 AI 厂商一共发布了上百个大小模型。各家的发版节奏从按年、按季度,被硬生生压缩到了按月、甚至按周。
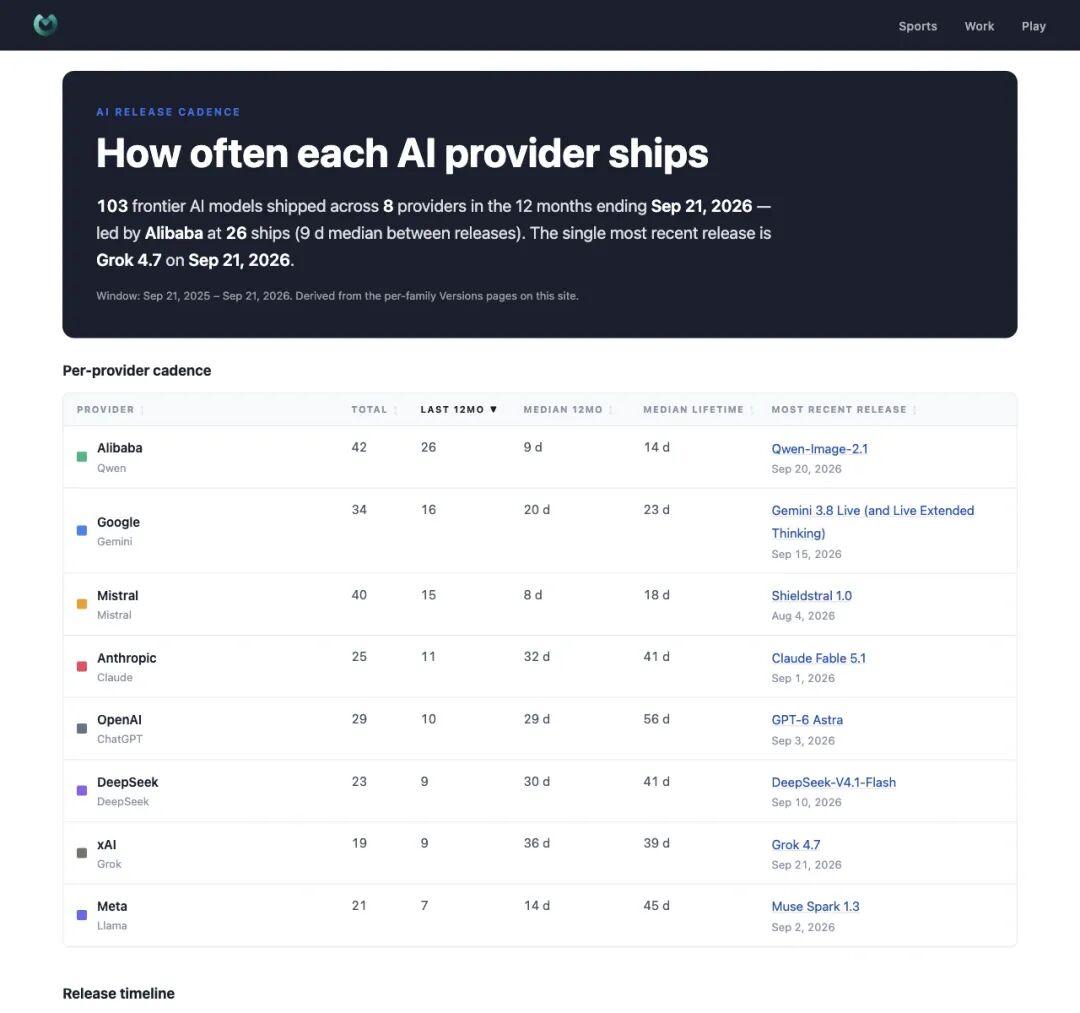
▲ 数据显示:大模型发版中位间隔已被压缩到数十天以内,软件化持续交付已成定局
大模型告别了“几年磨一剑”的经典软件形态,彻底化作一条永远在变动、永远在热更新的流水线。
这种“先发布、再迭代”的策略,在工程师社区引发了极大的焦虑。
独立开发者 Offscript 在社交媒体上一针见血地指出了这场狂欢背后的代价:
“早发并快速迭代,对实验室获取数据来说棒极了;但对于在上面构建业务的人来说,简直是折磨。每一次悄无声息的检查点替换,都是一次你在生产环境中自己去发现的性能倒退,而且连一份更新日志(changelog)都没有。”
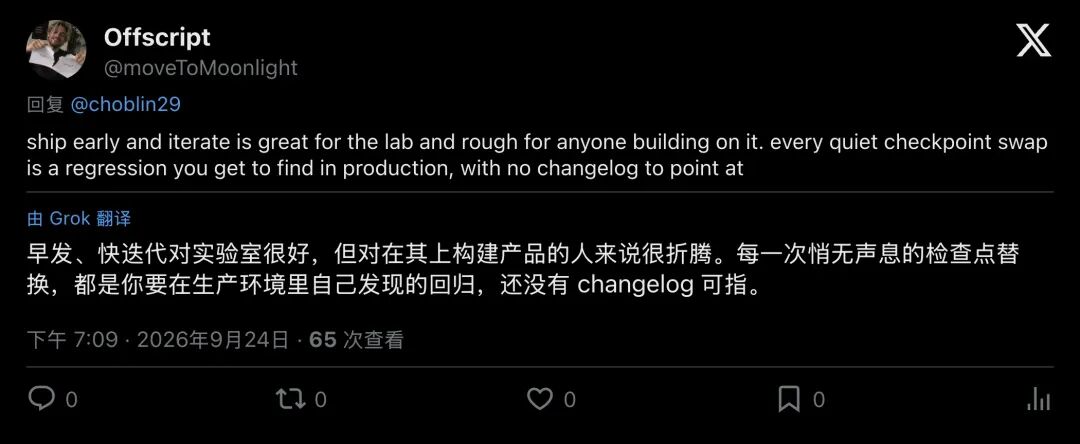
▲ 资深开发者的犀利吐槽:每一次静默更换模型检查点,都可能给生产环境带来未知的系统隐患
想象一下:你的公司基于今天的 API 写好了精准的业务提示词(Prompt),系统运转良好。下周一上班,模型后台悄悄更新了一个新的检查点,原本听话的 AI 突然开始在某个特定格式上犯错,原本调通的业务流程莫名崩溃。
提示词漂移、行为回退、缺乏确定性的版本管理……这是每一个想要把 AI 接入严肃生产环境的企业必须吞下的苦果。
当模型变成“活的服务”,用户就必须学会与不确定性共舞。
05终局推演:活着,就是不断发布
硅谷没有神话,只有残酷的进化论
回顾大模型这几年的狂飙突进,你会发现一个清晰的演进轨迹:
第一阶段,大家比拼谁能点燃“智能的火花”,比的是谁的模型参数更大、基准分数更高;第二阶段,大家比拼谁的生态更繁荣、谁的调用成本更低;而现在,我们正式进入了第三阶段,比拼反馈回路的周转速度。
谁能把尚未完美的模型最先推到真实用户的指尖,谁就能最先收集到海量的失败边缘案例(Edge Cases),谁就能用这些带血的数据在最短时间内完成新一轮对齐,并在下一次检查点替换中建立壁垒。
谷歌放弃 Gemini 3.5 Pro,选择带着尚未完美的 Gemini 4 提枪上阵,原因很简单:在残酷的战场上,停在原地擦拭铠甲的人,往往死得最早。
远早于年底大幕已经拉开,一场没有喘息机会的肉搏战,才刚刚开始。