ARTICLE · 1084266
【原创工具】—— 小红书笔记/视频批量下载工具(Go 实现)—— 已开源,附地址
小红书笔记/视频批量下载工具(Go 实现)
一个用 Go + go-rod(Chrome DevTools Protocol) 实现的小红书内容下载命令行工具:
✅ 批量下载指定账号的全部笔记和视频(自动翻页,不受接口分页限制)
✅ 通过笔记/视频链接下载(支持完整链接、
xhslink.com短链、App 分享文案整段粘贴、裸笔记 ID)✅ Web 图形控制台(
xhs-dl web):页面解析账号笔记列表、勾选多选下载、批量链接下载、实时进度条✅ 图文笔记保存为 Markdown(.md) + 按顺序命名的图片
✅ 视频笔记保存 mp4 + 同名 Markdown,自动选择最佳清晰度(h264 优先,兼容性好)
✅ 并发下载、失败重试、备用地址回退、断点续传(已下载自动跳过)
✅ 登录状态持久化,扫码登录一次即可长期使用
开源地址
项目源码已开源,开源地址
https://gitee.com/hnxyy/xhs-downloader软件下载
通过网盘分享的文件:xhs-dl.zip链接: https://pan.baidu.com/s/1vJx55MSO3P6x--9KLE2pyw?pwd=xas8提取码: xas8 复制这段内容后打开百度网盘手机App,操作更方便哦
或者通过gitee地址
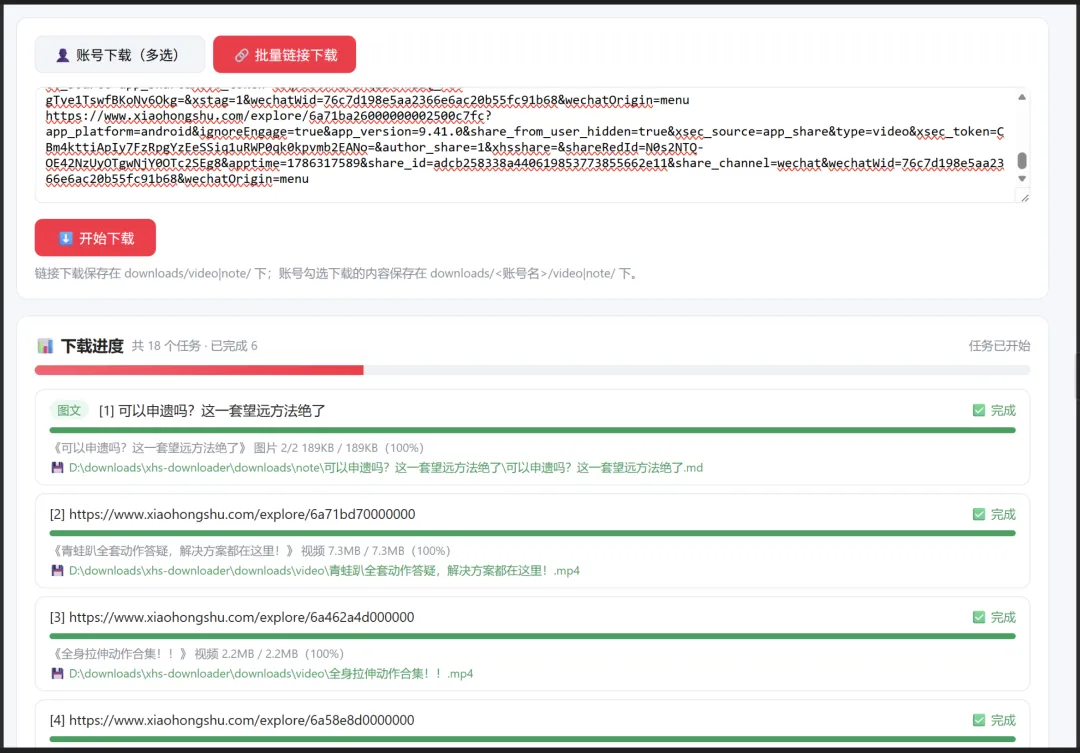
https://gitee.com/hnxyy/xhs-downloader/tree/master/realease使用截图
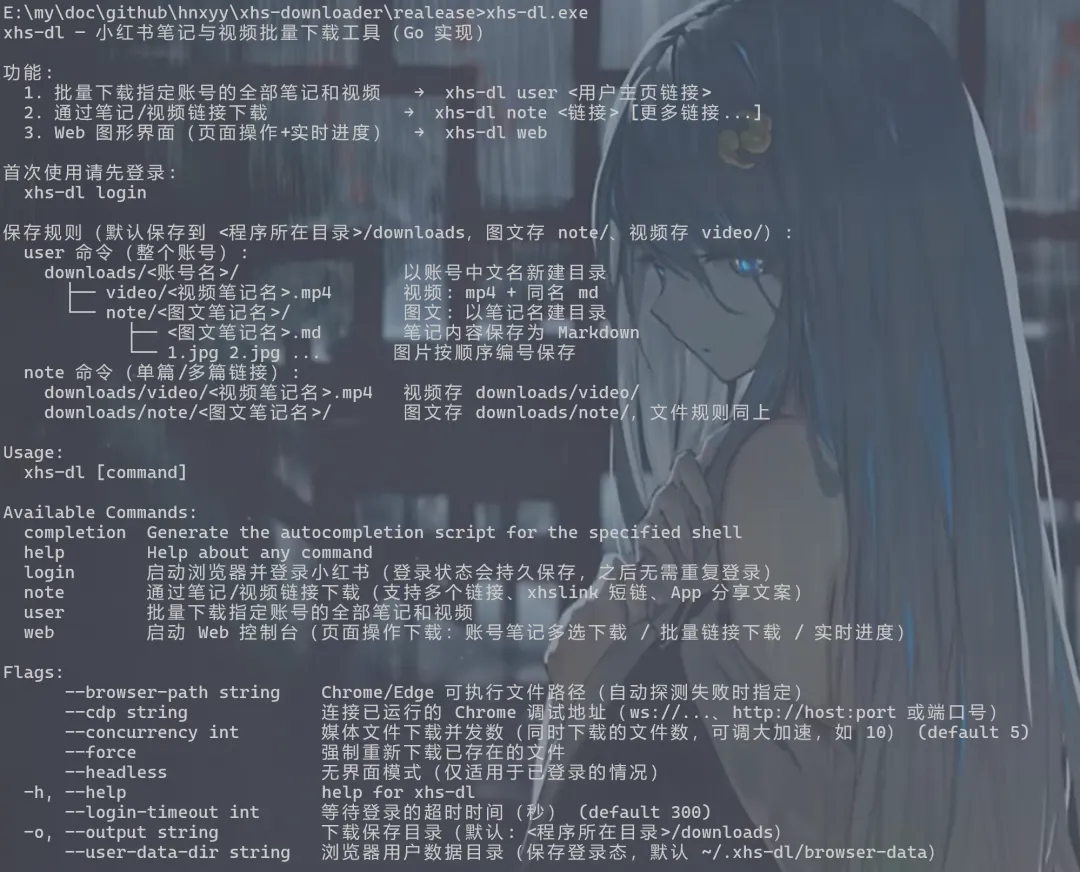
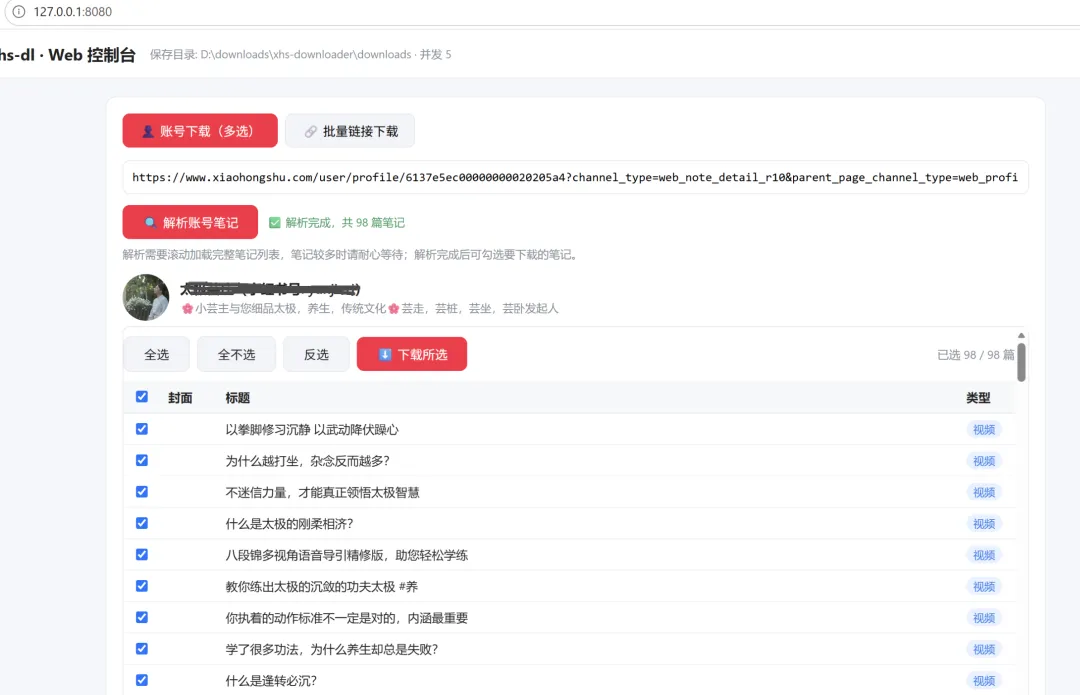
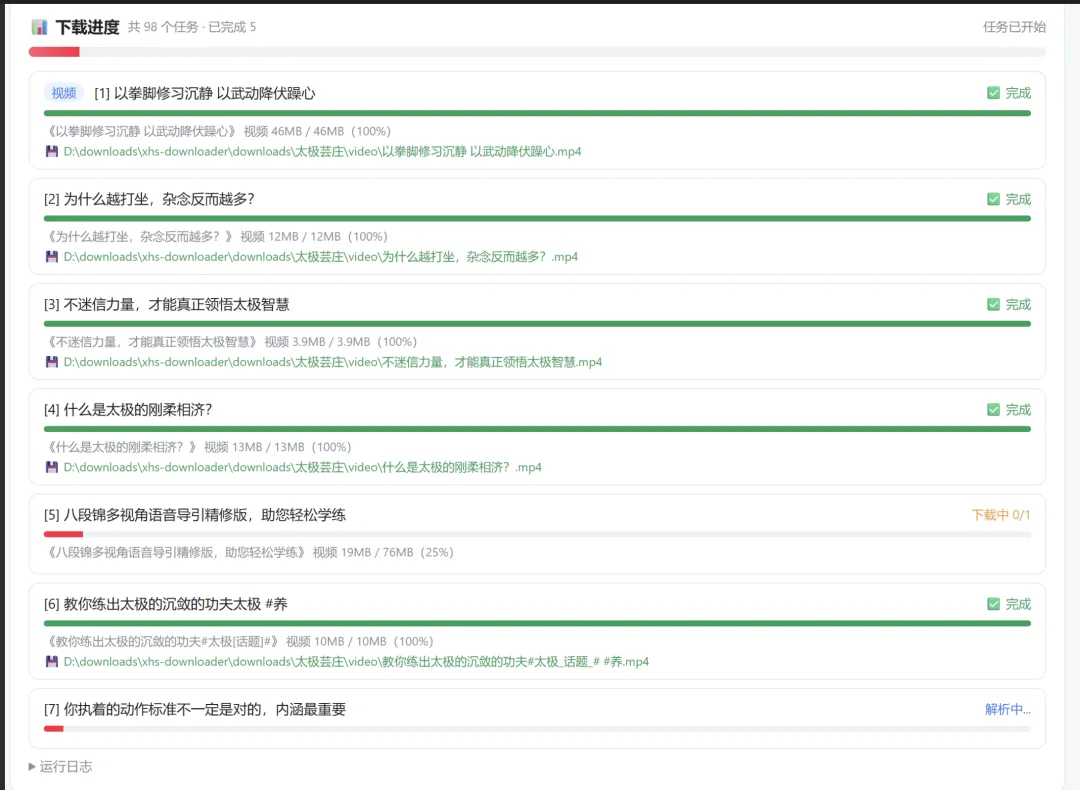
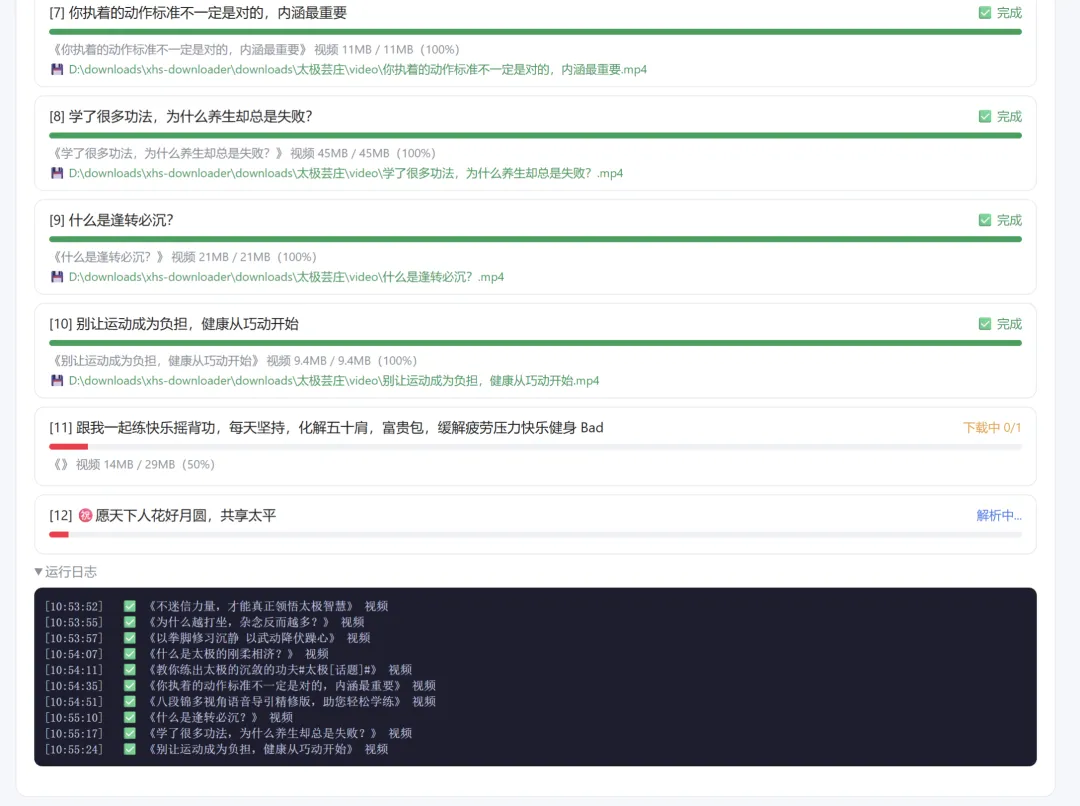
一、保存结构
所有下载内容默认保存到 项目目录下的 downloads/ 目录(即 <程序所在目录>/downloads,可用 -o 修改)。统一规则:视频存 video/ 文件夹(mp4 + 同名 md),图文存 note/ 文件夹(笔记名目录 + md + 编号图片)。
1.1 user 命令(下载整个账号)
在 downloads/ 下以账号中文名(昵称)新建目录,目录内按类型分两个子文件夹:video/ 存放全部视频,note/ 存放全部图文笔记:
downloads/└── 瑜见晚风/ # 账号目录(账号中文名) ├── video/ # 全部视频 │ ├── 一个视频笔记的标题.mp4 # 视频文件 │ ├── 一个视频笔记的标题.md # 视频笔记同样保存 Markdown(标题/正文/数据/视频引用) │ └── .一个视频笔记的标题.noteid # 隐藏标记文件(断点续传用,勿删) └── note/ # 全部图文笔记 ├── 一个图文笔记的标题/ # 以笔记名新建目录 │ ├── 一个图文笔记的标题.md # 笔记内容保存为 Markdown │ ├── 1.jpg # 图片按顺序编号(1、2、3...,扩展名按实际格式) │ ├── 2.jpg │ └── 3.webp └── 同名笔记_xh3k9d2a/ # 同名笔记自动追加短 ID 后缀避免覆盖
1.2 note 命令 / Web 控制台链接下载(按链接下载单篇或多篇)
直接保存在 downloads/ 下(不建账号目录),同样按类型分 video/ 和 note/:
downloads/├── video/ # 全部视频│ ├── 视频笔记的标题.mp4 # 视频文件│ └── 视频笔记的标题.md # 同名 md(标题/正文/数据/视频引用)└── note/ # 全部图文笔记 └── 图文笔记的标题/ # 笔记名目录 ├── 图文笔记的标题.md └── 1.jpg 2.jpg ...
补充说明:
Markdown 文件(图文和视频笔记都会生成)包含:标题、作者、发布时间、IP 属地、点赞/收藏/评论数、原文链接、话题标签、正文全文;图文笔记附图片引用,视频笔记附视频文件引用。md 头部带有
<!-- xhs-note: 笔记ID -->标记,用于断点续传识别。视频笔记额外有一个隐藏标记文件
.<视频名>.noteid记录笔记 ID 用于断点续传,请勿手动删除。Live Photo 会额外下载为
序号_live.mp4。
二、技术实现详解
2.1 总体架构
┌─────────────────────────────────────────────────────────────┐│ CLI 层 (cobra) ││ login / note / user / web 命令、参数解析、流程编排 ││ web 命令内嵌 HTTP 服务 + SSE 实时推送 + 单页控制台 │├──────────────┬──────────────────────┬───────────────────────┤│ browser 包 │ xhs 包 │ media 包 ││ Chrome 启动/ │ 链接解析、页面数据提取 │ 并发下载、重试、 ││ 连接、登录态 │ (笔记详情/用户笔记列表)│ 断点跳过、字节进度回调 │└──────────────┴──────────────────────┴───────────────────────┘ │ go-rod (CDP) │ Chrome / Edge 浏览器(已登录的小红书会话)
项目结构:
xhs-downloader/├── main.go # 入口├── go.mod├── internal/│ ├── cli/ # 命令行:root/note/user/login/web + 保存规划与 Markdown 生成│ │ └── webui.html # Web 控制台页面(go:embed 内嵌,随 exe 分发)│ ├── browser/ # 浏览器生命周期:连接/启动 Chrome、登录检测与等待│ ├── xhs/ # 小红书数据层:链接解析、笔记详情、用户笔记收集│ ├── media/ # 媒体下载器:并发池、重试、临时文件原子改名、进度回调│ └── util/ # 文件名清洗、时间格式化等工具└── downloads/ # 默认下载输出目录(运行时自动创建)
Web 控制台数据流:浏览器页面 ←(SSE 实时事件流)— Go HTTP 服务 ←(任务队列串行)— 笔记解析(go-rod 页面操作)+ 媒体下载池(并发 4)。页面操作(解析账号 / 逐个打开笔记详情)必须串行,媒体文件下载则全程并发,二者流水线重叠,解析下一篇的同时上一篇已在下载。
2.2 为什么用浏览器自动化,而不是直接调 HTTP API?
小红书的 Web API(edith.xiaohongshu.com/api/sns/web/v1/*)要求每个请求携带x-s / x-t 签名头,签名算法由混淆的前端 JS 生成且经常变更,纯 HTTP 方案:
需要在 Go 里逆向并长期维护签名算法,极易失效;
直接触发风控(验证码/扫码墙)的概率更高。
而小红书网页本身就把完整数据内嵌在页面 HTML 的全局变量里:
笔记详情页:
window.__INITIAL_STATE__.note.noteDetailMap→ 含标题、正文、话题、图片原图地址(imageList[].infoList)、视频流地址(video.media.stream.h264/h265/av1[].masterUrl);用户主页:
window.__INITIAL_STATE__.user.userPageData(用户信息)和window.__INITIAL_STATE__.user.notes(笔记列表,随页面滚动由小红书自己的前端代码分页加载——签名由页面自身完成,我们只读取结果)。
因此本工具用 go-rod(Go 语言的高性能 CDP 驱动)操控一个真实的、已登录的 Chrome/Edge:像人一样打开页面、滚动翻页,再从页面运行时里直接读出结构化数据。媒体文件(图片/视频 CDN 地址)则用普通 HTTP 并发下载。
2.3 浏览器管理(internal/browser)
连接浏览器的优先级:
--cdp显式指定的调试地址(支持ws://...、http://host:port、纯端口号);自动探测本机
127.0.0.1:9222是否已有开启调试端口的 Chrome(与你已有的小红书自动化环境兼容);都没有则自动启动一个新 Chrome/Edge:
用户数据目录默认
~/.xhs-dl/browser-data(登录状态持久化在这里);附带
--disable-blink-features=AutomationControlled降低自动化检测概率;浏览器查找顺序:
--browser-path指定 → 常见安装路径探测(Chrome/Edge)→ go-rod 内置探测。
登录检测:读取 web_session Cookie。未登录时会打开小红书页面并轮询等待,用户在弹出的窗口里扫码/短信登录即可,只需登录一次。
2.4 链接解析(internal/xhs/link.go)
支持的输入形态(可整段粘贴 App 分享文案,会自动提取其中的 URL):
| 输入 | 识别为 |
|---|---|
https://www.xiaohongshu.com/explore/<id>?xsec_token=... | 笔记 |
https://www.xiaohongshu.com/discovery/item/<id> | 笔记 |
| 24 位十六进制裸 ID | 笔记 |
https://www.xiaohongshu.com/user/profile/<uid> | 用户主页 |
http://xhslink.com/... 短链 | 在浏览器中跳转解析出真实链接 |
| 含链接的分享文案文本 | 自动提取 URL 后按上述规则识别 |
笔记详情请求必须携带分享链接里的 xsec_token,工具会自动解析并带上。
2.5 数据提取(internal/xhs/note.go、user.go)
单篇笔记:打开详情页 → 轮询 __INITIAL_STATE__.note.noteDetailMap 就绪→ 解析出图片列表(从 infoList 中选分辨率最高的原图)、视频流(按h264 > h265 > av1 的兼容性优先级,同编码取分辨率最高)、正文、话题、互动数据。提取失败时自动诊断页面:登录墙 / 笔记已删除 / 违规下架 / 私密笔记等,并给出明确报错。
账号全部笔记:打开用户主页 → 循环"读取笔记数量 → 滚动到底部 → 等待懒加载"→ 数量连续多轮不变判定加载完毕(中途若卡住会切换小幅滚动尝试触发加载)→一次性导出全部笔记的 id + xsecToken → 逐篇打开详情页提取并下载。全程带随机延时(1.2~3.5 秒),模拟人工浏览节奏,降低风控概率。
2.6 媒体下载(internal/media)
下载池并发数由
--concurrency控制(默认 5,即同时下载 5 个文件);每个任务:主地址失败自动重试 3 次(指数退避),再失败则切换备用地址(视频
backupUrls);请求携带 Chrome UA +
Referer: https://www.xiaohongshu.com/(部分 CDN 校验);先写
.part临时文件,完整后原子改名,避免半截文件;图片扩展名按响应 Content-Type 自动判定(jpg/png/webp/gif...);
已存在的文件自动跳过(配合 md 里的笔记 ID 标记实现整篇笔记级断点续传),
--force可强制重下。
三、环境要求
| 依赖 | 要求 | 说明 |
|---|---|---|
| Go | ≥ 1.21(开发使用 1.26) | 仅编译时需要;编译后的 exe 无依赖 |
| Chrome 或 Edge | 任意较新版本 | 运行时自动探测;Edge 也可以 |
| 网络 | 可访问 xiaohongshu.com | 国内网络直连即可 |
四、编译与打包
4.1 源码编译(Windows,本项目目录内)
cd D:\downloads\xhs-downloader# 拉取依赖(已配置 goproxy.cn 时直接可用)go mod tidy# 普通编译go build -o xhs-dl.exe .# 发布编译(去除符号表和调试信息,体积更小)go build -ldflags"-s -w"-o xhs-dl.exe .
4.2 跨平台交叉编译
# Windows amd64GOOS=windows GOARCH=amd64 go build -ldflags"-s -w"-o xhs-dl.exe .# Linux amd64(服务器无界面环境需已登录或配合 xvfb)GOOS=linux GOARCH=amd64 go build -ldflags"-s -w"-o xhs-dl .# macOS(Apple Silicon)GOOS=darwin GOARCH=arm64 go build -ldflags"-s -w"-o xhs-dl .
4.3 运行
编译产物是单文件可执行程序,无任何运行时依赖,拷贝到任何同架构机器即可运行:
.\xhs-dl.exe --help默认下载目录为可执行文件所在目录下的
downloads/。例如把xhs-dl.exe放在本项目根目录,下载内容就会存到本项目的downloads/。
4.4 单元测试
go test ./... # 链接解析等核心逻辑测试go vet ./...
五、使用教程
5.1 第一步:登录(只需一次)
.\xhs-dl.exe login程序会自动打开 Chrome/Edge 窗口并进入小红书;
未登录时请在窗口中扫码或手机验证码登录;
登录状态保存在
~/.xhs-dl/browser-data,之后运行所有命令都不用再登录。
如果你已经有一个开着调试端口的 Chrome(端口 9222),程序会自动复用它,也可以用
--cdp 9222显式指定。
5.2 下载单篇/多篇笔记(note 命令)
# 完整链接(从浏览器地址栏或"复制链接"获得).\xhs-dl.exe note "https://www.xiaohongshu.com/explore/64xxxxxx?xsec_token=ABxxxx"# xhslink 短链.\xhs-dl.exe note "http://xhslink.com/a/AbCdEf"# 直接把 App 里复制的整段分享文案粘进来也可以.\xhs-dl.exe note "79 某某发布了一篇小红书笔记,快来看吧! 😆 http://xhslink.com/a/xxx,复制本条信息,打开【小红书】App查看精彩内容!"# 一次下载多篇.\xhs-dl.exe note "链接1""链接2""链接3"# 从文件批量读取(每行一个链接或分享文案,# 开头为注释).\xhs-dl.exe note -f links.txt# 指定输出目录.\xhs-dl.exe note -o D:\backup\xhs "链接"
5.3 批量下载整个账号(user 命令)
# 下载该账号的全部笔记和视频(自动滚动翻页收集完整列表).\xhs-dl.exe user "https://www.xiaohongshu.com/user/profile/5axxxxxx?xsec_token=xxx"# 只下载最新 50 篇.\xhs-dl.exe user --max50"主页链接"# 只下载视频笔记 / 只下载图文笔记.\xhs-dl.exe user --type video "主页链接".\xhs-dl.exe user --type image "主页链接"# 后台无界面模式(前提:该浏览器数据目录已登录过).\xhs-dl.exe user --headless"主页链接"
用户主页链接获取方式:浏览器打开对方主页,复制地址栏 URL 即可(需包含页面上自带的
xsec_token参数)。
5.4 Web 控制台(web 命令)
不想敲命令行时,用浏览器页面操作下载:
.\xhs-dl.exe web # 默认端口 8080,自动打开系统浏览器.\xhs-dl.exe web --port9000# 指定端口
控制台提供两个功能页签:
👤 账号下载(多选)
粘贴用户主页链接 → 点击「解析账号笔记」;
程序会在后台浏览器中打开主页并滚动加载完整笔记列表(页面实时显示已发现篇数);
解析完成后展示笔记列表:封面、标题、类型(图文/视频),默认全选,支持全选 / 全不选 / 反选;
点击「下载所选」开始下载,内容保存到
downloads/<账号名>/video|note/。🔗 批量链接下载
文本框中每行一个链接(支持完整链接、xhslink 短链、App 分享文案,
#开头为注释);点击「开始下载」,内容保存到
downloads/video|note/。
📊 下载进度面板实时展示:
顶部总体进度条(已完成任务数 / 总任务数);
每篇笔记一张卡片:解析中 → 下载中
2/9(文件级进度)→ ✅ 完成(显示保存路径);视频文件下载时显示实时字节进度(如
12.3 MB / 45.2 MB(27%));可展开「运行日志」查看底层下载明细;
页面刷新后进度面板会自动恢复当前批次状态。
注意事项:
解析账号列表时后台浏览器会滚动页面,请勿手动操作那个浏览器窗口;
同一时间只执行一个批次任务(解析或下载),任务进行中不能再发起新任务;
控制台仅监听
127.0.0.1(本机访问),关闭命令行窗口或按Ctrl+C即停止服务。
5.5 全部参数说明
全局参数(所有命令通用):
| 参数 | 默认值 | 说明 |
|---|---|---|
-o, --output | <程序目录>/downloads | 下载保存目录 |
--cdp | 自动探测 9222 | 连接已运行的 Chrome 调试地址(ws://、http://host:port 或端口号) |
--browser-path | 自动探测 | Chrome/Edge 可执行文件路径 |
--user-data-dir | ~/.xhs-dl/browser-data | 浏览器用户数据目录(登录态存放处) |
--headless | 关 | 无界面模式(仅适用于已登录的情况) |
--concurrency | 5 | 媒体文件下载并发数(同时下载的文件数,笔记多/视频大时可调大加速,如 --concurrency 10) |
--login-timeout | 300 | 等待扫码登录的超时时间(秒) |
--force | 关 | 强制重新下载已存在的文件 |
-v, --verbose | 关 | 输出调试信息 |
note 命令:-f, --file 从文本文件批量读取链接。
user 命令:--max N 限制篇数(0=全部);--type all|image|video 类型过滤。
web 命令:--port N Web 服务监听端口(默认 8080)。
5.6 断点续传
任何时候中断(Ctrl+C、断电、报错),重新执行同一条命令即可继续:
已完整下载的笔记会被识别并跳过(按笔记 ID 标记精确识别);
下载一半的笔记:已存在的图片/视频文件自动跳过,只补齐缺失部分并生成 md。
六、常见问题(FAQ)
Q1:程序提示"未检测到小红书登录状态"?首次使用必须先 xhs-dl login 在弹出的窗口里扫码登录。登录状态保存在~/.xhs-dl/browser-data,不要随意删除该目录。
Q2:启动 Chrome 失败?
用
--browser-path "C:\...\msedge.exe"显式指定浏览器(Edge 也可以);或手动以调试模式启动 Chrome 后加参数
--cdp 9222:chrome.exe --remote-debugging-port=9222。
Q3:提示"笔记不可用 / 当前笔记暂时无法浏览"?笔记可能已删除、违规下架、被设为私密,或触发了扫码验证。扫码验证时请在浏览器窗口手动扫码一次后重试。
Q4:下载的视频是什么清晰度?自动选择该笔记提供的最高分辨率流,编码优先 h264(播放器兼容性最好),没有 h264 时依次回退 h265 / av1。
Q5:批量下载很多笔记会被限流吗?工具已在页面解析之间加入 1.5~3.5 秒随机延时模拟人工节奏。如果账号笔记非常多(数百篇),建议分批次下载(配合 --max),触发风控时稍等一段时间再试。
Q6:可以只重新下载某一篇吗?删除该笔记对应的目录/文件后重新运行命令即可;或加 --force 全量重下。
Q7:为什么图片扩展名是 .webp?小红书 CDN 默认返回 webp 格式,工具按实际内容保存。webp 可被绝大多数看图软件和浏览器直接打开。
七、免责声明
本工具仅供个人学习、研究与备份自己发布的内容使用;
请遵守小红书平台服务条款与相关法律法规,尊重原创作者的版权;
请勿将本工具用于任何商业采集、批量爬取牟利或侵犯他人权益的行为;
使用本工具产生的一切后果由使用者自行承担。