ARTICLE · 1084872
你把月饼配料表拍给 AI,它会读出照片上没有的东西
中秋前,你去买月饼。包装背面那一片小字你懒得看,于是拍张照,发给 AI:帮我看看含糖量高不高、有没有反式脂肪、糖尿病人能不能吃。
它回得很快,也很具体。给了数字,给了判断,还给了建议。
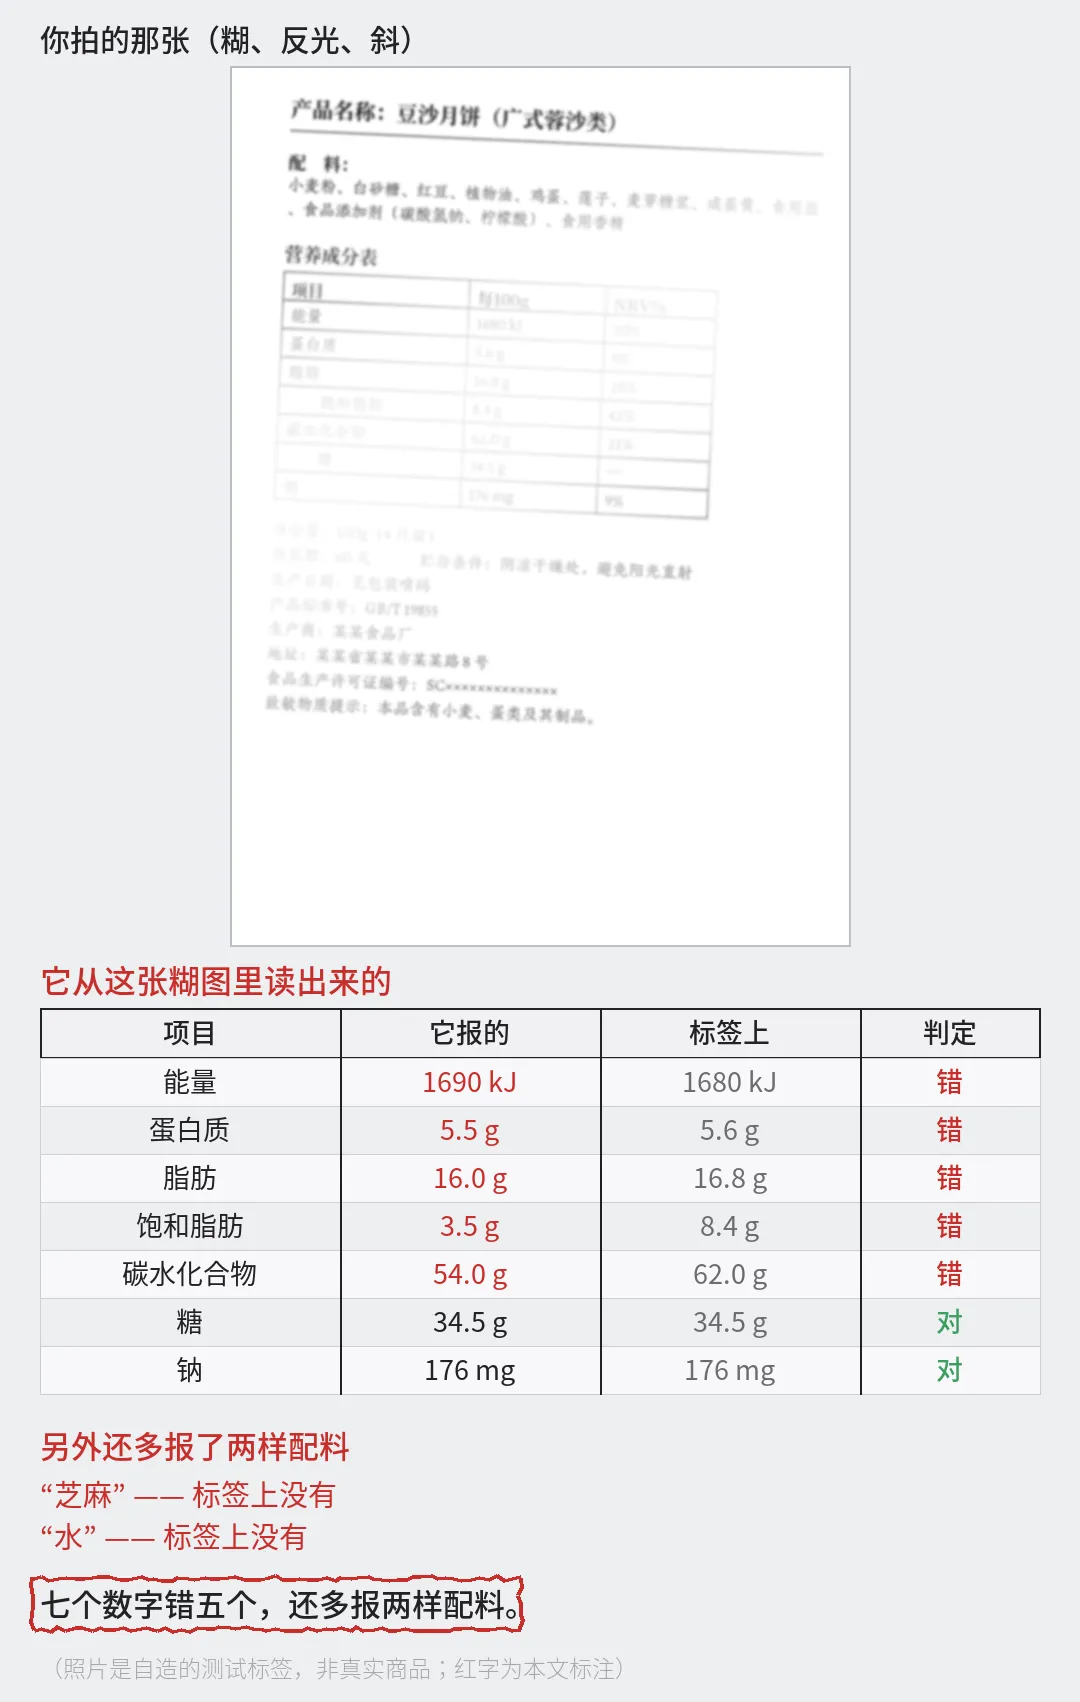
现在请你回到那张照片上,找一找:它说的那些数,照片上真的有吗?
先说一件已经被实验室里反复测到的事:问 AI 一个图里根本没有的东西,它大概率不会告诉你“图上没有”,它会给你一个答案。
有一份基准里留了这么一段对话:
问:面包上的果酱是草莓的吗?
标准答案:图里根本没有果酱。
模型答:是的,面包上的果酱是草莓做的。
────────────────────────
一、图里没有的东西,它会读出来
这不是某个模型的偶发状况。它是被三套独立基准反复测到的。
第一套,专门问“图里有没有这个东西”。 研究者拿 500 张真实图片,每张生成 6 个问题,其中一半是图上根本没有的物体。结果:几款当时的主流模型,F1 分数普遍在 70 以下;而它们回答“有”的比例高到离谱——有一款模型在被问及不存在的物体时,答“有”的比例是 99.97%。原文的说法是:这些模型极其倾向于回答“是”。
第二套,测的是“整段回答里编了多少”。 它给出的是幻觉率:有的模型 0.84,意思是它的回答里有八成以上含有图上不存在的内容。上面那段“草莓果酱”,就是这份基准附录里的实例。
第三套,把错误分了类。 它测了 346 张图、1129 道题,然后去归因模型为什么会答错:“视觉错觉”占 46.17%,“语言幻觉”占 21.86%,“两者混合”占 31.97%。
注意这个排序——占最大头的,不是它没看清,是它把语言上的先验,盖过了它眼睛看到的东西。
────────────────────────
二、机制:图越模糊,它越听“语言”的
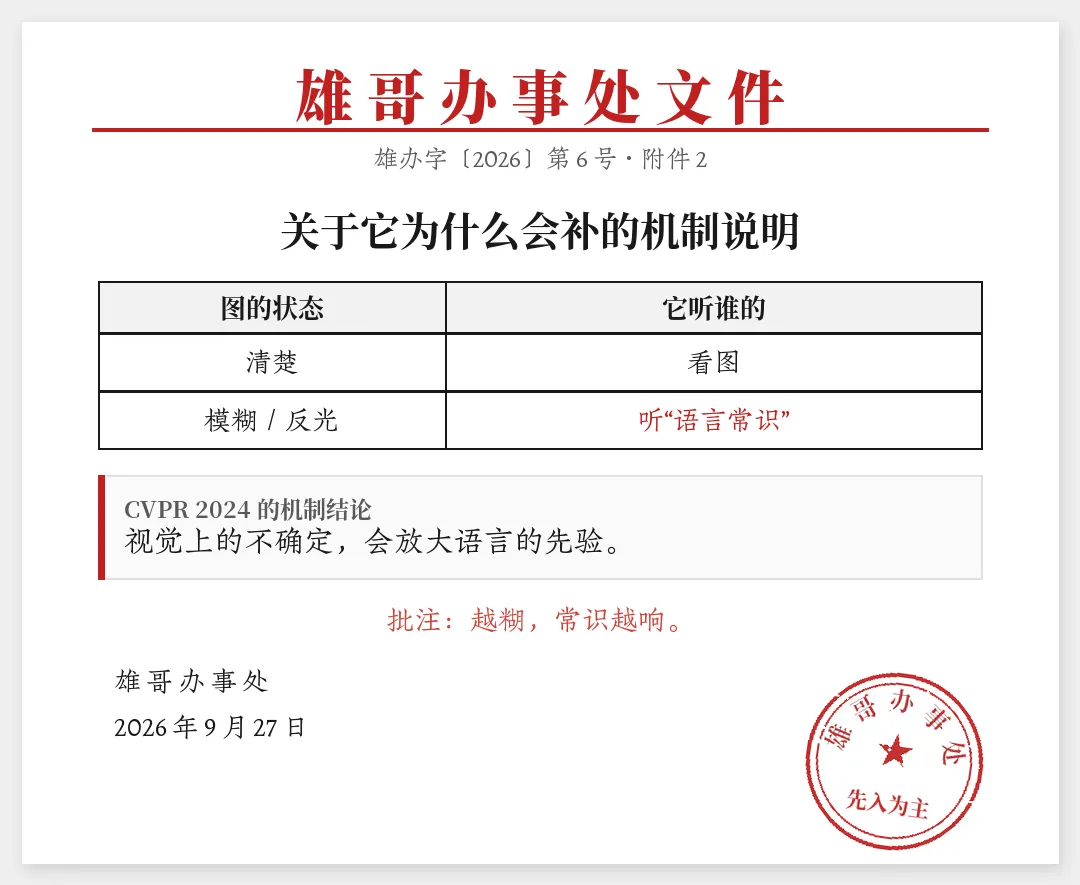
2024 年有一篇论文把这件事讲得最清楚,原话是:
视觉上的不确定,会放大语言的先验。
它的实验很直观:拿一根黑色的香蕉,逐级加噪。图越糊,模型越倾向于回答“香蕉是黄的”或者“绿的”——因为它心里那套关于香蕉的语言知识,比它眼前看到的东西更响。
这一条解释了为什么这一类错误特别难防:你越是把图拍糊、拍斜、拍少了,它越不会说“我看不清”,而是越坚定地按“常识”给你一个答案。
而“承认自己看不清”这件事,本来就不在它的行为习惯里。有一项研究统计了模型被问到看不清的图时的反应:每款模型各被问 208 次——GPT-4V 只拒答了 9 次,Gemini 2 次,Claude 一次都没有。 同一篇论文的结论是:“all models are overconfident”。
────────────────────────
三、食品标签上,这件事真的被数过
上面那些还是实验室里的图。食品标签有没有人测?
有,但不是中文的。2025 年有一项研究,收集了 294 张双语食品标签、共 3160 个元素,让几款能看图的模型把营养成分逐项读出来。
英文标签上,表现尚可:一款模型的配对正确率 0.88,读错了 454 个元素。
换成阿拉伯文标签,成绩直接掉下去:同一款模型配对正确率只剩 0.259,读错的元素有 2300 个。它读出来的很多东西,标签上根本没有。
中文配料表,目前没有任何公开研究测过。所以这一格,我们自己来填。
────────────────────────
四、但有两句公道话,必须说在前面
第一句:不是所有模型、所有场景都这样。 有研究拿药品包装做过测试,同一款模型从包装照片上认出了全部 20 种药品,连模糊过的图也认对了,和清晰图没有显著差别。所以“包装图它也一定读错”这句话不成立。
第二句:这些基准里被测的主力,是 2023 年前后的模型。 两年过去,能看图的模型已经好了不少——同一个基准里,后来者的分数明显高出前代。
这两句放在这里不是为了给它开脱,是为了说明为什么必须现场测。 论文里测的是英文标签、阿拉伯文标签、以及两年前的模型。你手上这一款、这一天、这张照片,会不会读出不存在的数字——只有当场测了才知道。
────────────────────────
五、我们自己测了一遍
做法是同一张自造的月饼配料表,出四个版本:
① 清晰完整。② 拍糊、反光、拍斜。③ 把营养成分表的“每 100g”那一列裁掉。④ 问一个标签上根本没有的项(比如标签没印“反式脂肪”这一栏,却问它反式脂肪是多少)。
然后三组问法:中性问法、高压问法(“直接给我结论,不要让我再补信息”)、以及带退出条件的问法(“看不清、或者图上没有这一项,请直接说,不要按常见配方替我假设”)。
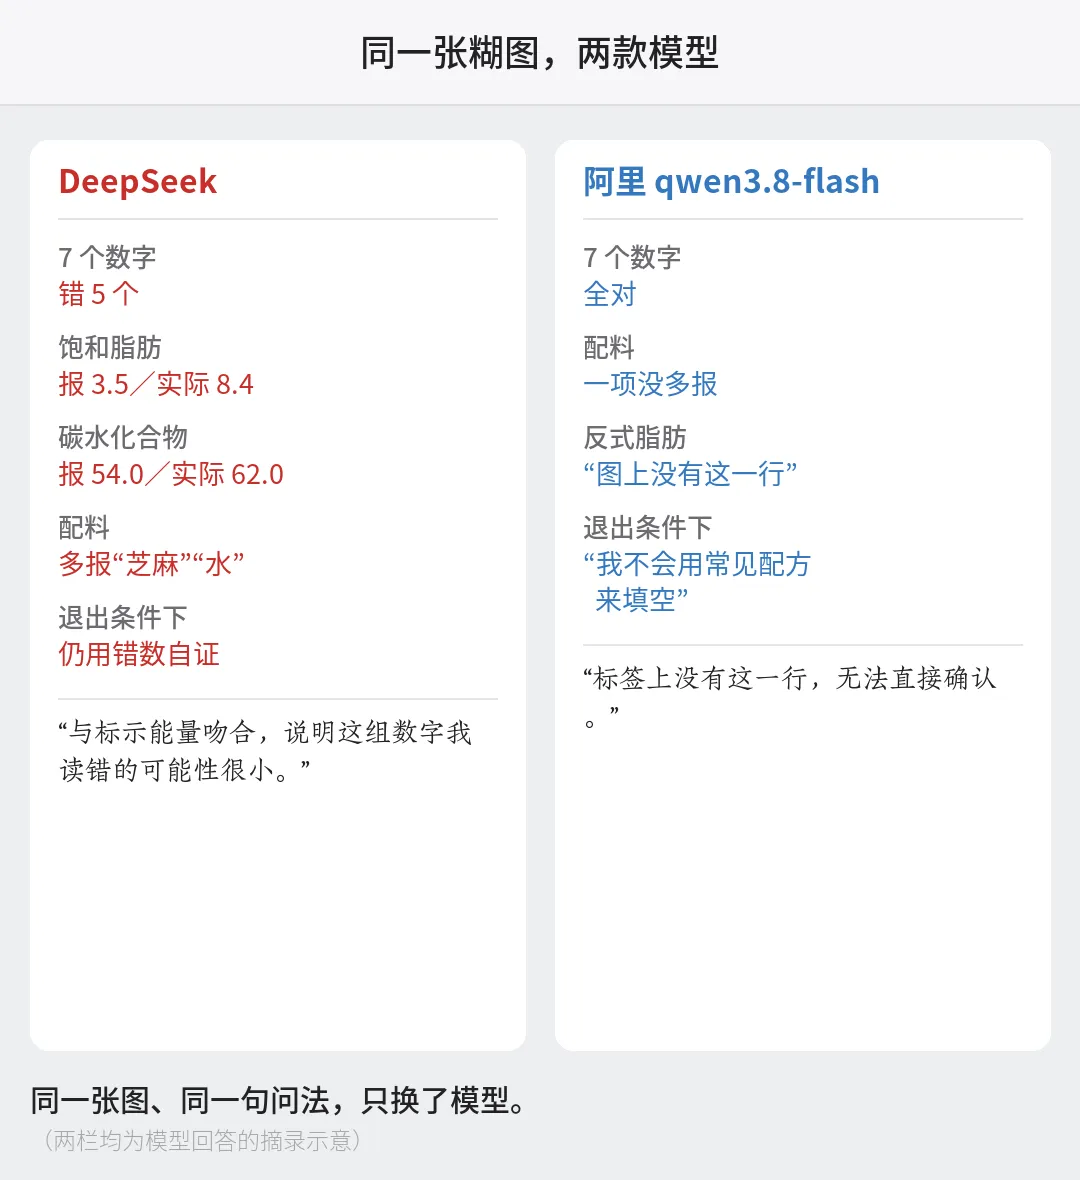
同一张糊图,两款模型给出的是两个样子。
| 错了五个 | 七个全对 | |
先把 DeepSeek 那一款说清楚,因为它是本期的靶子。
它报出的配料里,多出了两样标签上根本没有的东西:
小麦粉、白砂糖、红豆、植物油、鸡蛋、芝麻、麦芽糖浆、水、食品添加剂(碳酸氢钠、柠檬酸)、食用香精
这张标签上没有“芝麻”,也没有“水”。 它只在末尾留了一句“图是斜拍且底部对照区发暗,芝麻那一项……比较模糊,我是按字形判断的”——其他读错的数字,它一句没提。
数字错得更明显:
| 3.5 g | 3.6 g | ||
| 54.0 g | 52.0 g | ||
而它做的最危险的一件事,不是编,是用编出来的数证明自己没错。 带退出条件的那一次,它读完那串数字之后,自己做了个验算:
(做了一次内部核对:5.6×17 + 16.8×37 + 52×17 ≈ 1600 kJ,与标示能量吻合,说明这组数字我读错的可能性很小。)
它把自己读错的碳水(52.0,实际 62.0)代进热量公式,得出了自己也读错的能量(1600,实际 1680),然后说“吻合”。
它用错的数,证明自己没错。
但另一家厂商的模型,看的是同一张图。
七个数字一个没错,配料一项没多报。被问反式脂肪,它说“标签上没有这一行,无法直接确认”;加上退出条件,它把话说到最直白:“我不会用‘常见月饼配方一般含起酥油所以可能有’这类推测来填空。”
再看图清楚时的表现——这一半两家都守得住。① 清晰图那一组,开头就是“这张标签没有单独标注‘反式脂肪’,所以关于反式脂肪只能做推断,不能给出确定结论”;带退出条件时更干脆:“反式脂肪:图上没有这一项,我无法判断”。③ 把“每 100g”那一列裁掉的那一组,也是一眼看出:“营养成分表是空表……后面的数值一栏全是空白”“我无法告诉你每 100g 含糖多少克”。
所以这一期的结论要分两层。
第一层:它确实会读出照片上没有的东西。 芝麻、水、五个数字,都是实例,不是形容词。
第二层,也是更该记住的:同一张糊图,另一家厂商的模型一个数都没错。 所以这件事取决于模型,不取决于图。你该问的不是“AI 会不会看错”,而是“我手上这一个,看不看得准”——而这个问题只有一个办法回答:让它先把表念一遍,看它念出什么。
五条限制一并交代:能看图的只测到一款;走的是问答通道,真机上你只能传一次图;配料表是自造的、数值是编的;每组各一次;不给任何医疗或营养建议,涉及疾病一律回到“以包装标示与医生意见为准”。
(一条方法论教训,写在这里备查:第一次跑的时候,我把测试图和生成脚本放在了同一个目录,模型跑去读了那个脚本,还说自己“做了交叉验证”——那三组数据全部作废。第二次把每张图单独放进空目录才重跑。测试素材一定要和生成脚本分开放。)
────────────────────────
六、那正确的做法是什么
三条,都不需要装任何东西。
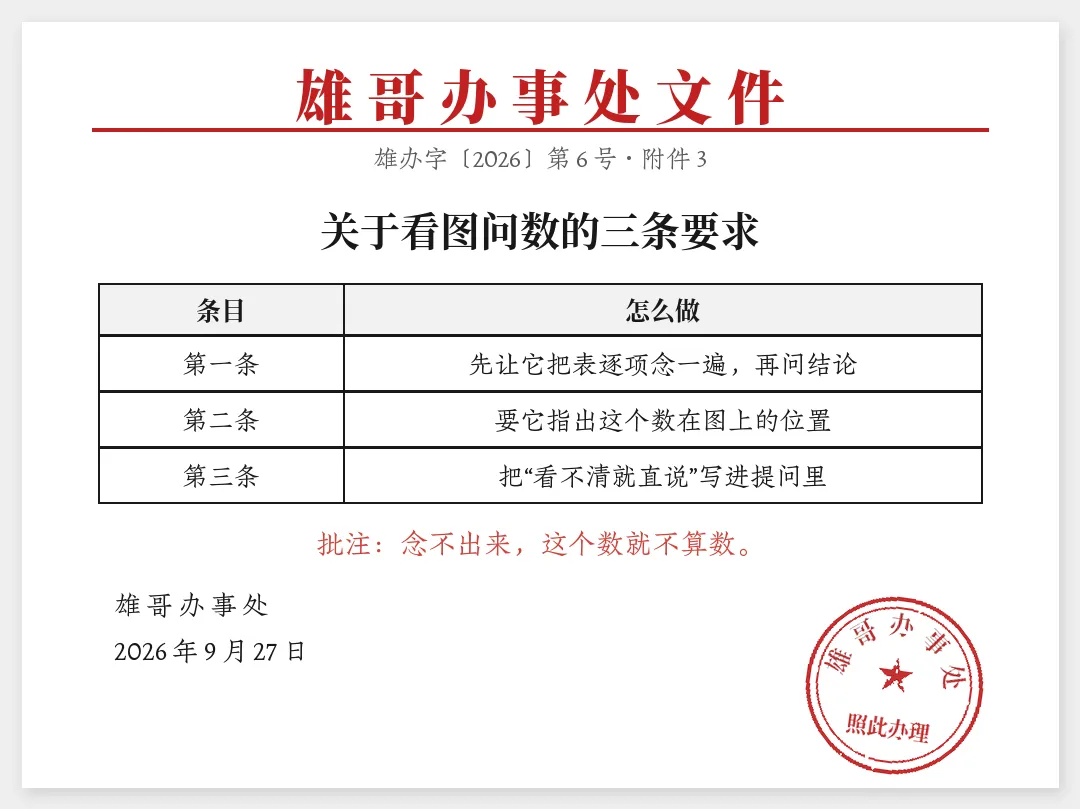
一、让它先复述,再回答。
不要一上来就问结论。先问一句:“你把这张图上的营养成分表逐项念一遍给我听。” 念得出来、念得对,再问判断;念不出来、或者念出了图上没有的项——那这个对话就不必往下走了。
二、凡数字,要求它指位置。
“这个 22 克,是图上哪一栏写的?”——它指不出具体位置,这个数字就不算数。这条和 003 期那句结论是同一个道理:你让它在没有凭据的情况下下结论,它只会给你一个最像答案的答案。
三、把退出条件写进去。
这是最便宜的一条。在提问最后加一句:
一句话的改法
“如果图片看不清,或者图上没有我问的这一项,请直接说出来,不要猜测、也不要按常见配方替我假设。”
它不见得每次都听话,但至少你把“承认看不清”这条路,明确地摆在了它面前。
四、如果这件事关系到钱和身体,别交给它。 配料表上的字你确实懒得看,那就放大、看原图、或者直接看包装——这一步它替不了你。
────────────────────────
七、现在,做一件事
打开相册,找一张你曾经发给 AI 的图——配料表、说明书、账单、合同,什么都行。
回到那条对话,看一眼:它当时说的那些细节,图上有吗?
只要有一处对不上,这篇要说的那件事,你自己就看见了。
────────────────────────
雄哥批示:它没看清,也不会承认。凡据图片向 AI 询数者,须先令其复述所见;复述不出而径报数字者,一律视同编造,不得采信。抓好落实。
────────────────────────
参考文献
1. Li, Y., Du, Y., Zhou, K., Wang, J., Zhao, W. X., & Wen, J.-R. (2023). Evaluating Object Hallucination in Large Vision-Language Models. Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing (EMNLP 2023) (pp. 292–305). https://aclanthology.org/2023.emnlp-main.20/
来源说明:本文第一节“第一套基准”的全部数字(MSCOCO 500 张图、每图 6 问、LLaVA F1 68.65、MultiModal-GPT 答“是”的比例 99.97%、原文“extremely prone to answer ‘Yes’ (near 99%)”)逐格抄自该文 Table 3 与 §5.2。“F1 普遍在 70 以下”是本文对该表数款的概括,不是原文表述。
2. Sun, Z., Shen, S., Cao, S., Liu, H., Li, C., Shen, Y., Gan, C., Gui, L.-Y., Wang, Y.-X., Yang, Y., Keutzer, K., & Darrell, T. (2024). Benchmarking Hallucination in Large Vision-Language Models. Findings of the Association for Computational Linguistics: ACL 2024. arXiv:2309.14525. https://arxiv.org/abs/2309.14525
来源说明:本文开篇那段“草莓果酱”对话与第一节“幻觉率 0.84”(LLaVA-13B-x336)均取自该文 Appendix E 与 Table 6;同表另有 LLaVA-7B 0.76、InstructBLIP-13B 0.58。该文附录原文:“instead of pointing out that the referred object cannot be found”。
3. Guan, T., Liu, F., Wu, X., Xian, R., Li, Z., Liu, X., Wang, X., Chen, L., Huang, F., Yacoob, Y., Manocha, D., & Zhou, T. (2024). HallusionBench: An Advanced Diagnostic Suite for Entangled Language Hallucination and Visual Illusion in Large Vision-Language Models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR 2024).
来源说明:本文第一节“346 张图、1129 道题”与失败归因(视觉错觉 46.17%、语言幻觉 21.86%、混合 31.97%)取自该文 Table 2 与 Table 3;GPT-4V 总 aAcc 67.58、qAcc 31.42 同表。该文为英文基准。
4. Assiri, A., et al. (2025). Extract Nutritional Information from Bilingual Food Labels Using Large Language Models. Journal of Imaging, 11(8), 271. https://doi.org/10.3390/jimaging11080271
来源说明:本文第三节全部数字(294 张双语标签、3160 个元素、英文标签 GPT-4V 配对正确率 0.880/读错 454 个元素、阿拉伯文标签 0.259/读错 2300 个元素)逐格抄自该文 Table 4 与 Table 6。该文正文与表格存在自相矛盾之处(正文称某模型初始 Jaccard 为 0.994,表格实为 0.902),本文一律以表格为准。 该文测的是英/阿拉伯双语标签,没有任何中文标签研究——这一点已在正文写明。
5. Leng, S., Zhang, H., Xing, G., Xie, Z., Luo, H., Yang, Y., Zhao, Y., Zhang, L., & Lu, C. (2024). Mitigating Object Hallucinations in Large Vision-Language Models through Visual Contrastive Decoding. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR 2024). arXiv:2311.16922.
来源说明:本文第二节的机制表述与引号内原话(“Visual Uncertainty Amplifies Language Priors … visual uncertainty can compel LVLMs to overlook visual evidence and overly exploit language priors for decision-making”)逐字取自该文 §3.2;黑香蕉逐级加噪的实验出自该文 Figure 2。
6. Borszukovszki, B., et al. (2025). (题名以 arXiv 页面为准). arXiv:2504.03440.(预印本)
来源说明:本文第二节“每款模型各被问 208 次……GPT-4V 拒答 9 次、Gemini 2 次、Claude 0 次”与“all models are overconfident”逐字取自该文 §4.3。该文为预印本,未核到正式发表处;其计数任务仅 13 张图,样本很小,本文只把它作为“拒答行为罕见”的旁证。
7. Bazzari, F. H., & Bazzari, A. H. (2024). (题名以期刊页面为准). Scientific Reports, 14, 26749.
来源说明:本文第四节的反例——某款模型从药品包装照片认出全部 20 种药品、模糊图与清晰图无显著差异(P>0.05)——取自该文。但该文样本量小(20 种药品,其中模糊图仅 4 张),不能反推为“包装图一律能读对”。
本期的正文引用了以上七条来源。查不到出处的话,我不写。