ARTICLE · 1089313
一半的PDF根本不用OCR:这个Rust库20ms就能判断
一句话介绍:pdf-inspector 是 Firecrawl 开源的 Rust 库,先用 20 毫秒判断一份 PDF 是"文字版"还是"扫描件",文字版直接在本地抽出干净的 Markdown,只有真正需要的那几页才送去 OCR。
你为一半的 PDF 付了两次钱
先说一个在文档处理流水线里极其常见、但很少有人算账的场景。
一批 PDF 进来了,你的处理流程大概是:丢进 OCR → 拿到文本 → 切块 → 入库。稳、通用、不用动脑子。代价是每份文件 2 到 10 秒,外加 OCR 服务的账单。
但 Firecrawl 在处理海量 PDF 时统计出一个数字:大约 54% 的 PDF 本身就带文字层。
也就是说,一半以上的文件,你付了 OCR 的钱和十几秒的等待,去"识别"一段本来就规规矩矩躺在文件里的文本。更糟的是,OCR 识别出来的质量往往还不如直接抽原文——字符错认、表格结构丢失、多栏顺序错乱,全都是 OCR 送的。
问题不在 OCR 不好,在于你在所有文件上无差别地用了它。
真正需要的其实只是一个前置判断:这份 PDF 有没有文字层?有的话直接抽(毫秒级),没有的话再送 OCR(秒级、花钱)。
Firecrawl 把这个判断做成了一个库,然后开源了。
它是什么
| 19,359 / 1,311 | |
Firecrawl 自己的说法很直白:建它是为了在 200ms 内在本地处理完文字版 PDF,从而跳过那 54% 本不需要 OCR 的文件。
注意它的定位——它不是又一个 PDF 解析库,它是一个"要不要 OCR"的路由器,顺带把不需要 OCR 的那部分活干得又快又好。
20 毫秒的分岔口
分类是整个项目的核心,做法出乎意料地朴素:
1. 解析 xref 表和 page tree——不加载整个文档的对象 2. 按扫描策略挑几页(默认均匀采样 8 页:首页、末页、中间) 3. 在内容流里找 Tj/TJ(文字操作符)和Do(图像操作符)4. 根据这些页上文字操作符的存在情况做判断
就这样。没有模型、没有渲染、没有启发式黑箱。所以它能在10–50 毫秒内给出结论,300 多页的 PDF 也是毫秒级。
输出四类:TextBased(文字版)、Scanned(扫描件)、ImageBased(纯图)、Mixed(混合),附带一个 0.0–1.0 的置信度。
真正有用的是后面这一项:pages_needing_ocr——一份清单,列出具体哪几页缺文字层。
这一下把"这份文件要不要 OCR"的全有或全无,变成了逐页路由。一份 40 页的合同,前 38 页是电子版、最后两页是手写签字扫描件,那就只把第 39、40 页送去 OCR。这是"混合型"文档最省钱的打开方式。
采样策略可以按场景换:
EarlyExit | ||
Full | ||
Sample(n) | ||
Pages(vec) |
过了分岔口:提取这一半的活
判断出"这是文字版"之后,才进入提取。这部分做得比多数同类库细:
• 位置感知:每个文本项都带 X/Y 坐标和字体信息,不是一堆没有结构的字符串 • 多栏阅读顺序:自动识别报纸式分栏,按正确顺序串联,支持 RTL(从右向左)文本 • 旋转文本:页边印章、图表坐标轴标题这类旋转文字,会保留真实的轴对齐包围盒并单独报告 rotation角度,而不是退化成零宽度的怪东西• CID 字体:ToUnicode CMap 解码 Type0/Identity-H,覆盖 UTF-16BE、UTF-8、Latin-1——中日韩 PDF 最容易在这一步变乱码 • 编码损坏检测:如果字体编码是坏的,它不硬撑,主动标记出来让调用方回退 OCR。这一点很实在:知道自己不行,比硬给出一个错误结果强
还有个工程细节:整个文档只解析一次,检测结果和提取结果共享同一份解析,不会重复读文件做两遍 I/O。
再往下:变成能直接喂给模型的 Markdown
对 RAG 和 Agent 来说,抽出来的文本长什么样,比抽没抽出来更关键。它转成 Markdown 时的规则:
• - * ○ ● ◦1. 1) (1);a. a) (a) | |
... |
最后那条"点线折叠"尤其能体现作者的意图:这东西的产出是给 LLM 吃的,目录里一串 .................... 纯粹是浪费 token。CLI 里还有个 --compact 参数专门干这个。
表格是分水岭
PDF 解析好不好,八成看表格。它的做法是双模式:
• 矩形模式:从 PDF 绘图指令里提取线条矩形,用并查集(union-find)把相邻矩形合并成表格 • 启发式模式:没有画线时,靠文本对齐关系推断表格结构
两条路都能走,最后进网格模块做行列分配、再渲染成 Markdown 表格。跨页续表、脚注、财务报表里挤在一起的数字串,都在处理范围内。
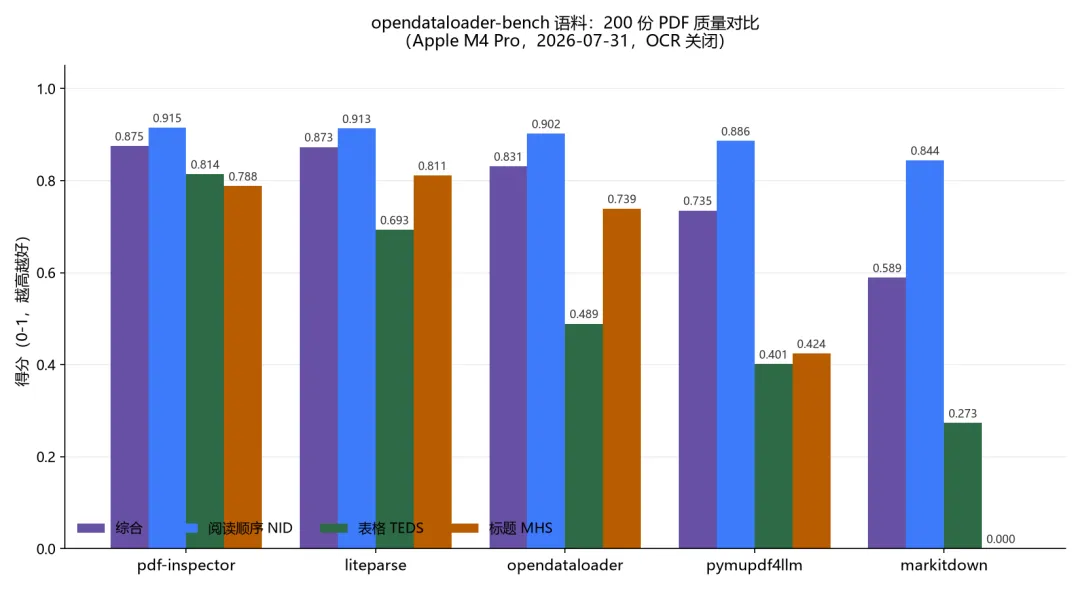
跑分也印证了这一点:表格(TEDS)拿到了 0.814,而同场竞技的 pymupdf4llm 是 0.401、markitdown 是 0.273。差了一倍。
跑分:200 份文档,17 秒对 0.47 秒
在 opendataloader-bench 语料(200 份 PDF)上,纯本地引擎、关闭 OCR 的对比(分数 0–1,越高越好;2026 年 7 月 31 日在 Apple M4 Pro 上跑):
| pdf-inspector | 0.875 | 0.915 | 0.814 | 0.470s | |
| 0.811 | |||||
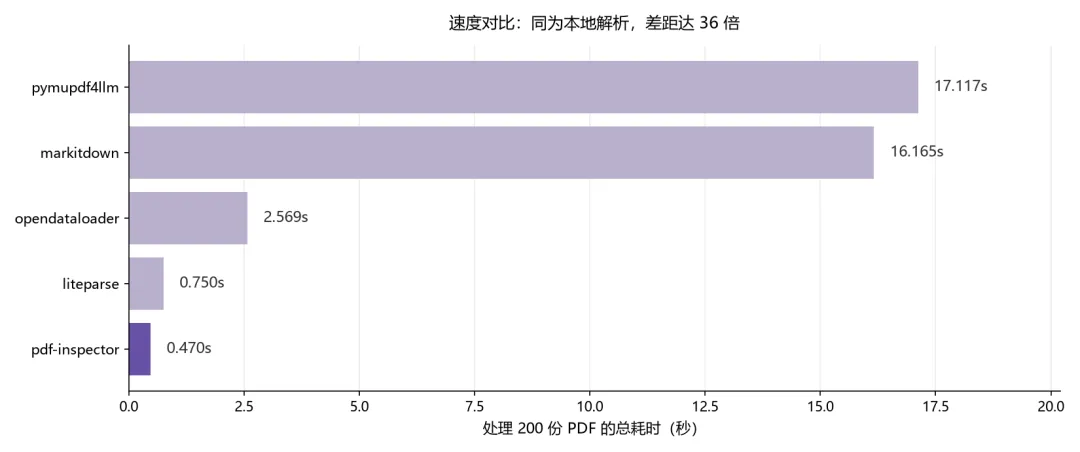
综合分最高,阅读顺序最高,表格最高,而且比第四名快了 36 倍。
标题识别(MHS)略低于 liteparse(0.788 对 0.811)——README 里没有回避这一点,属于少见的诚实。作者自己也写了它的最佳适用场景:报告、论文、财报、发票、法律文书这类文字版原生 PDF。
顺带说一句,跑分仓库里还留了完整的配置、逐文档预测和评估输出,可以自己复现;项目里也带了配对评测工具,能用同一份语料对比两个本地构建。
怎么用
Python(最省事)
pip install pdf-inspectorimport pdf_inspectorresult = pdf_inspector.process_pdf("document.pdf")print(result.pdf_type) # "text_based" / "scanned" / "image_based" / "mixed"print(result.markdown) # Markdown 字符串或 None# 选择性 OCR:干净的文字版 PDF 不会加载外部 OCR 运行时ocr = pdf_inspector.process_pdf_with_ocr("document.pdf")print(ocr.pages_routed_to_ocr)命令行
cargo install pdf-inspectorpdf2md document.pdf # 转 Markdownpdf2md document.pdf --json # JSON 输出(含标题、作者、生成工具、日期等元信息)pdf2md document.pdf --items-json # 带坐标的文本项(轴对齐框、旋转角度、字体、颜色、下划线)pdf2md document.pdf --pages # 插入 <!-- Page N --> 分页标记pdf2md document.pdf --select-pages 1,3,5-10 # 只处理指定页pdf2md document.pdf --compact # 省 token 的紧凑输出detect-pdf document.pdf --json # 只做分类,不提取detect-pdf document.pdf --analyze --json # 分类 + 版面分析(表格、分栏)Node.js:npm install @firecrawl/pdf-inspector;浏览器:npm install @firecrawl/pdf-inspector-wasm,同一套 Rust 解析器跑在浏览器和 Web Worker 里,CMap 内嵌,文件不出本机、不走服务器。
关于 OCR 的一点说明:Rust 和 CLI 默认是纯提取,OCR 要 cargo install --features ocr 开启;PDFium 和 ONNX Runtime 是外部依赖,只有页面真的被路由到 OCR 时才加载。Python 和 Node 的原生包已内置这套流程。OCR 用的是本地 PP-OCRv6 Small,返回结果里会标明每页的文本来源和置信度,并给出"建议交给托管流水线"的页面清单。
什么情况下别用它
讲清楚边界,免得用错地方:
• 你的 PDF 主要是扫描件——那它的价值就只剩下"告诉你得去 OCR",提取能力用不上 • 需要复杂版面理解(比如图文混排的杂志页、表单字段的语义)——它做的是文本和表格,不是版面理解模型 • 加密 / 带权限的 PDF——得先解密 • 极端精度要求——表格 0.814 意味着仍有约两成不完美,关键业务要自己拿样本验一遍
它最舒服的位置是:流水线最前面那道闸门。进来一份文件,20 毫秒决定走快车道还是慢车道。
一条流水线的样子
PDF 到达 → pdf-inspector 分类(约 20ms) → 文字版且置信度高? 是 → 本地提取(约 150ms),完成 否 → 送 OCR 服务(2–10s)把 150 毫秒和 10 秒放在同一张图上看,你就会明白这个库为什么值得单独存在。
它省下的不只是 OCR 的费用——是你原本根本不必花的那一半。
开源地址:https://github.com/firecrawl/pdf-inspector项目主页:https://firecrawl.github.io/pdf-inspector/