ARTICLE · 1089322
如何让AI开始接管微信
微信里最值钱的东西,你每天都在"手动搬运"
开头:你有没有算过,每天花多少时间在"搬信息"?
先问你一个问题。
你上一次把微信里的聊天记录,整理进笔记 / 文档 / 知识库,是什么时候?
可能是客户发来的一版需求,可能是群里讨论的一个方案,可能是一段特别有价值的对话——你截了图、复制了文字、新建了文档、粘进去、调格式……
前后花不了十分钟,但这件事,你一年要干几百次。
更要命的是:搬完之后,这些信息就死了。 躺在某个文件夹里,再也没被打开过。
今天这篇,讲一个我刚用上的小工具,以及它背后一个更大的问题:微信里的信息,为什么一直流不到该去的地方?
一、微信,可能是你最重要却最封闭的数据库
先说一个有点反直觉的事实:
你工作中最有价值的信息,大概率都躺在微信里。
客户的需求、领导的指示、同行的观点、群里的方案讨论、供应商的报价——这些信息产生的时候,都发生在微信对话里。
但微信有个天然的墙:它的内容是封闭的。
想整理成文档?手动复制粘贴 想沉淀进知识库?手动复制粘贴 想丢给 AI 分析?手动复制粘贴
你成了微信和外部工具之间的"人肉 API"。
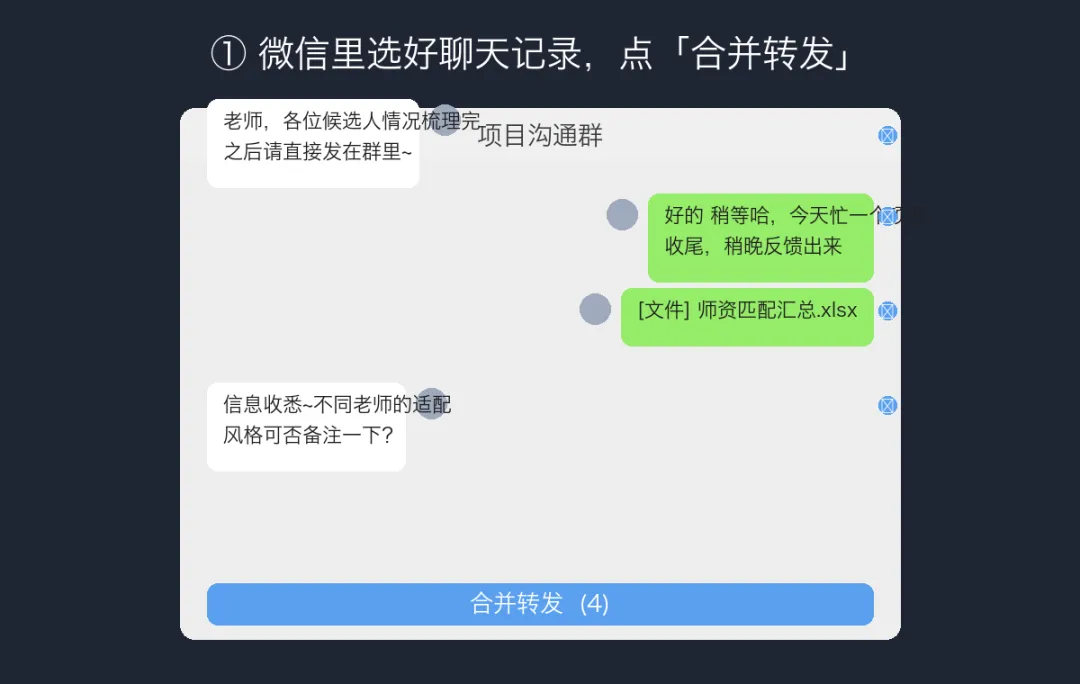
每一次搬运,都在消耗你的注意力和时间。
二、一个关键的技术细节:微信其实给了你一个后门
转机出现在微信 4.1.13 版本。
这个版本上线了一个功能:多选聊天记录后,可以"合并转发"给第三方应用。
微信会把这些聊天记录打包成一个压缩包——里面是 TXT 文本 + 图片,结构完整。
这意味着什么?
微信主动把内容"导出"出来了。
你不需要破解它、不需要读数据库、不需要任何违规操作——微信自己把门打开了一条缝。
问题在于:系统默认的"转发到其他应用"列表里,只有支持 Share Extension 的 App 才能出现。大多数你想用的工具(AI 助手、笔记软件)都不在这个列表里。
缝开了,但没桥。
三、微信流:给这条缝搭一座桥
我最近用上一个工具,叫「微信流」,就是来搭这座桥的。
它的原理很简单:做一个 macOS 的分享扩展,出现在微信的转发菜单里。
于是你的操作变成了:
微信里多选聊天记录
↓
点"合并转发"
↓
选择目标(AI 助手 / 笔记软件 / 剪贴板)
↓
它自动激活目标 App 并把内容放进去
从"复制-切换-粘贴-调格式"四步,变成一步。
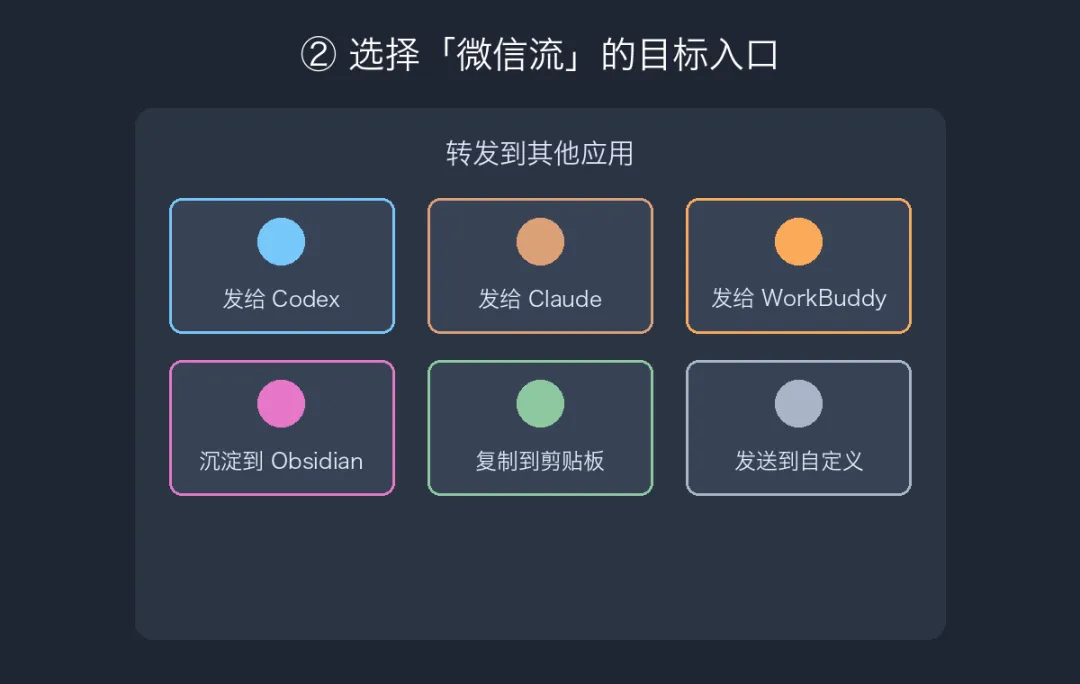
它支持的九个入口我列一下:
- 发给 Codex / Claude / 豆包 / 千问办公 / WorkBuddy
—— 直接丢给 AI 处理 - 沉淀到 Obsidian
—— 转成 Markdown,写进你的知识库 - 复制到剪贴板
—— 交给手动处理 - 发送到自定义
—— 你自己维护的 App 清单
四、最关键的问题:这玩意儿安全吗?
这一节我要认真写,因为它是我决定用之前,花时间最多去验证的部分。
先说我自己最关心的问题:会不会被微信封号?
网上搜一圈,你会看到大量"微信自动化工具跑路/封号"的案例。它们被封,是因为用了这几种手段:
- 动态库注入:强行给微信进程"打针",篡改运行时内存
- 逆向私有协议:伪造发包收包,模拟非官方客户端
- 解密本地数据库:硬解微信加密的 SQLite/WCDB 文件
共同点:都侵入了微信的进程空间。 腾讯的客户端完整性校验和云端风控一查一个准,露头就秒。
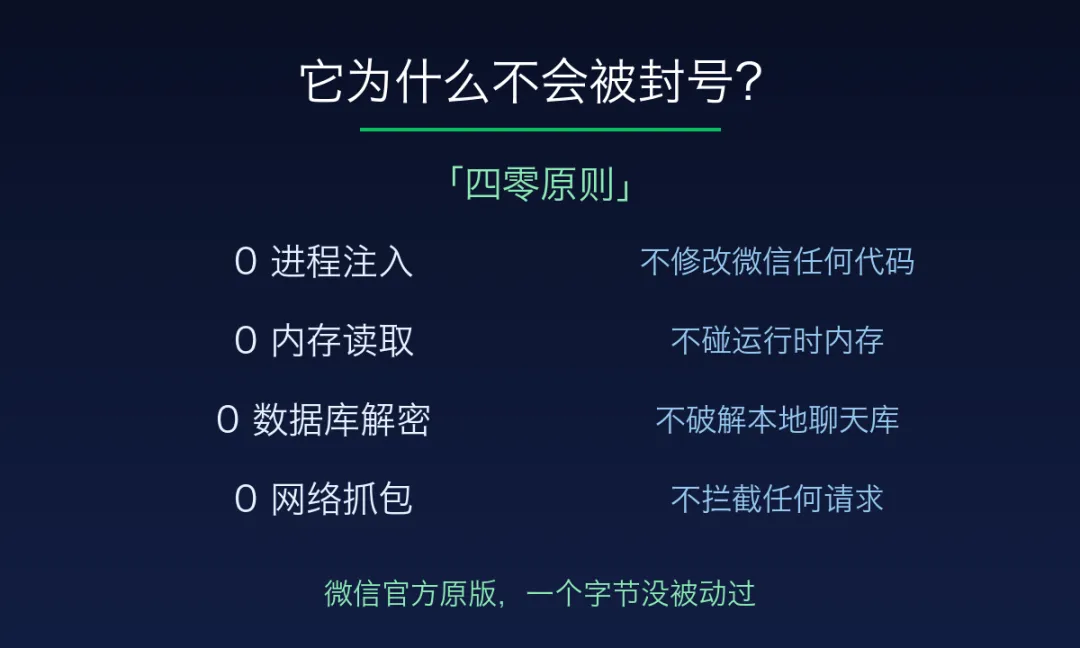
微信流走的是完全不同的路。 它提出了一个"四零原则":
微信在你 Mac 上运行,从内到外都是 100% 官方原版,一个字节都没被动过。 风控系统自然没有触发条件。
那聊天记录是怎么导出来的?
答案朴素到让人意外:用的是微信官方主动提供的系统功能。
当你点"合并转发"时,微信程序自己做了两件事:
1. 把选中的文字、图片、视频自己打包成一个标准 .zip
2. 通过 macOS 官方标准分享接口(NSSharingService),把压缩包交给苹果系统
而微信流,本质上就是一个按苹果官方规范开发的分享扩展(Share Extension)。
打个比方就懂了:
以前的外挂,是翻墙撬锁闯进微信家里偷东西,抓到必封;
微信流,是微信官方在门口设了个正规寄件窗口——微信自己打包好递出来,由苹果系统派送。
你选微信流,和选"隔空投送""备忘录",在微信眼里没有任何区别。
再说隐私:聊天记录会被上传吗?
不会。纯本地运行。 开发者的原话是"物理级断网"——分享扩展在 macOS 沙盒里跑,没有网络权限。
但这里有个诚实的提醒(我很欣赏作者主动说出来):
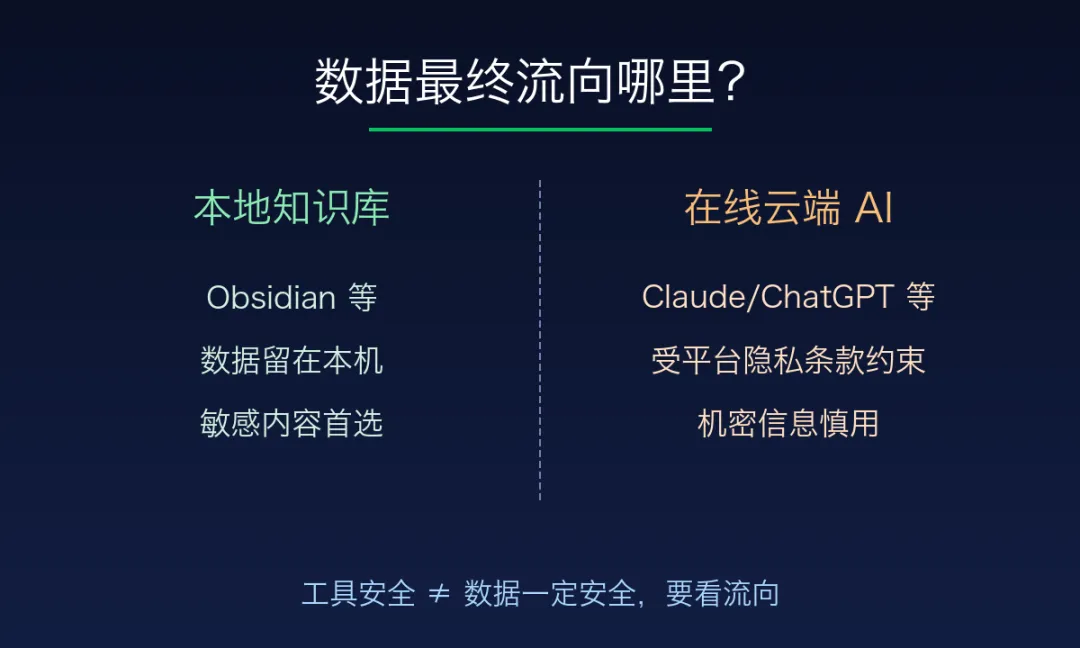
如果你转发给的是在线云端 AI(网页版 Claude、ChatGPT 等),数据进入模型后,就受各家大模型的隐私条款约束了——这一步已经出了微信流的地界。
>
如果你处理的是商业机密、敏感财务,建议用「沉淀到 Obsidian」,让数据完全留在本地离线知识库。
这一点特别重要——包括腾讯自家的 WorkBuddy,你把记录丢进去,也是上传到它的云端的。工具安全 ≠ 你的数据一定安全,要看数据最终流向哪里。
最后,它给了两个很硬的可验证证据:
- 代码 100% 开源
(MIT 协议)— 所有 Swift 源码、构建脚本、配置清单全部公开,任何人都能审代码 - 苹果官方公证
(Notarized by Apple)— DMG 用正规 Developer ID 签名,过了苹果的安全扫描
所以我的结论是:这套设计,是经得起推敲的。
牺牲了"全自动",换来的是"不碰风控、不碰隐私"——这个交换非常值。
五、给你三个实战工作流
讲完原理,说点能直接用的。
💡 先插一句:下面这三个场景,我自己跑下来觉得最值钱的不是"省时间",而是信息终于留存下来了——以前它们都死在微信里。
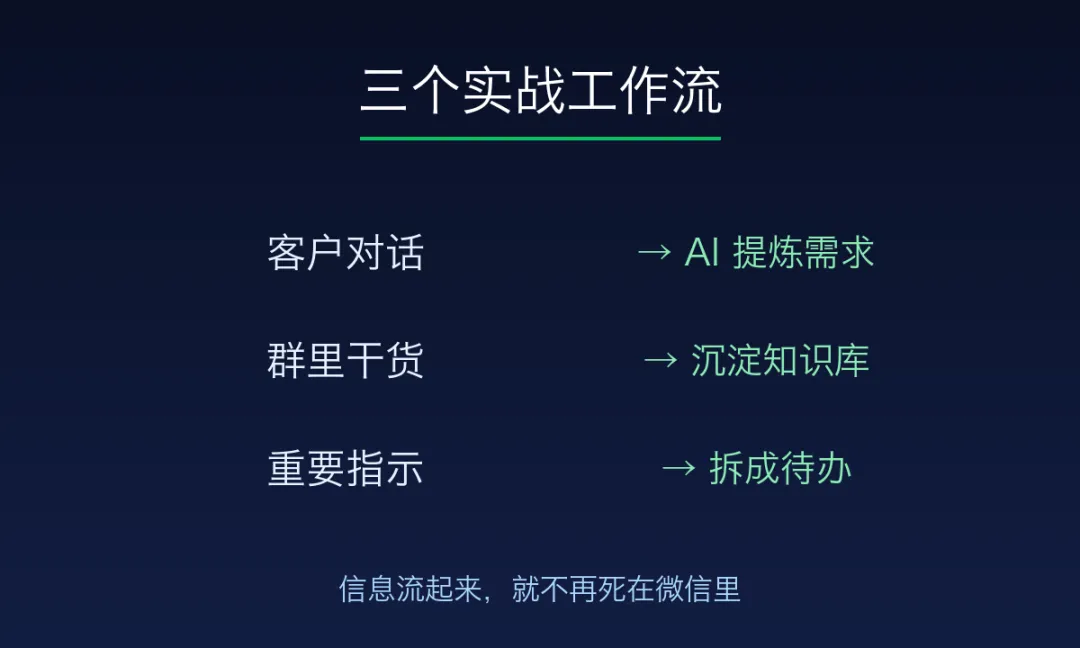
场景一:客户对话 → AI 分析
和客户聊完需求,多选聊天记录 → 合并转发 → 选「发给 Claude」→ 补充一句"帮我提炼成需求清单"。
AI 立刻拿着完整上下文开始干活,不用你再复述一遍。
场景二:群里的干货 → 知识库
看到群里讨论了一段特别有价值的方案,多选 → 转发 → 选「沉淀到 Obsidian」。
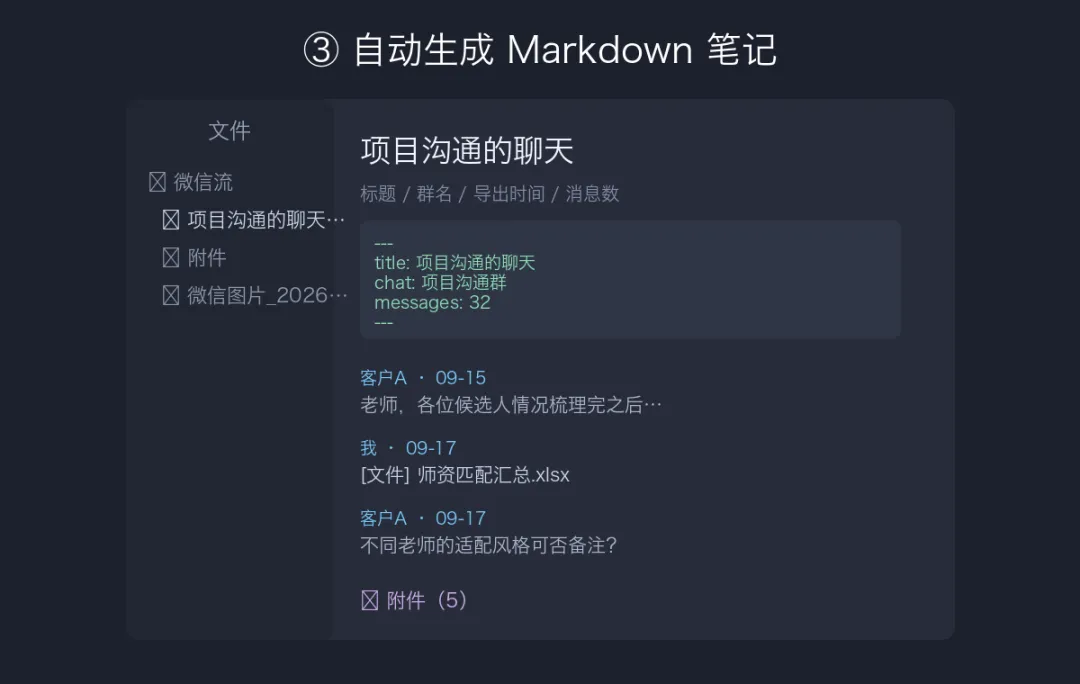
它会自动生成 Markdown 笔记,图片也一起存好,按聊天名归档。
半年后你想找"当时那个方案是怎么说的",搜索一下就有。
场景三:领导/同事的重要指示 → 待办
收到一条长长的任务安排,多选转发给自己常用的 AI,让它拆成待办清单。
从"我看到了一条长消息",到"我有一份可执行的清单",中间只隔一次转发。
六、进阶玩法:我把它接进了自己的工作流
上面三个场景是"手动版"。用顺手之后,我做了件更彻底的事:把它接进了自动化管道。
思路是这样的:
微信转发 → 微信流存成 Markdown
↓
【自动】按客户名分类归档
↓
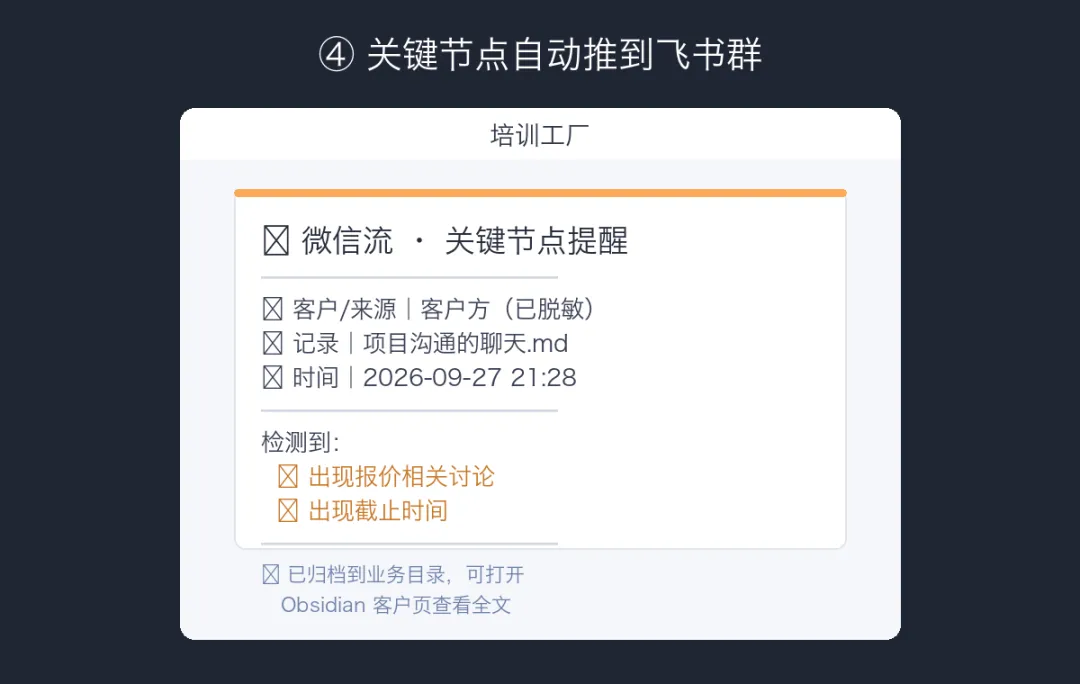
【自动】检测关键词(报价/签约/截止/催办…)
↓
【自动】命中就推送到飞书群提醒我
现在我的实际体验是:
和客户在微信聊完,记录自动归档到这个客户的文件夹 对话里出现"报价""签约""截止"这类关键节点,飞书群里立刻收到提醒 所有记录在知识库里自动按客户聚合,一页看全沟通史
这一层的价值,远大于"手动转发"本身。
因为它把微信从"信息黑洞",变成了你业务系统的输入端。
(这套东西我是基于微信流的本地输出 + 自己的自动化工具搭的,微信流负责"合规地把数据送出来",剩下的加工交给我自己的管道。)
七、几个高频疑问,一次说清
用之前我也攒了一堆问题,看了开发者本人的公开答疑,挑几个最有代表性的:
Q:它能不能自动?能不能定时导出?
不能,而且开发者明确说不会做。 原话是:"安全必须永远排在偷懒前面。"
想后台静默读消息,就必须去扫微信内存、硬解数据库——那正是风控盯得最死、抳到必封的重灾区。
宁可让你多做一次"框选 + 转发",也绝不为了省这两秒钟,拿你绑定了工作、人脉和钱包的微信号去赌。
Q:一次只能转 100 条?长聊天怎么办?
100 条其实是微信官方"合并转发"本身的上限,走正规系统分享,谁来都是这个数。
微信流做了两点优化:一是加了长按一键框选,省去一条条手点;二是你可以顺着时间分几次转出来,它在本地会自动按群名把几批记录拼成完整 Markdown,排版不乱。
(顺便说一句:那些宣称能"一键拉取群里过去一个月全量记录"的,全都得注入内存或破解数据库——随时被封的高压线。)
Q:图片、附件、语音能带出来吗?
文字、图片、视频都能完整导出,微信流会在本地解压并排好版插进 Markdown。
语音不行——官方导出的包里只有 Silk 格式的音频裸文件,没有转写文本。在微信官方没开放文本出口前,作者选择不做本地逆向解码。
Q:Windows 版?手机版?
Windows 版在全力赶工,核心链路已跑通,主要在死磕稳定性。
手机端(iOS/Android)暂时没有——因为移动端的沙盒隔离和分享管道限制更大,没找到像 macOS 这么优雅又合规的原生出口。“宁可慢一点,也不用危险方案冒险。”
Q:不想给"屏幕录制"权限,能用吗?
完全可以。 不给的话,只是导出的 Markdown 无法自动识别群名/好友昵称(改用时间戳命名),转发、解析、粘贴到 AI 这些核心流程照样跑。
Q:它和微信自带 AI / 腾讯 WorkBuddy 是什么关系?
解决两类不同的问题。
官方 AI 是在微信生态内做闭环(比如在聊天窗口直接总结);而微信流做的是开放的知识中继管道——把微信里的碎片信息,无缝喂给你真正顺手的外部工具:Claude、Codex、Cursor、本地大模型,或者直接落盘到 Obsidian 私有知识库。
官方把自家 AI 做好是好事,微信流专注把桥搭扎实。
Q:能拉全群或者别人的聊天记录吗?
只能导出你当前登录的微信里、由你自己亲手框选并点击转发的记录。
你在屏幕上能看到什么、主动勾选了什么,它就只处理什么,多一个字节都拿不到。
八、我自己的真实体验:它不是万能的
讲完官方信息,说点我亲自踩的:
坑一:部分 App 兼容性还在磨合。
比如某些基于 Electron 的 AI 助手,粘贴可能不生效(输入框处理方式特殊)。这时候可以先用「复制到剪贴板」兜底,或者换成 Obsidian 这类原生支持好的目标。
坑二:需要先手动框选。
如果你一次性要转上千条,得分成几批(受微信 100 条上限约束),不过它会自动拼接,体验上可以接受。
坑三:项目很新。
正式发布至今不久,还在快速迭代(比如 Windows 版、场景化功能都在路上)。但它的方向和边界是清楚的——对于一个处理你微信数据的工具来说,这一点比功能多寡重要得多。
结尾:工具的价值,是让你少当"人肉 API"
回到最开始的问题。
我们每天在微信里产生和接收大量有价值的信息,但这些信息大部分都死在微信里了。
不是因为我们不想整理,而是搬运成本太高——每一次从微信到外部工具,都要经过你这个人肉中转站。
好的工具,是让你从这个角色里解放出来。
微信流的思路其实很朴素:既然微信愿意把内容导出来,那我就把"导出来之后"这一段做好。
它不炫技,不越界,不承诺做不到的事。
但就这一件事,它做得刚刚好。
本文提到的「微信流」为 macOS 原生工具,苍何老师开源项目,支持微信 4.1.13 及以上版本。文中使用体验来自真实测试,已做匿名化处理。
📌 补充一句:如果你也想把微信里的碎片信息盘活,不妨先从一个场景开始——先从"客户沟通"或"群里的干货"挑一个,用顺手了再扩展。工具的价值,往往在用了两周之后才真正显现。
想让 AI 真正落到你的团队?
我是张号东-Brandon,专注 AI+HR 落地实践。
📖 知识星球「AI时代的HR」 —— 每周拆解一个 AI 落地实操案例
扫码加入,和 500+ HR 一起把 AI 用起来
💬 想聊聊你的具体场景? —— 加微信openclawhr(备注来源):
· 看了公众号文章 → 备注「公众号」
· 想了解企业培训 → 备注「培训」
· 想了解招聘/AI 人才 → 备注「招聘」