ARTICLE · 1094748
别再把需求目标一锅端扔给 AI,它会认真做成模糊软件
导读需求一句「做个登录」,Agent 会同时替你决定路由、存储、错误码、前端状态、邮件文案。每个决定单看都「合理」,合起来往往不是你想要的产品。
问题通常不在模型不够强,而在任务边界太糊。这篇给出一份可直接抄的五步任务书法:把整包需求切成 AI 能稳定做完、人能快速验收的小步。方法对齐 OpenAI / Anthropic / GitHub 的官方提示与 Agent 实践建议,不是某个模型的独门咒语。
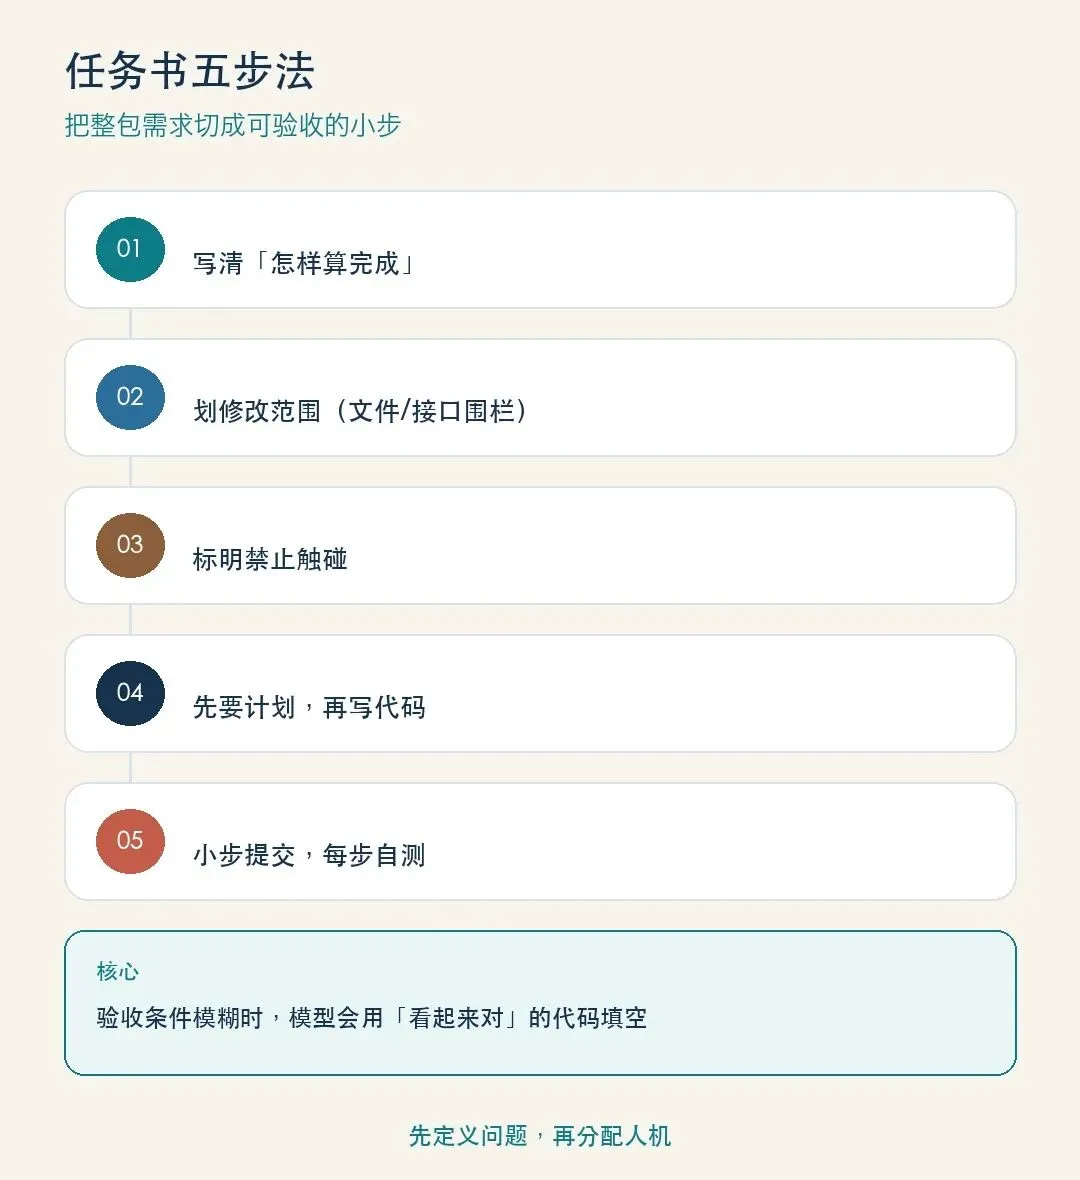
先说结论:AI 需要的不是更长的人设,而是工程上下文——完成定义、修改范围、禁止项、计划确认、小步合入。验收条件模糊时,模型会用「看起来对」的代码填空。
章节整包派活,错在哪
「做个登录」「优化一下性能」「把这个模块弄稳定」——这类指令对人是目标,对模型是自由度。
官方提示工程指南反复强调同一件事:指令要具体,约束要写清,成功标准要可检查(OpenAI Prompt Engineering Guide;Anthropic Prompt Engineering)。Agent 场景里这一点更致命,因为工具可以跨文件、改配置、动依赖。
整包派活时,模型被迫一次性发明:
●路由长什么样、错误码用哪套
●密码怎么存、session 放哪
●失败文案、限流规则、审计日志
●前端加载态与重试策略
这些决策若从未约定,你会得到一套「能跑的默认实现」。Review 时感觉处处别扭,又说不清哪句需求写错了。
章节五步任务书
第一步:先写「怎样算完成」
不要写「实现登录」。写可验证的完成定义:
输入邮箱密码,成功返回 session; 错误密码返回 401,文案固定为「邮箱或密码不正确」; 连续 5 次失败锁定 15 分钟。
完成定义的作用是给 Review 一把尺。没有尺,「看起来对」就是最高分。
第二步:划修改范围
只允许改:
auth/service.tsauth/routes.tstests/auth.test.ts禁止改数据库 schema 和对外 API 契约。
路径与接口就是围栏。GitHub Copilot 官方最佳实践也强调:给足相关文件与上下文,而不是整仓库倾倒。围栏窄一点,出错半径就小一点。
第三步:标明禁止触碰
禁止项常被省略,却是返工主因之一:
●不要升级依赖
●不要重命名导出函数
●不要改环境变量约定
●不要「顺手优化」无关模块
一句「禁止改数据库结构和对外 API」,比十句「请仔细一点」有用。
第四步:要求先出计划,确认后再写代码
先列出你打算改的文件和步骤,我确认后再写代码。
多数返工发生在它开始写之后。计划确认的成本远低于代码回滚。Anthropic 关于 Agent 工作流的建议也指向同一方向:把长任务拆成可观测、可中断的步骤,而不是一次黑箱生成。
第五步:小步提交,每步自己跑一遍
一个验收点,一次提交。例如:
1只做密码校验
2再做锁定策略
3最后补审计日志
整包 PR 的 Review 时间通常不是线性增长的。步子越小,「哪一步引入问题」越清楚。
章节一个改写对照
模糊版:
优化一下登录,性能不好,顺便把错误处理做好。
五步版:
【场景】用户反馈高峰期登录 p95 超过 300ms,主要耗时在 session 读取。 【约束】只改
auth/session.ts的读取路径;禁止改数据库结构与对外 API。 【验收】p95 ≤ 200ms(本地压测脚本scripts/load_login.py);错误路径行为不变。 【输出】先给改动计划(文件+步骤),确认后再改代码;小步提交。
第二段不是更「聪明」,只是把模糊目标翻译成可验收合同。你没有写更多字,却写清了边界与完成标准。
章节给 AI 的任务书模板(可抄)
【场景】用户在什么情况下遇到什么问题
【约束】只允许改哪些文件/接口,禁止改什么
【验收】怎样算完成(可执行的检查)
【输出】先给计划,确认后再写代码
四段通常不超过 15 行。比两千字的角色扮演提示词更稳。Agent 需要工程上下文,不是人设。
章节合并前:五个检查点
任务书写好仍不够。Review AI 代码时,我只盯这五件事:
1越界改动:说好只动 A,是否动了 B
2错误路径:不只看 happy path
3测试真实性:测试是否和实现一起错
4隐性变更:配置、依赖、权限有没有被悄悄改
5可回滚性:出问题能不能一键回回滚
格式、命名、微优化交给工具。Review 的目标不是证明人比 AI 强,是防止「看起来对」的代码进主干。
章节适用边界
适合: 边界清楚、可测试、改错能回滚的中低风险代码——CRUD、局部重构、测试补写、脚本与工具函数。
默认不交给 Agent: 安全边界(鉴权、权限、加密)、资金/账务、不可逆数据迁移、生产事故紧急修复。不是模型写不出来,是这些位置的验证成本远高于编写成本。
也别一刀切: 三行改动不值得四段文书。任务书的价值在「决策点变多、出错代价变大」的任务上;越界保护过严时,允许 AI 在计划阶段申请扩大范围,由人批准。
章节一页清单
●完成定义可验证
●文件/接口范围写死
●禁止项写死
●计划先过目
●小步提交,每步自测
●高验证成本代码不由 Agent 终审
章节最后
编码仍然重要,但「定义问题」会更贵。Agent 会忠实地把模糊需求做成模糊软件——它放大了「不会拆问题」的短板,也奖励能把问题切成可验证小步的人。
你有更顺手的任务书结构,欢迎在评论区贴出来。
章节参考资料
1OpenAI Prompt Engineering Guide
2Anthropic Prompt Engineering Overview
3Anthropic — Building Effective Agents
4GitHub Docs — Best practices for using GitHub Copilot