ARTICLE · 1094741
开源模型下载全攻略:HuggingFace、ModelScope、魔搭怎么用
开源模型下载全攻略:HuggingFace、ModelScope、魔搭怎么用
本地部署大模型,第一道坎往往不是显存,是下载。
国内直连 HuggingFace,经常几 KB/s,或者下一半断了、重下又从零开始。一个 7B 模型 14GB,能耗掉你一整天。
这篇给全套方案:镜像站、ModelScope、多线程加速、断点续传、离线搬运。可直接复制命令,不讲原理,只讲怎么下得快、下得稳。
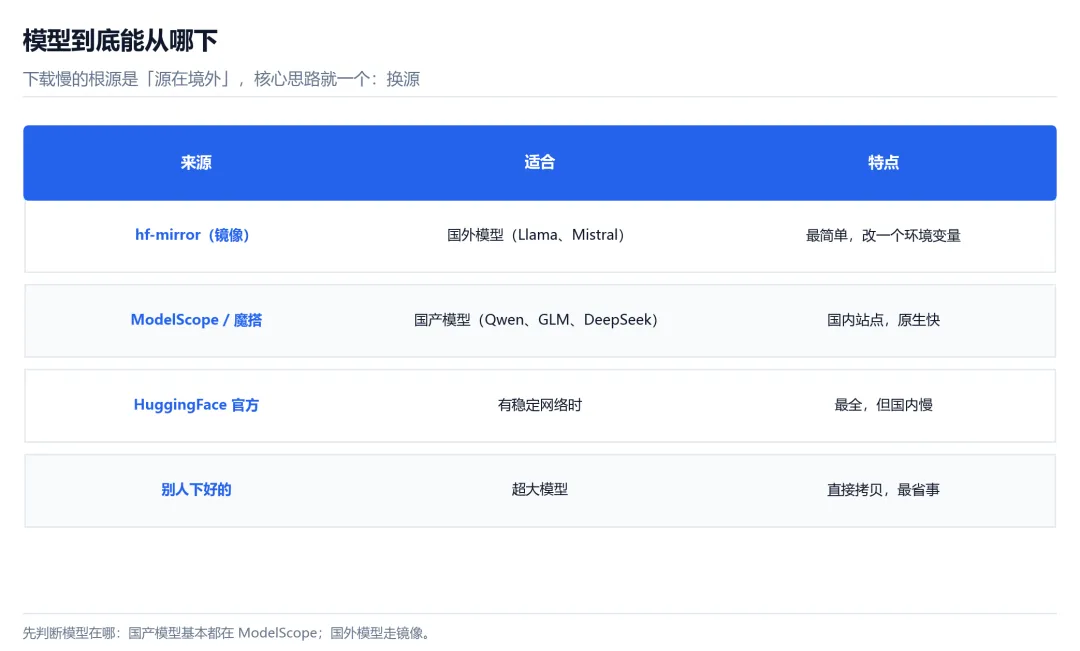
一、先搞清:模型到底能从哪下
下载慢的根源是"源在境外"。所以核心思路就一个:换源。
| hf-mirror | ||
| ModelScope / 魔搭 | ||
| HuggingFace 官方 | ||
| 别人下好的 |
先判断你要下的模型在哪:国产模型(Qwen/GLM/DeepSeek)基本都在 ModelScope 有;国外模型(Llama/Mistral)走镜像。
二、方案一:换镜像站(最简单,先试这个)
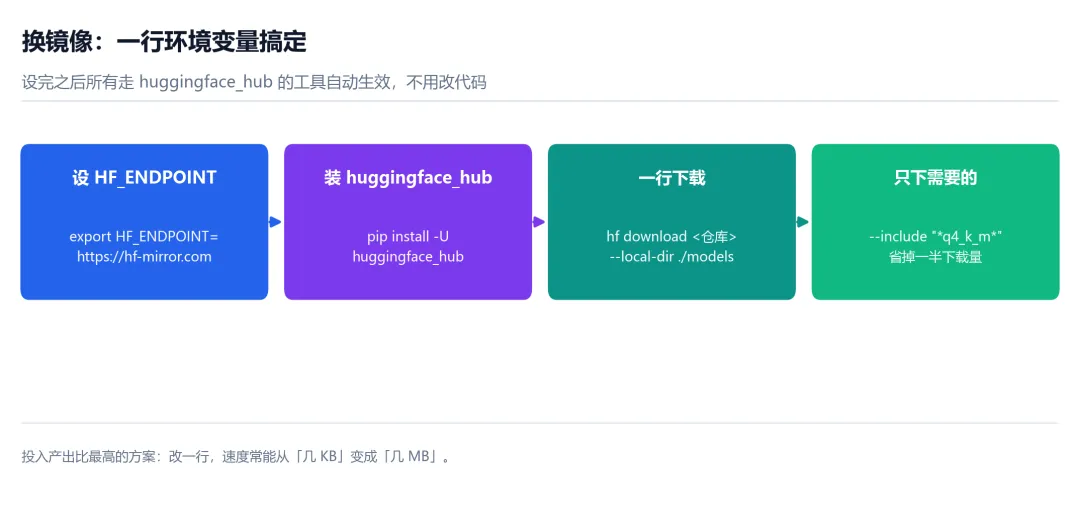
hf-mirror 是一个公益镜像项目,把 huggingface.co 镜像到国内。用法就是设一个环境变量:
# Linux / macOSexport HF_ENDPOINT=https://hf-mirror.com# Windows PowerShell$env:HF_ENDPOINT = "https://hf-mirror.com"
设完之后,所有走 huggingface_hub 的工具都会自动走镜像——包括 transformers、diffusers、huggingface-cli。不用改任何代码。
下载命令(新版 CLI 是 hf,老版是 huggingface-cli):
pip install -U huggingface_hub# 下载整个仓库到指定目录hf download Qwen/Qwen2.5-7B-Instruct --local-dir ./models/qwen2.5-7b# 只下部分文件(比如只下 4-bit 量化版)hf download Qwen/Qwen2.5-7B-Instruct-GGUF --include "*q4_k_m*" --local-dir ./models
这是投入产出比最高的方案:改一行,速度就能从"几 KB"变成"几 MB"。
三、方案二:国产模型直接用 ModelScope
国产模型在魔搭(ModelScope)是原生托管的,不用绕镜像:
pip install modelscope# 下载模型modelscope download --model Qwen/Qwen2.5-7B-Instruct --local_dir ./models/qwen2.5-7b# 下载数据集同理modelscope download --dataset <数据集id> --local_dir ./data
代码里也能直接换:把 from_pretrained("Qwen/Qwen2.5-7B-Instruct") 换成指定 ModelScope 的加载方式即可。
建议:国产模型优先用 ModelScope,国外模型用 hf-mirror。 两条路都配好,基本不用再为下载发愁。
四、方案三:多线程加速
如果镜像还是慢,可以开多线程下载。官方有个 hf_transfer 工具:
pip install hf_transfer# 开启后,下载会走多线程export HF_HUB_ENABLE_HF_TRANSFER=1hf download Qwen/Qwen2.5-7B-Instruct --local-dir ./models/qwen2.5-7b
注意:多线程会吃满带宽,公司/宿舍网络可能被限速,反而更慢。先试单线程,慢再开。
五、断点续传与离线搬运(大模型必看)
大模型下载最怕"下到 90% 断了"。 好消息是:huggingface_hub 和 modelscope 默认支持断点续传——重新执行同一条命令,它会从断的地方继续,不会从头再来。
如果网络实在不稳,用"离线搬运"这招:
在一台网络好的机器(或云服务器)上把模型下好; - 打包时排除临时文件
( .cache、*.incomplete),只留模型文件; 用 U 盘/移动硬盘/内网拷贝到目标机器; 放到目录里,加载时用本地路径( ./models/qwen2.5-7b)而不是仓库名。
# 打包时排除半成品文件tar --exclude='*.incomplete' --exclude='.cache' -czf model.tar.gz ./models/qwen2.5-7b
这一步能省掉大量等待——尤其当你有多台机器要部署同一个模型时。
六、方案怎么选
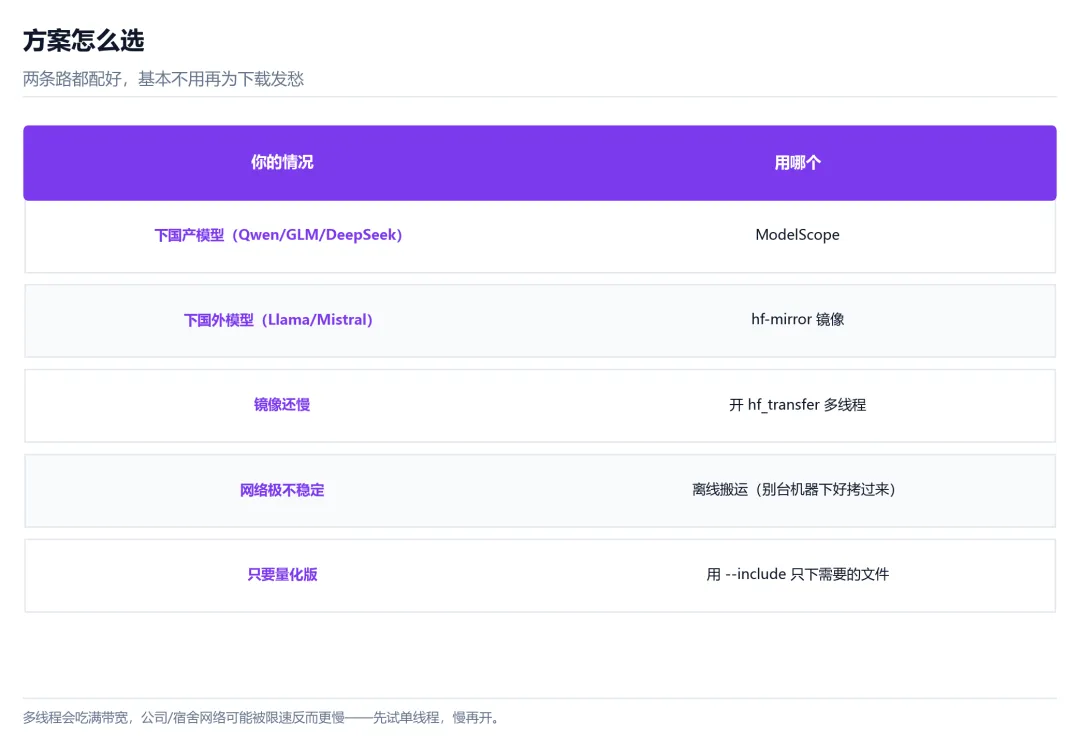
| ModelScope | |
| hf-mirror 镜像 | |
hf_transfer 多线程 | |
--include 只下需要的文件 |
两条实用建议:
- 只下你需要的文件。
一个模型仓库里常有好几种格式(FP16、GGUF、AWQ)。用 --include过滤,能省掉一半以上的下载量; - 下之前先看仓库文件列表。
有些模型分多个文件,别漏了下 tokenizer或config.json。
七、卡住时的排查顺序
- 下载慢
→ 先确认 HF_ENDPOINT生效了没(很多人的问题是环境变量没生效); - 下到一半断
→ 重新执行同一条命令,会自动续传; - 报 401 / 403
→ 模型需要授权(如 Llama 系列),先去官网同意条款并配 token; - 磁盘不够
→ 先看模型文件总大小,FP16 的 7B 就要 14GB; - 下载完加载报错
→ 检查文件是否完整(有没有漏 config.json/tokenizer); - 反复失败
→ 换 ModelScope,或走离线搬运。
最后一句:下载不是技术难题,是网络问题——而网络问题都有现成解法。 把"镜像 + ModelScope + 断点续传"这三件事配好,你以后下任何模型都不会再卡在这一步。别把时间浪费在等待进度条上。
说明:文中镜像站(hf-mirror)、ModelScope 均为公开可用的第三方/官方服务,其可用性、限速策略与使用条款以各站最新公告为准;请遵守相应服务条款与模型许可证。命令中的 CLI 名称(
hf/huggingface-cli)随huggingface_hub版本变化,请以官方文档为准。