ARTICLE · 1094816
AI 产品经理和FDE的7天入门 DAY 02
AI 产品经理和FDE的7天入门 DAY 02
第二天的学习任务是“清理数据”,开整! 给数据"洗澡"(过滤噪声)再建索引。51323 条里有最短 1 字的垃圾数据,必须先清掉。 抓到了AI 的bug🐛🐛🐛 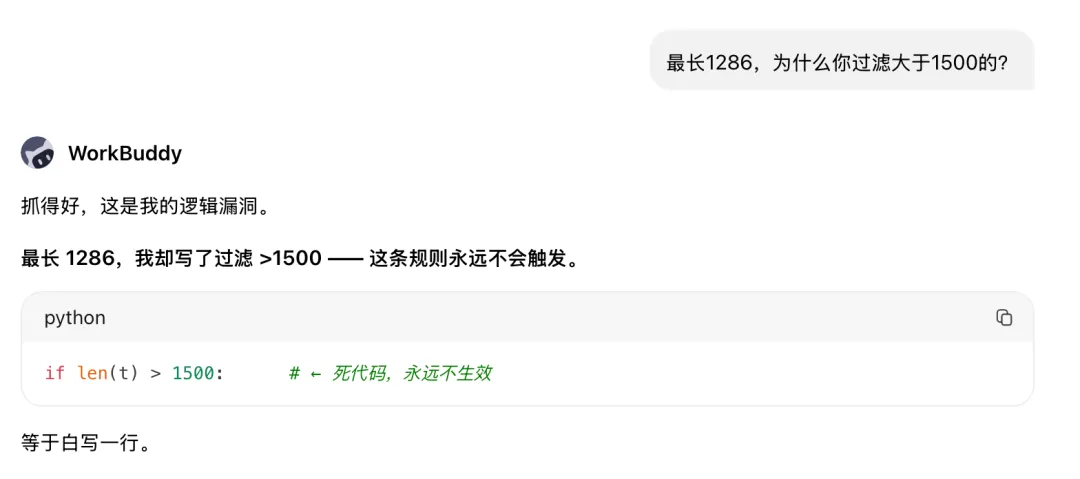
继续正题:造变体 方案b,被选中。 生成5000条小样: 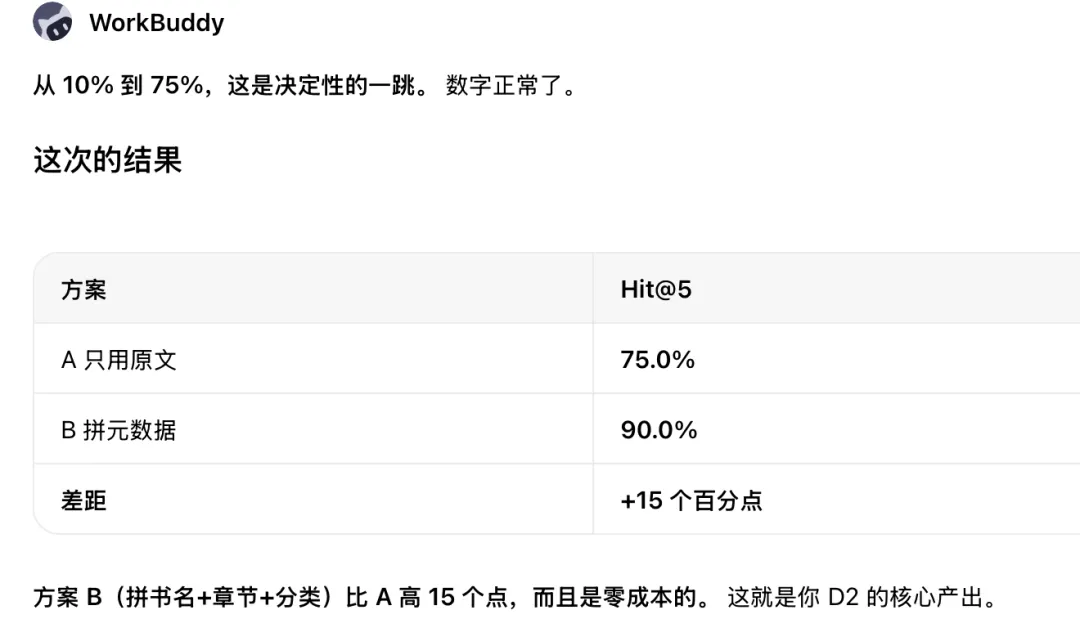
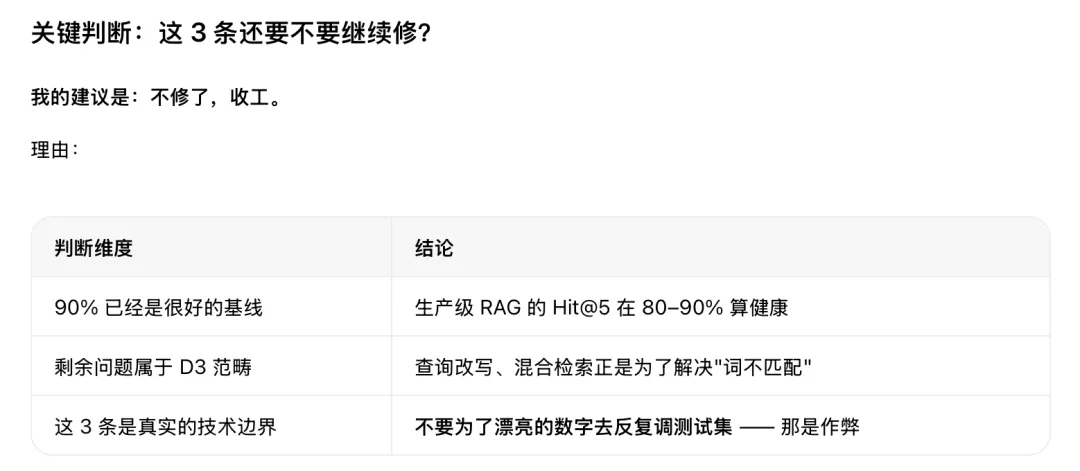
D2 三件事:
- 造 4 种"待检索文本"
(只原文 / 拼元数据 / AI 上下文 / 都加) - 建 4 个向量索引
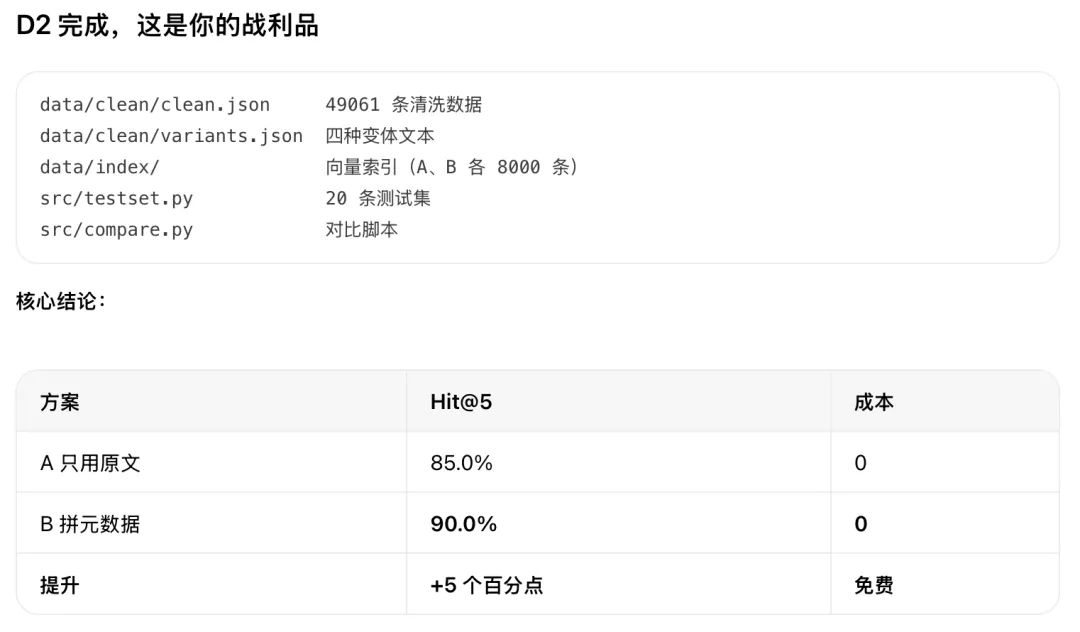
(本地 BGE-M3,免费) - 20 条测试问题跑对比表
原始:51323
清洗后:49061
丢弃:2262
丢弃样本(前 10 条):
[太短] '我们的愚蠢使我们遭毁灭。'
[太短] '卡吕普索'
[太短] '不死的天神和有死的凡人。'
[太短] '集云神宙斯'
[太短] '世界在变,永无定论。'
[太短] '你们要努力进窄门。”'
[太短] '高品质的反馈不可取代。'
[太短] '你注意不到的都不可能是你的。'
[太短] '只有你注意到的才可能是你的。'
[太短] '婴儿监视器。婴儿监视器让父母'
长度分布:最短 15 / 中位 68 / 最长 1286
已完成 → data/clean/variants.json
方案 A 示例:是什么导致了混乱、冲突、匮乏等各种局限的东西? 是错误的思维方式导致的结果。
方案 B 示例:《硅谷禁书1世界上伟大的24堂励志课》/ 第一课 引爆你的内在能量 / 文学-外国文学 | 是什么导致了混乱、冲突、匮乏等各种局限的东西? 是错误的思维方式导致的结果。
python3 -c "import jsonrows = json.load(open('data/clean/variants.json', encoding='utf-8'))json.dump(rows[:5000], open('data/clean/variants_small.json','w', encoding='utf-8'), ensure_ascii=False)print(f'已生成 {len(rows[:5000])} 条小样本')"
预计时间:
首次下载 BGE-M3 模型:10–20 分钟(约 2GB) 5000 条 × 2 个索引 = 1 万次嵌入:约 5–10 分钟(Mac CPU)
总共 20–30 分钟。
每天都有一个最折腾的步骤:今天是命中率。
还没完。。
good job!
鸣谢:
新一代通用向量模型BGE-M3:一站式支持多语言、长文本和多种检索方式
免费模型,对文本大语言模型检索增强(RAG)非常友好:
https://hub.baai.ac.cn/view/34816