ARTICLE · 1096275
AI让软件定制不再是程序员的专利
鞋子里的沙子:一次开源软件个性化定制的完整复盘开源软件 + AI,让个性化定制不再是程序员的专利
鞋子里的沙子:一次开源软件个性化定制的完整复盘
7 PARTS + CONCLUSION
👉 滑动
PART 01
先说背景:上一次,我给开源项目「换过发动机」
PART 02
这粒沙:Memos 的二级菜单
PART 03
第一步:让 AI 通读工程,找到菜单在哪
PART 04
第二步:让 AI 评估风险,制定修改方案
PART 05
第三步:设计部署方案——代码改完,怎么跑起来?
PART 06
第四步:形成补丁手册,防止「回潮」
///
复盘:普通人定制开源软件的四步法
THE END
你有没有过这种体验——
一个操作,明明只多了一步。点两下和点三下,听起来没什么差别。
但如果这个动作,你一天要做几十次,一年要做上千次呢?
就像鞋子里进了一粒沙。单看微不足道,可你还要穿着它走完一整天的路——每一步都在提醒你:它在那儿。
今天要聊的,就是我是怎么把这粒沙倒出来的。顺便,再聊一次开源软件的好处。
01
PART
先说背景:上一次,我给开源项目「换过发动机」
之前我写过一篇文章,讲我帮开源项目 Ignis 做的一次升级:它的底层依赖跨了 8 个版本没更新,作者没精力升,我就用 vibe coding 的方式,把版本一路拉到了最新。
👉 没读过的朋友可以补补课:《给老车换新发动机:一次跨 8 个版本的升级,只坏了 3 处》免费开源:最新浏览器版的Obsidian
代码提交之后,作者把我和另外一位开发者,一起写进了项目的贡献者名单。
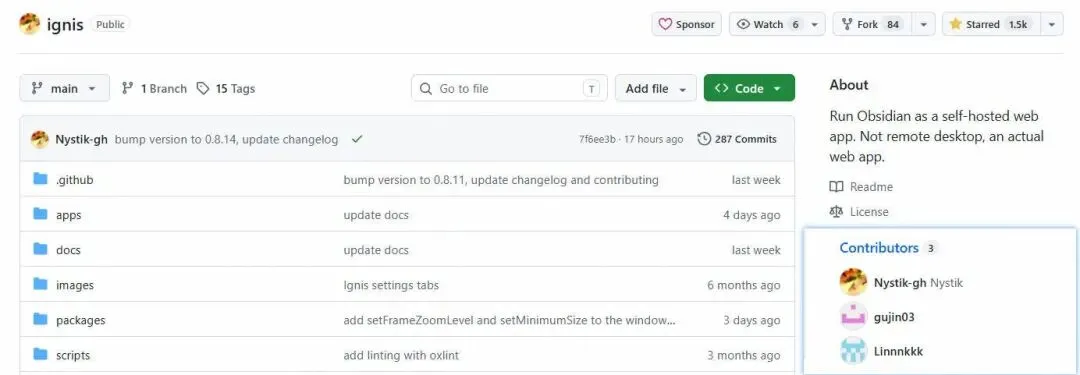
这就是开源软件的好处。
在源码开放的情况之下,只要你具备基础的软件知识,你就可以站在自己需求的基础上,对软件做个性化的定制开发——不用等作者排期,不用求官方更新,自己动手,丰衣足食。
今天再分享一则案例。
02
PART
这粒沙:Memos 的二级菜单
先介绍下主角。Memos 是一款开源的轻量级备忘录软件,类似自建版的「flomo」。我是它的重度使用者——日常工作里的想法、待办、片段笔记,都往里面扔,而且频繁在网页端直接更新。
痛点出在 0.31 这个版本。
作者升级之后,给备忘录的操作菜单加了一层「二级菜单」:以前,「删除」就明晃晃地摆在一级菜单里,点一下就到;现在,你得先点「更多」,等子菜单弹出来,再去选「删除」。
多出来的这一步,看似微不足道。但在高频使用之下,就会显得阻力十足——就像鞋子里的沙子,很硌脚。
我的需求很明确:把二级菜单里的「删除」,重新提升为一级菜单。
对官方来说,这可能是个「众口难调」的取舍(菜单项太多,一级放不下);但对我自己来说,需求真实存在。好在——它是开源的。
下面这四步,就是我这次的完整路径。
03
PART
第一步:让 AI 通读工程,找到菜单在哪
很多人对「改开源软件」的第一反应是:源码几十上百万行,我怎么可能看得懂?
其实不用你看。这一步的核心动作是:把源码拉下来,让 AI 通读整个工程。
操作很简单:
git clone --depth 1 --branch v0.31.0 https://github.com/usememos/memos.git
然后把整个工程喂给 AI,让它带着问题读:「网页端备忘录的操作菜单,是哪段代码渲染的?」
几分钟之后,AI 给出了定位:菜单源码在 web/src/components/MemoActionMenu/MemoActionMenu.tsx 这个文件里,二级菜单的结构、每个菜单项的位置,清清楚楚。
原来「看懂一个项目」的门槛,已经被 AI 大幅拉低了。你要做的不是逐行读代码,而是会提问、会验收。
04
PART
第二步:让 AI 评估风险,制定修改方案
找到了位置,是不是就可以撸起袖子直接改了?
不行。这一步偷懒,后面一定加倍偿还。
我让 AI 做了两件事:
一是评估改动范围和风险。 AI 分析后给出结论:整个改动只涉及 3 处,全部在前端展示层——
| MemoActionMenu.tsx | ||
| .dockerignore | ||
| scripts/Dockerfile.full |
关键是那句风险评估:不涉及任何后端 Go 代码、数据库迁移或 API 变更。也就是说,数据层原封不动,改动面被牢牢锁死在「界面长什么样」这个层面,风险可控。
二是制定具体的修改方案。 不是「大概改一下」,而是明确到:哪个文件、删哪段代码、加哪个菜单项、连带清理哪个不再使用的图标导入。
先方案、后动手——这是 vibe coding 不翻车的第一原则。
05
PART
第三步:设计部署方案——代码改完,怎么跑起来?
这是很多人容易忽略的一环。这个仓库是通过容器(Docker)部署的,改完源码不等于完事,还得把新代码构建成镜像、替换线上正在跑的容器。
我让 AI 针对我的服务器环境,设计了完整的部署方案。这一步踩了一个真实的坑,也做了一个关键的护栏:
坑:构建报错 ERR_PNPM_LOCKFILE_CONFIG_MISMATCH。 排查发现,新版 pnpm 把补丁依赖的声明挪到了 pnpm-workspace.yaml 里,而构建脚本漏拷了这两个文件。补上之后,构建一次通过——耗时 6 分 24 秒。
护栏:小内存服务器也能构建。 我的服务器只有 1.9G 内存,直接构建很容易把服务挤爆。AI 在 Dockerfile 里内置了两道内存护栏:前端构建阶段限制 Node 堆内存 1G,后端编译限制并发数。实测构建全程服务不中断。
上线前还有一道保命动作——备份数据库:
sqlite3 memos_prod.db ".backup /root/backups/memos_prod.db"
注意这里用的是 SQLite 的 .backup 命令而不是直接复制文件——数据库正在运行时直接拷贝,很可能拷出一个损坏的副本。这种细节,AI 都会替你考虑到,但你得知道要问。
最后,把配置文件里的镜像名一换,一条 docker compose up -d,新版上线。打开网页验证:版本横幅显示 Memos 0.31.0-menu,点开菜单——「删除」回来了,就躺在一级菜单里。
一粒沙,倒出来了。
06
PART
第四步:形成补丁手册,防止「回潮」
定制开源软件有个绕不开的隐忧:官方一升级,你的改动怎么办?
下次官方发布 0.32、0.33,如果你拉取新版源码重新构建,定制就没了——这叫「回潮」。总不能每次升级都从头再改一遍吧?
所以我让 AI 做了最后一步,也是我最满意的一步:把整个修改过程,固化成一份可重放的补丁手册。
核心是一个补丁脚本,设计上有三个讲究:
语义锚点定位
不依赖代码行号(行号随版本必然漂移),而是按代码的「语义结构」找到该改的位置,新旧版本通吃;
拒绝盲改
脚本内置断言,如果新版代码结构变了、它认不出来了,立即中止、一个字都不动——宁可停下来让人工介入,也不把源码改坏;
自动判定「官方已实现」
万一哪天官方自己把这个功能做了,脚本会识别出来并告诉你「不用打补丁了」——这正是我们乐见的结局。
以后官方出新版本,流程就三条命令:拉新代码 → 跑补丁脚本 → 重新构建。几分钟的事。
这份手册还配了完整的回滚方案:升级前备份,随时可以退回原样。
///
LAST
复盘:普通人定制开源软件的四步法
把这次的路径抽象一下,就是一个可复用的四步框架:
通读:下载源码,让 AI 通读工程,定位目标代码在哪;
评估:让 AI 评估要改哪些文件、风险点是什么,先出方案再动手;
部署:结合自己的运行环境,让 AI 设计构建与上线的具体方案;
固化:验证通过后,把改动整理成补丁手册,版本升级可重放,避免回潮。
你会发现,四步里 AI 干了所有的「重活」——读代码、写代码、排报错、写脚本。而你负责的,是提出真实的需求、验收每一次改动、以及在关键节点上做判断。
孟晚舟在一次演讲里说过:
「下厨房」的过程是枯燥的,但只有亲自完成每一道工序,才能掌握佳肴的秘方。
AI 替你掌勺,但火候的判断、味道的验收,还是你的。跳过这些「枯燥的工序」,AI 就只是一个漂亮的摆设。
开源软件 + AI,正在把「个性化定制软件」这件事,从程序员的专利,变成每一个普通用户的日常能力。
这就是这个时代给我们的红利。创造力,说到底就是对自身能力的驾驭和拓展——工具越强大,越要看清自己能驾驭多少、还差多少。源码开放,意味着你不是软件的「租客」,而是可以按自己的喜好重新装修的「业主」。
下一粒沙出现在鞋子里的时候,希望你也有把它倒出来的底气。
我是 刘顾问,关注我,我们一起学习、共同成长。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING