ARTICLE · 1096269
大兵解读AI+软件时代,智能编程怎么重做产研交付
谷歌CEO皮查伊今年4月在Google Cloud Next大会上说了个数,谷歌内部近75%的新增代码由AI生成,人类审核通过。
这个数字背后有一条陡峭的时间线。两年前是15%,一年前25%,半年前50%,现在75%。
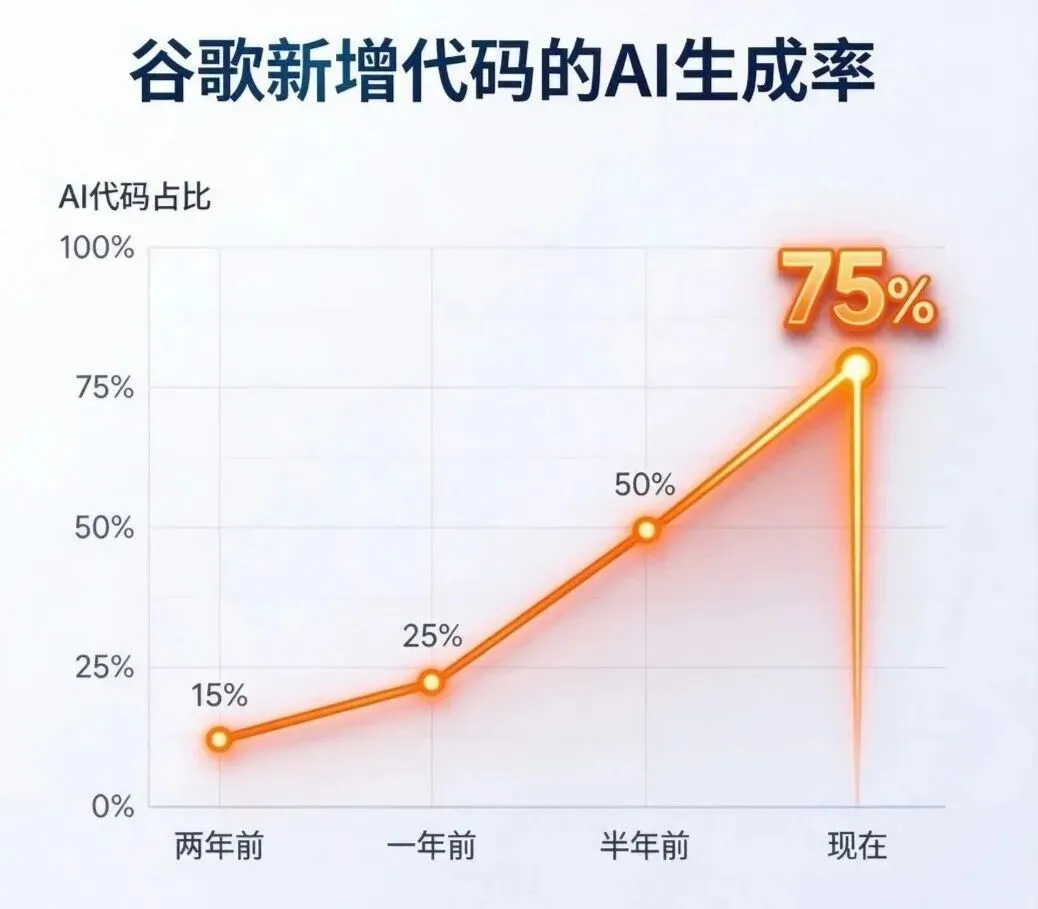
这个斜率,放在任何行业都是峭壁。 软件行业用了七十年的生产方式,斜率突然变了。
但马上反转。Sonar《2026开发者现状调查》给了另一组数,72%的开发者每天在用AI编程工具,42%的代码由AI生成或辅助,可96%的开发者,并不完全信任这些AI写的代码。
代码可以无限生产,谁来签字? 这是2026年软件行业最大的悬案。
工信部9月刚发的《"人工智能+软件"专项行动实施方案》,给这场变革又踩了一脚油门,两年内把智能编程工具铺到2万家规模以上软件企业,组织100项智能化技改。
政策已经下场。但大部分软件公司的产研流程,还停留在"买了个插件"的阶段。
这篇文章不谈概念。谈智能编程怎么把需求、评审、测试、发布、岗位、人效这套东西,整个掀过来。
第1章 政策拆解:软件生产端三句话,句句要命
先看文件本身。《"人工智能+软件"专项行动实施方案》,工信部信发〔2026〕209号,9月2日印发,上一篇贴图文章进行了解读。
它是国务院《关于深入实施"人工智能+"行动的意见》的行业落地细则。国务院文件是"面",讲六大领域;工信部209号文是"线",把软件单独拎出来,给出可考核的数字。
顶层定方向,部委定指标,地方抓落地。 这是典型的政策操作节奏。
落到第二部分"推进软件生产变革",就三句话。
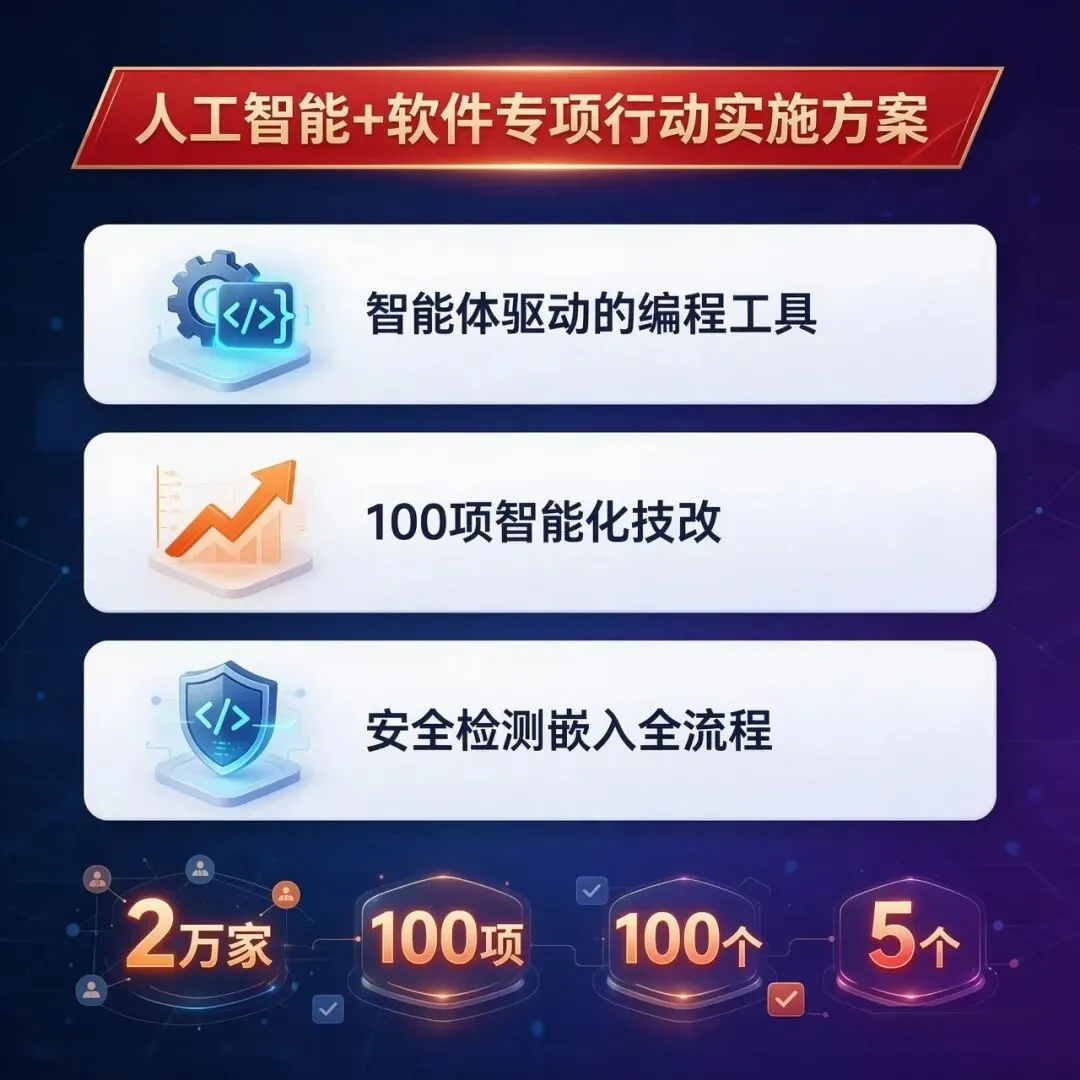
第一句,工具链。"发展智能体驱动的智能编程工具,提升项目级、全流程的自主开发能力。"官方第一次把"智能体"和"编程工具"写进同一句话,还要求与代码托管平台、云服务、开源社区深度适配。
潜台词很清楚,不能全靠Cursor和Copilot。国内市场其实已经"四分天下",腾讯CodeBuddy约28%、阿里通义灵码约26%、字节Trae约24%、百度文心快码约22%,一套自主可控的工具梯队正在成形。
第二句,技改。 支持有条件的地方组织软件企业智能化技改,而且特意强调"以代码质量、研发效益等智能编程应用实效为重要依据"。
注意这句话的分量。政策在纠偏,防的就是"只看代码生成率、代码行数"的歪路。后面我会讲到,这条歪路正在害人。
第三句,安全。"对存量软件实施漏洞挖掘、缺陷自动识别和风险分级评估","将智能安全检测嵌入软件开发全流程"。
AI写代码越快,安全债积累越快。政策提前把"安全"和"提效"绑在同一根绳上,不让企业为了赶进度裸奔。
配套的硬指标也摆在这,到2028年,智能编程工具覆盖2万家规上软件企业,100项技改项目,100个智能体软件标杆应用,5个以上优质开源项目。到2030年,关键软件全面实现智能化升级。
政策给的是方向,不是药方。药方,得每家软件公司自己开。
第2章 反常识现场:写代码快了10倍,交付只快18%
三个反常识的现场,先摆出来。
现场一,提效卡在20%上不去。
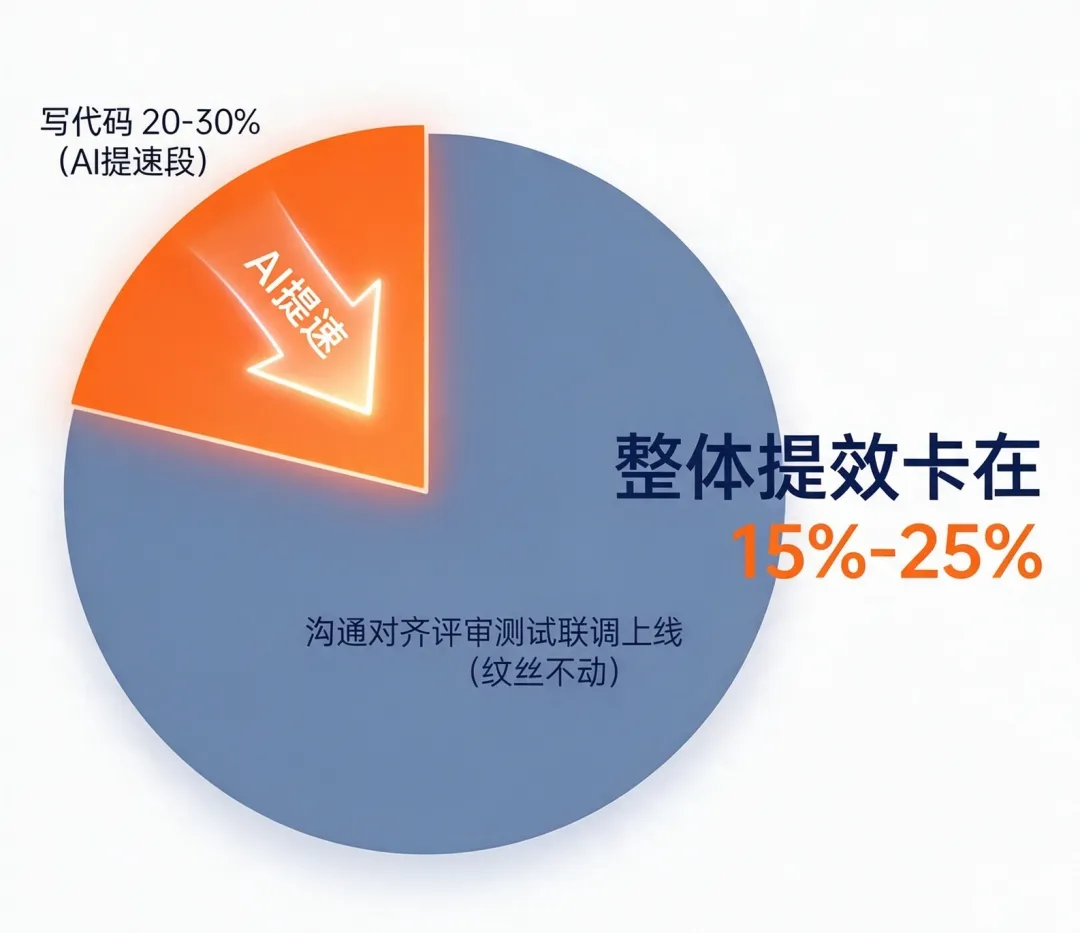
复旦大学的茹炳晟点破过一个要害,企业级研发里,真正写代码的时间只占20%到30%。AI把这一段提速了,沟通、对齐、评审、测试、联调、上线一样没少。
所以整体提效卡在15%到25%。
腾讯的数据更直白,九成员工在用编程助手,编码时间缩短了40%,但整体研发提升只有20%。写代码快了,工程没快。
快手的沈浪区分了两道鸿沟。个人提效不等于团队提效,团队提效不等于组织提效。他的团队花了一年才想明白这件事。
我一年前也信过"AI让研发效率翻倍"那套说法。后来我们把它铺到一个流程混乱的小组,交付反而更慢了。AI不修复团队,它暴露团队。
现场二,96%的人不敢签字。
Sonar每天分析7500亿行代码。他们的调查里有一组扎眼的矛盾,72%的开发者每天用AI,42%的代码由AI生成,96%的开发者却无法完全信任AI代码。
还有35%的开发者,绕过企业授权工具,用个人账号干私活。行业管这个叫"影子AI"。
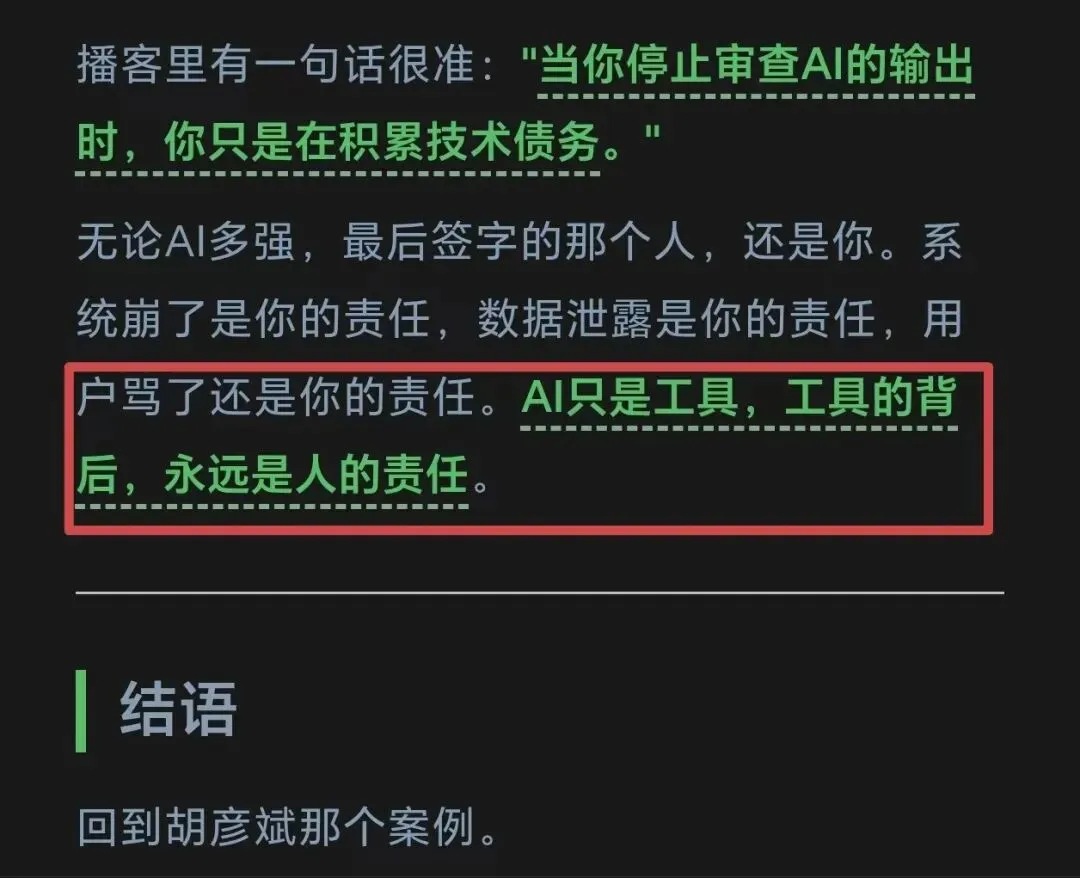
最要命的一层,AI把写文档、写测试这些低效活干掉了,但"逐行核验AI代码"成了新的低效活。AI不为质量负责,责任全落在签字上线的人身上。
我在以前的文章「大兵聊Vibe Coding:这场AI编程革命,到底革不掉什么?」,也专门提到这一点。
现场三,Cursor估值600亿。
2026年8月14日,SpaceX以约600亿美元估值完成对Cursor母公司Anysphere的收购。一家做代码编辑器的公司,估值达到600亿。
GitHub Copilot付费用户突破1500万,年化收入约18亿美元。昆仑万维CEO方汉披露,公司每月消耗1万亿到1.2万亿token,人均每月约700元。这相当于20个人的成本,换来研发速度提升50%以上。
这一轮没有泡沫。 泡沫只存在于一种叙事里,"以后不需要工程师了"。真金白银都花在"怎么让人类更可靠地使用AI"上。
AI把写代码的手艺废了,但没给你新的梯子。 新的梯子在哪?先看交付链路怎么被重写。
第3章 交付链路五环节,每一环都被重写
产研交付就五步,需求、写码、评审、测试、发布。五步里,每一环的玩法都变了。
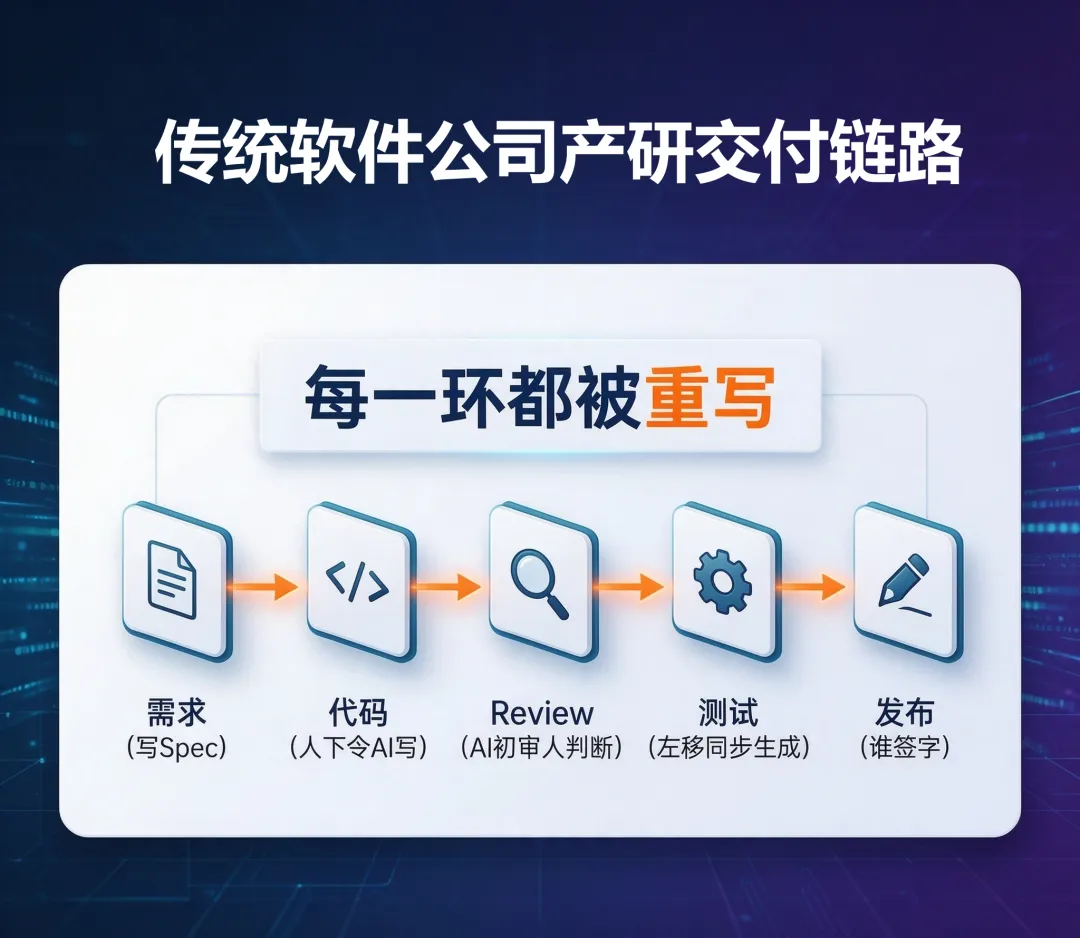
▍3.1 需求怎么拆:从"写PRD"到"写Spec"
腾讯云CodeBuddy 2.0升级时做过一次"吃狗粮"实验,按大厂传统要一年的架构级演进,4名工程师4个月完成,99%的代码由AI生成。
前置条件只有一条,把需求拆成可执行规格。
微软Spec Kit把开发拆成五步,宪章、需求、架构、任务、实现。逼着AI敲第一行代码之前,先有可执行的规格。
工程师天然抵触写Spec,因为它逼人把模糊需求想清楚。腾讯云的办法是"吃狗粮小群"强制执行,边做边补。
模糊的需求喂给AI,AI只会用前所未有的速度把模糊甚至是错误写出来。
▍3.2 代码怎么写:从"人写AI补"到"人下令AI写"
OpenAI的Codex论文里有一组数,重度用户一周同时管理5个以上Agent,最头部的1%用户,一天累计跑约71小时Agent任务。提交超过8小时人类工作量任务的用户比例,一年内涨了近10倍。
写代码这件事,正在从"人写AI补"变成"人下令AI写、人验收"。
但有个细节极重要,"第一行代码"决定一切。
论文《Security Degradation in Iterative AI Code Generation》做了个实验,400个样本迭代40轮,仅仅5轮之后,关键安全漏洞就激增了37.6%。Salesforce的研究员发现,对话轮次增加后,模型的逻辑表现平均跌39%。
方向歪了,AI会以前所未有的效率跑偏。 所以"代码品味"必须工程化,腾讯云管这个叫"品味不变式",一个模块只做一件事,不过度设计,错误处理不能省。
▍3.3 代码怎么Review:全文最重的一节
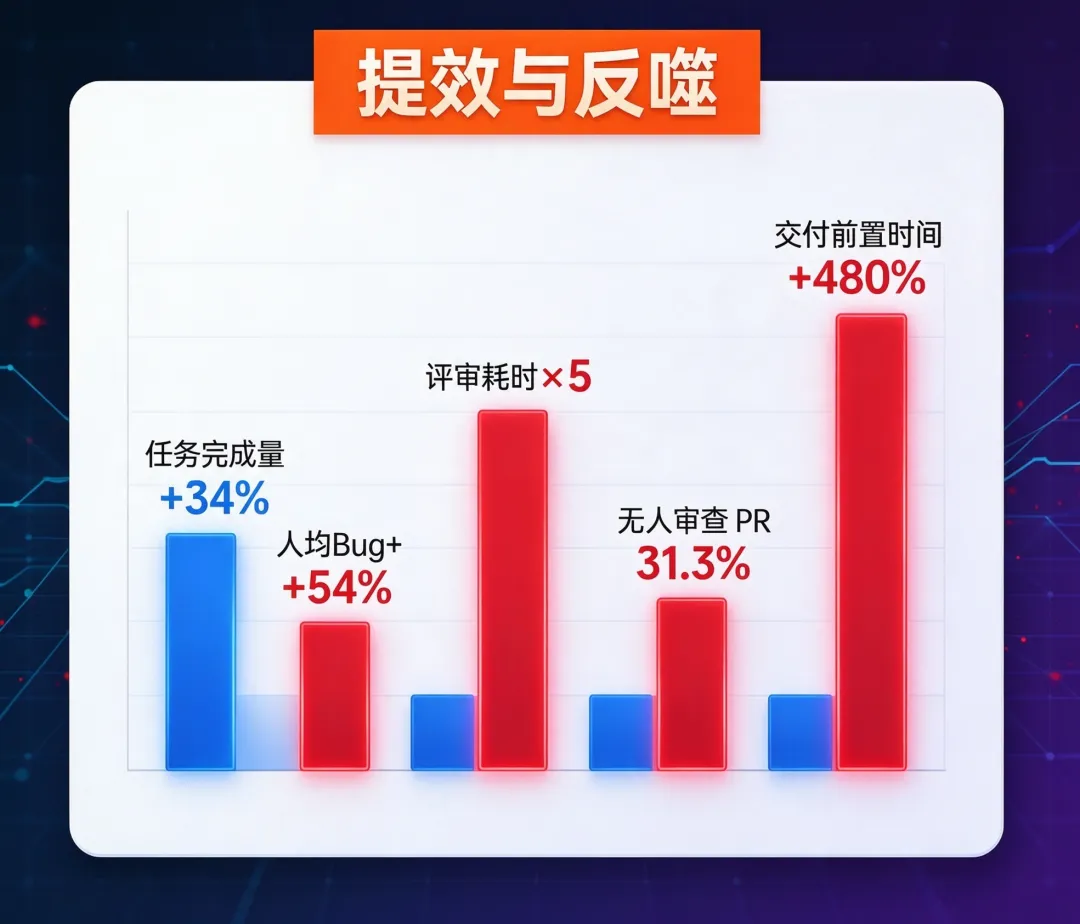
Faros AI基于4000多个团队、2.2万开发者两年的遥测数据,给出一组"加速冲击波",当AI工具周活越过50%阈值,人均任务完成量+34%,但人均Bug数+54%,事故与PR比率涨3倍,31.3%的PR合并时无人审查。
DORA 2025报告发现,团队代码评审的中位耗时暴涨441%。GitLab调查里,85%的团队认同一句话,瓶颈不再是写代码,是审代码。
以前Reviewer花时间看懂"这段PR在干嘛"。现在AI会生成PR描述和测试,Reviewer只需要判断三件事,架构对不对,风险大不大,能不能上线。
新范式是哑铃结构,AI初审,人做架构判断、风险判断、兜底判断。
Reviewer的判断力,成了整条链路上最稀缺的资源。
▍3.4 测试怎么跑:测试左移,用例与代码同步生成
神州信息的银行核心系统案例,以前5个人花1个月写测试用例,现在1个人审核AI生成的用例。
测试左移,用例和代码同步生成。但安全债在指数累积,上面那组"5轮迭代漏洞+37.6%"的数据说的就是这件事。
▍3.5 发布谁负责:回到"谁签字"
点Merge的人和他所在的团队背书。企业必须建质量门禁和人工责任制。
Sonar有句话,我建议每个技术负责人把它贴在工位上。
"我批准将这段代码投入生产环境,并承担随之而来的所有风险"。
代码生成这件事,2026年早就不卡了。卡住的是,你敢不敢为一段你没逐行读过的代码,在生产事故通报上签上自己的名字。
第4章 范式跃迁:从Vibe到Loop,从裸CPU到操作系统
代码怎么写这件事,今年也换了一代。
Vibe Coding是入场券。
"用感觉写程序",2026年最热的技术叙事。Gartner预测,到2028年40%的企业新应用将由"氛围编程"生成,而且63%的氛围编程使用者根本不是专业开发者。
人人都能写程序了。但热潮之下藏着的交付危机,前面三章已经讲完。
真正的分水岭,在Vibe之上。
Boris Cherny,Claude Code的创建者,今年说了段话。
"现在,我觉得又到了下一个层级:我不再提示Claude了,我有一堆循环(loops)在运行,它们才是在提示Claude并判断接下来该做什么。我的工作变成了写循环。"
"龙虾之父"Peter Steinberger同一天发推:"你不该再给编程Agent写提示词了。你应该设计一套循环机制,让这些循环去提示你的Agent。"这条推文拿了150万浏览量。
两个人把一个新范式推到台前,Loop Engineering,循环工程。
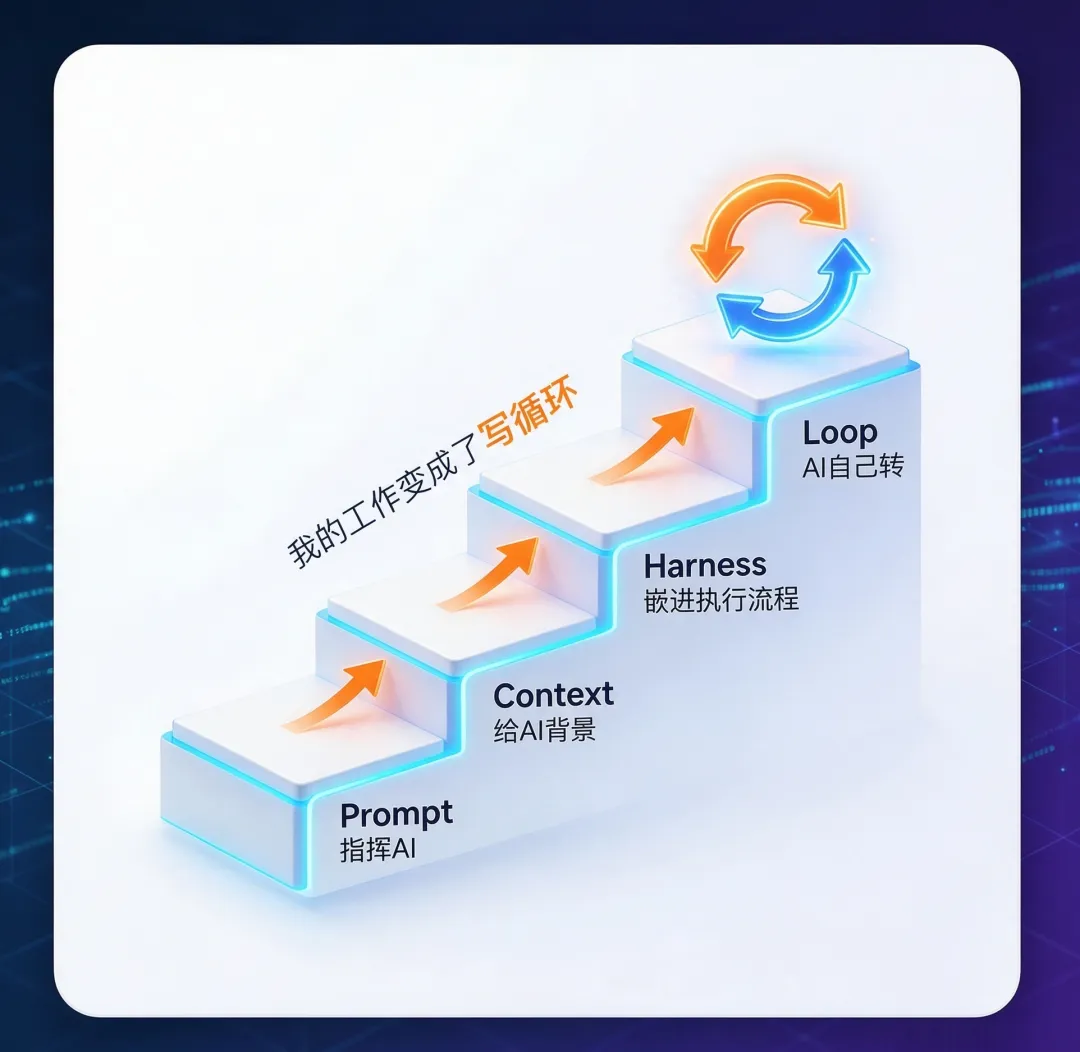
它背后是一条四级台阶。
Prompt,你指挥AI,一句一句下指令。
Context,你给AI足够的工作上下文,让它看得懂。
Harness,你把AI嵌进执行流程,工具调用、错误处理、审计留痕都有章法。
Loop,AI在执行、检查、修正、再执行的闭环里自己转,人只盯结果。
Prompt是命令AI干活,Loop是让AI自己盯着活干完。
再往下挖一层。大模型本身是什么?一块"裸CPU",没有内存管理,没有文件系统,没有进程调度。要让它稳定执行企业级任务,必须在它外围建一整套"操作系统"级别的基础设施。这就是Harness。
这里有个配置哲学,机器之心的综述讲得透彻。
内化,通用策略、稳定知识,进模型参数。推理快,不依赖外部。
外化,实时数据、高风险操作、审计留痕,留在Harness层。可控、可回滚、可解释。
Skills,技能包,就是外化知识的载体,一块块可编排的积木。
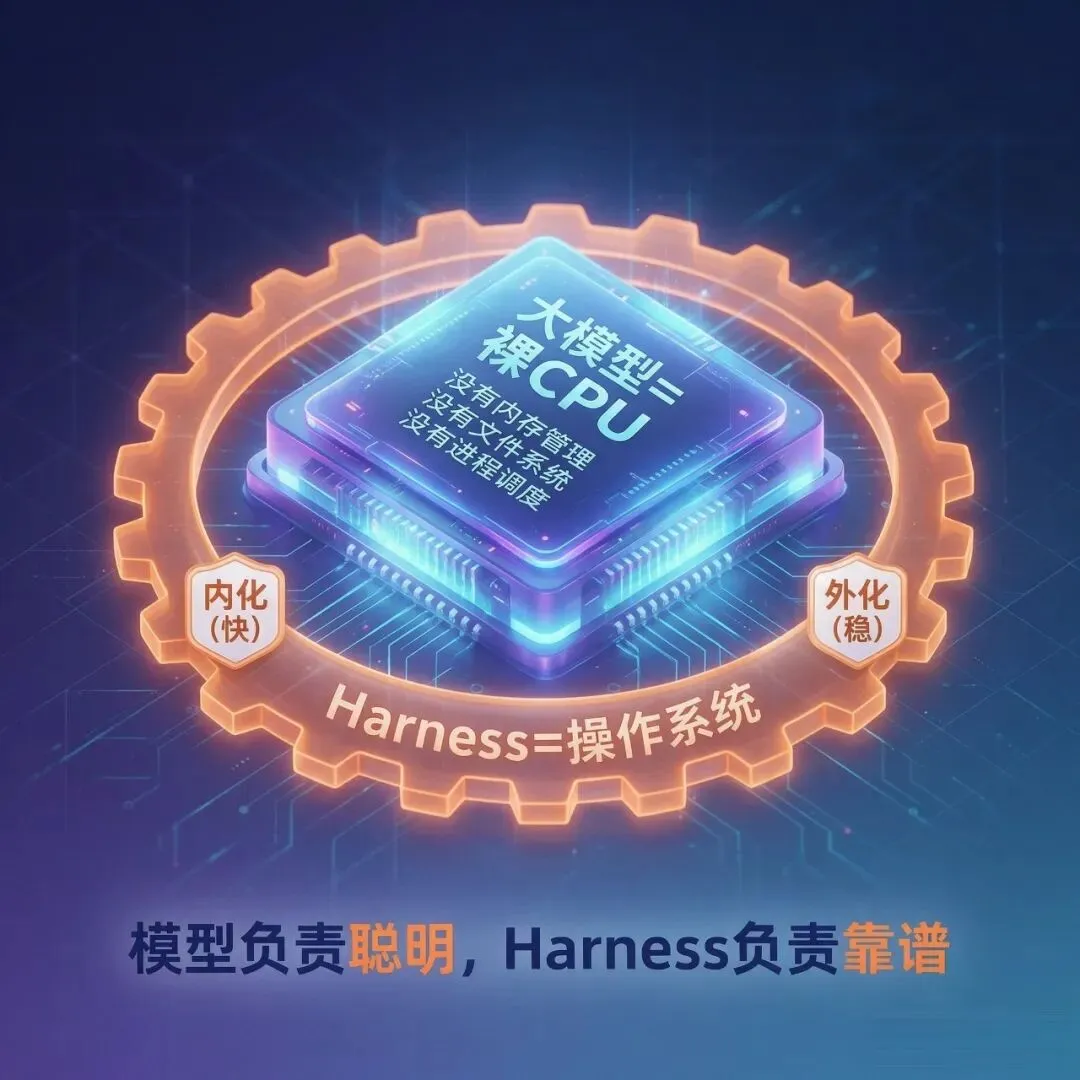
模型负责聪明,Harness负责靠谱。两个都靠谱,才是真的靠谱。
第5章 组织和岗位:金字塔正在从底部断裂
产研重做,必然动组织。
两个真实组织调整先摆出来。美团CLC食杂零售的Keemart研发团队,把前端和后端正式合并。蚂蚁网商把测试岗位整体转向研发,设半年缓冲期转型全栈。
这不是互联网传闻,是写进组织架构调整公告的事实。
Claude Code之父Boris Cherny提过五类角色原型,原型探索者Prototyper、构建者Builder、系统清理者Sweeper、产品增长者Grower、系统维护者Maintainer。
岗位的划分逻辑变了。不再按职能分,按产品阶段和系统责任分。
字节、阿里、腾讯、谷歌、Stripe最新的JD里,"纯前端""纯后端"的岗位定义正在消失。企业要的是"端到端负责一个功能从需求到上线"的人。AI全栈工程师的新含义,变成懂产品、懂模型、懂系统、懂成本。
但真正让行业睡不着觉的,是金字塔的底部。
华盛顿大学两位学者在《CACM》提出"窄金字塔假说",金字塔的底座正在被抽掉。初级开发者过去靠修 Bug、写基础代码、做小需求,在大量试错与反馈中练出对代码的判断力。
现在 AI 接管了这些执行层工作,真正的危机不是 "活没了",而是 "反馈回路断了"——AI 把代码写对了,新手却失去了 "为什么对" 的试错机会。品味不是被 AI 抢走的,是练不出来了。
数据也难看,初级岗位需求自2022年降了67%,智联招聘普通前后端岗位降52%,七成岗位要求3年以上经验。
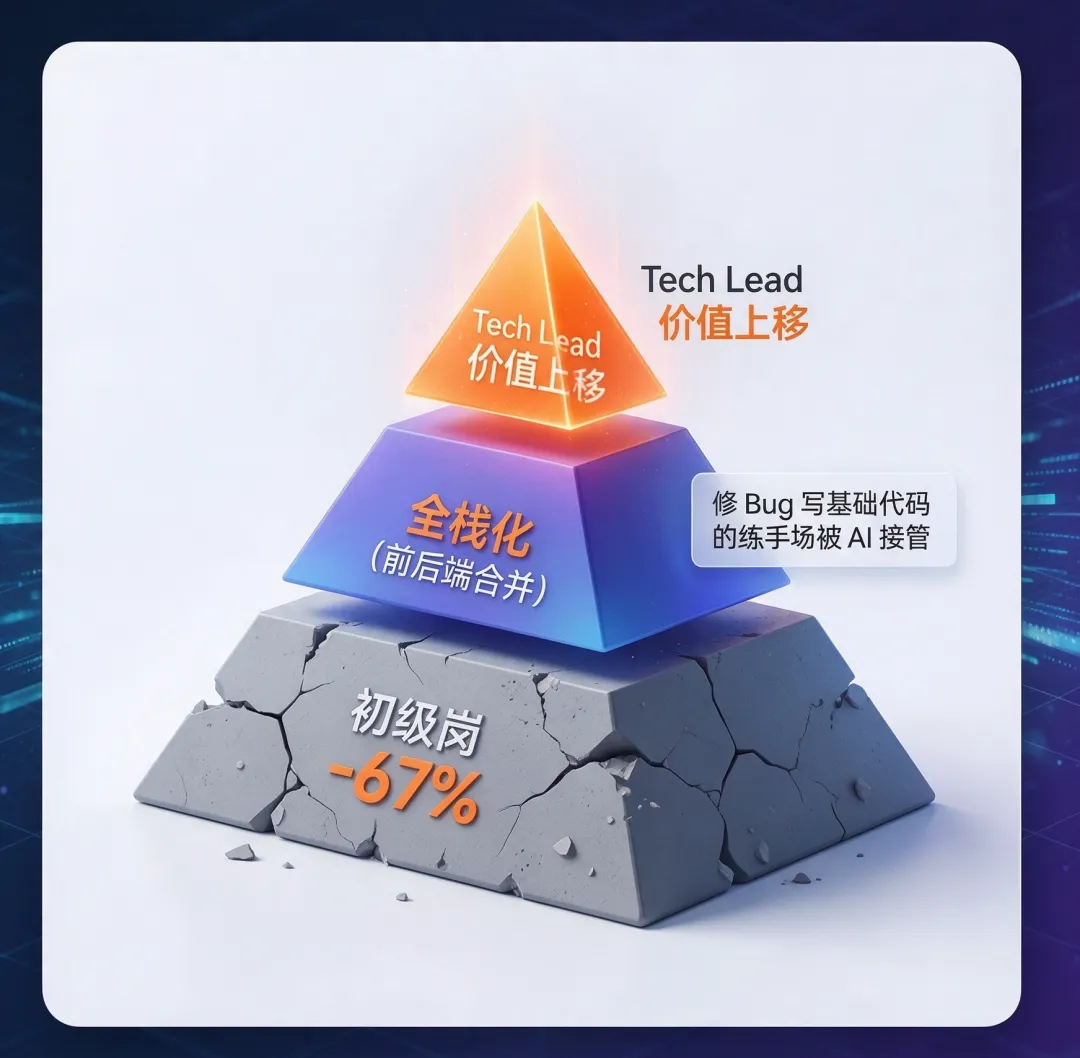
以前工程师的成长靠"犯错",在低风险的分支上把系统写坏一次,再修好。AI把这个练习场没收了。
五年后回头看,我们可能会发现一个问题。没有技术负责人可以培养了。
政策第十八条"促进软件产业就业友好发展",要求"同步实施岗位改造与技能培训"。国家看见了裂缝。但靠行政手段,能补回这根断了的成长梯吗?我持保留态度。
Tech Lead的价值在迁移,从"我写得比你快",迁到"我知道不该让AI写什么"。品味不变式、架构兜底、风险分级,这三样AI给不了。
第6章 垂直行业解法:某行业数科软件公司的产研重做路径
方法论讲完,落地到垂直行业。以某行业数科软件公司为例,说说这条路怎么走。
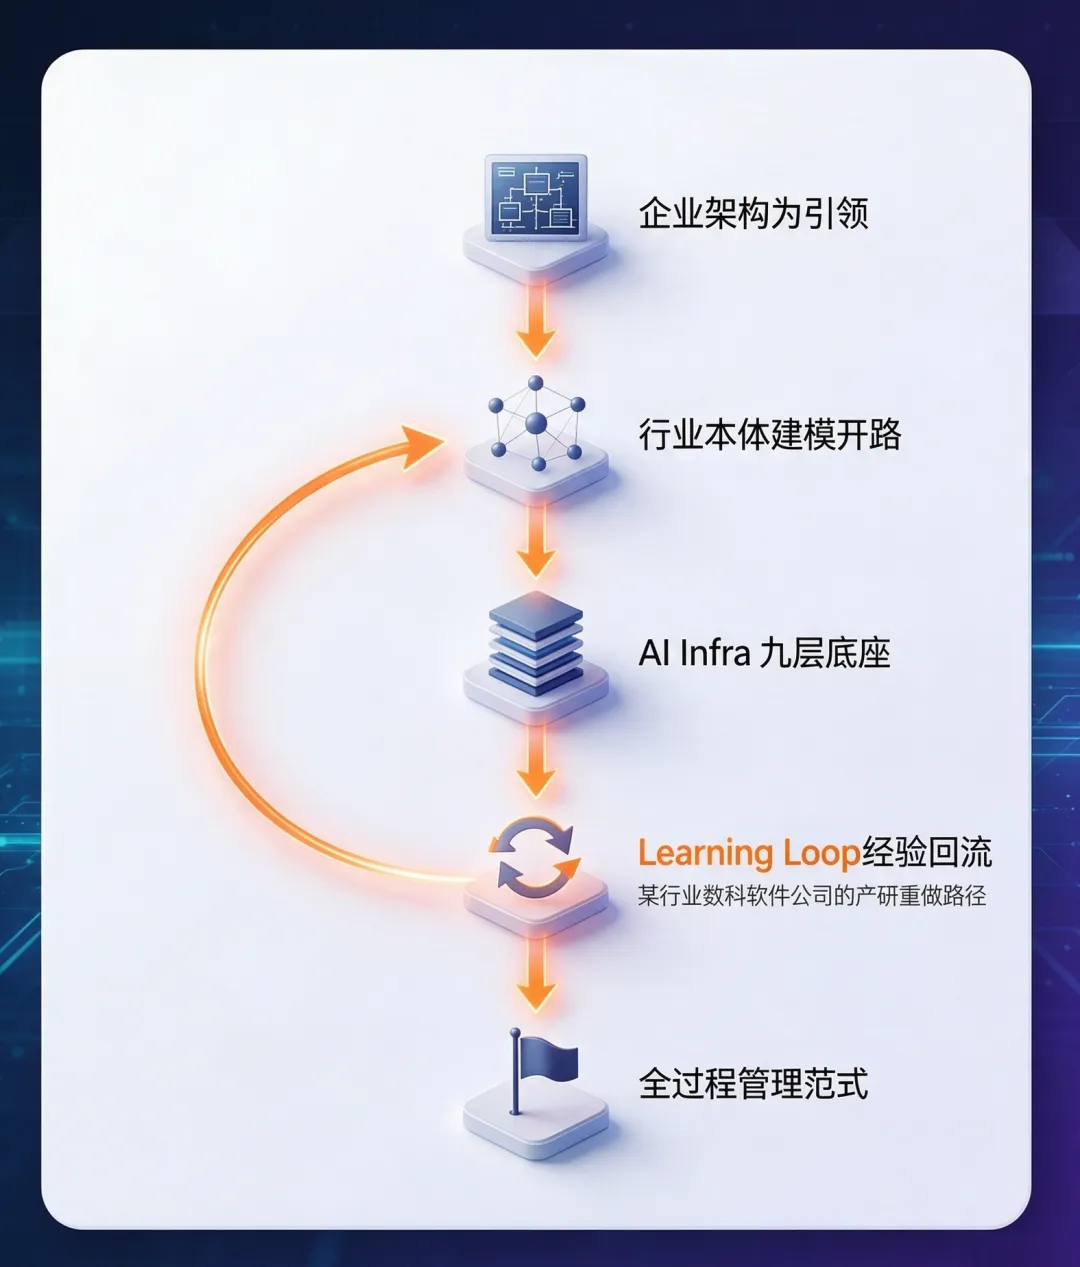
第一步,企业架构为引领。
先把主要业务系统的架构基线梳清楚,一般是行业企业都有的通用业务模块,比如生产运营、财务、营销、人资、综合管理这些。没有架构基线就上AI,结果是一堆智能烟囱,各冒各的烟。
没有企业架构的AI+软件,就是给一栋没打地基的房子装智能家居,好看,但不稳。
第二步,行业本体建模开路。
按对象定义行业,按功能建系统。一家大型企业的本体是什么?产品、客户、订单、项目、资产、工单,把这些对象的语义、关系、规则建模,让机器读得懂行业语言。
事件本体让AI从"学结果"到"学过程",动作本体让AI从"会说到会干"。本体建模的深度,决定了AI在垂直行业能走多远。
第三步,AI Infra九层底座。
东哥《AI Infra落地实战》给了张九层架构图,垂直行业软件公司可以直接对标,L0基础资源、L1模型推理、L2数据知识、L3上下文、L4编排、L5工具执行、L6状态记忆、L7评测质量、L8可观测运营。
再加四条治理,安全治理、发布治理、成本治理、开发者体验。
训好模型只是起点,跑好Infra才是终局。 这句话对垂直行业软件公司尤其成立,你的护城河不在模型多强,在L2到L8这七层扎得深不深。
第四步,Learning Loop,把经验沉淀变成工作本身。
京东零售产研团队的思考给我很大启发。他们把企业智能概括成三个要素,Model、Context、Learning Loop。
个人效率的提高,不直接等于企业效率的提高,中间隔着流程和协作的Gap。一个程序员的Coding效率提高很多倍,公司的研发效率并不会同步提高很多倍。
Learning Loop的妙处在哪?你让AI出方案,AI给初稿,你给反馈,哪里不合适、结构怎么调。系统把这些反馈记下来,变成新的Context。下一个同事碰到类似问题,AI就知道怎么做。
过去沉淀经验是额外的工作,现在它变成了工作本身的一部分。
第五步,轻量级国产技术栈+AI+软件全过程管理范式。
信创合规、成本可控、生态成熟,三条底线。轻量级技术栈让中小项目用得起,国产栈让央国企客户敢用。
全过程管理范式,需求、设计、开发、测试、交付、运维,每一环都AI化。以智能原生应用和高价值智能体为目标,全面遵照国家实施方案。
客户要什么?要的是AI把活干完。而这"把活干完",靠某一段代码写得快没用,得整条链路一起变。
第7章 最后判断:政策落地的三个冷水+留给你的行动清单
泼三盆冷水,再给一份行动清单。
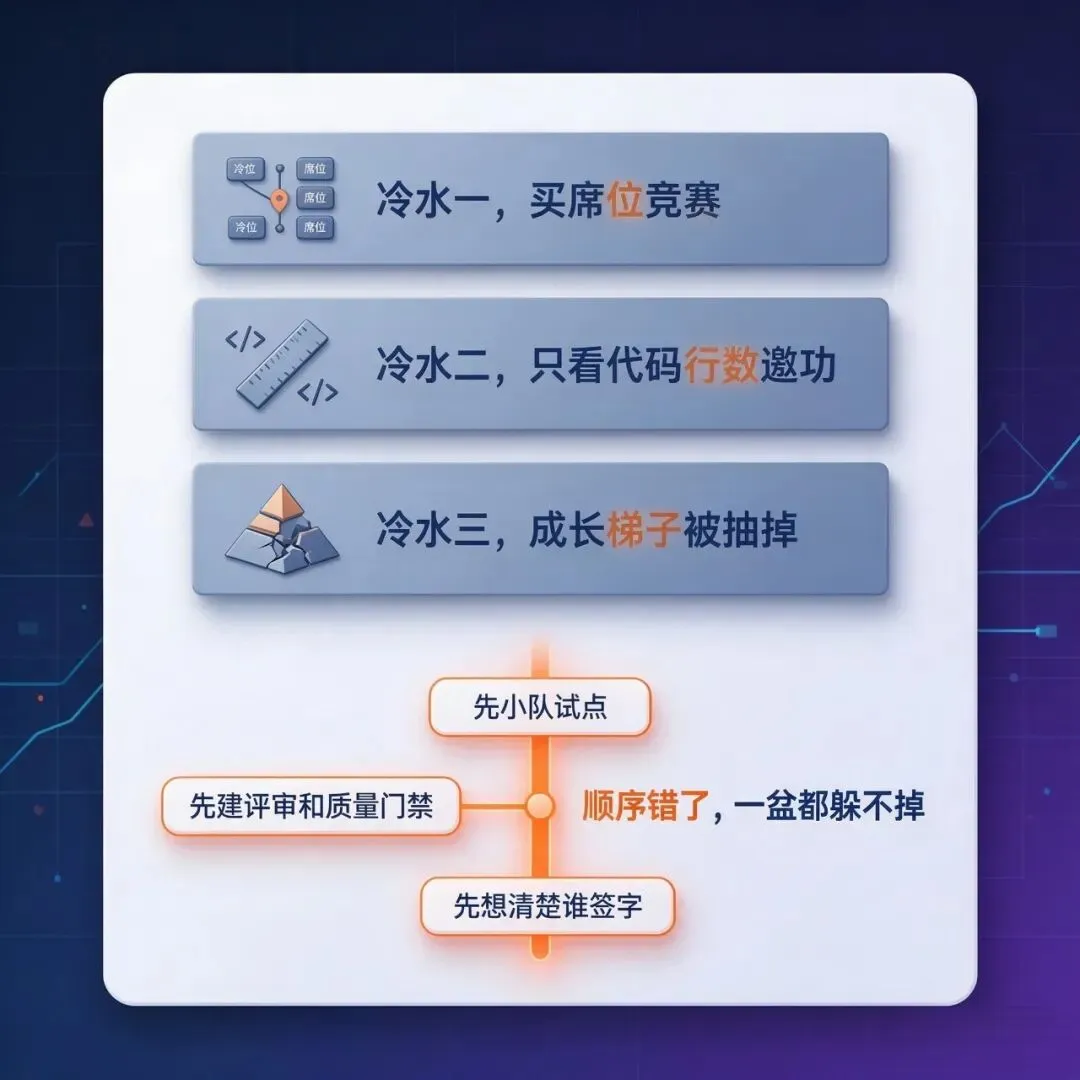
冷水一,2万家的KPI,会不会变成"买席位竞赛"?
把工具塞给一家连需求评审都走过场的小软件公司,是提效,还是加速生产技术债?Faros的数据已经说了,AI在成熟工程团队是放大器,在流程混乱的团队是"加速混乱"。KPI式推进最大的风险,是变成"买了多少席位"的采购数字游戏。
冷水二,技改条款强调"代码质量、研发实效",政策已经在防歪。
这句话值得每家软件公司划重点。靠"代码行数""token消耗量"邀功的路,政策已经明示走不通。真正的实效指标,代码质量、研发效益、进入生产环境的净增代码。
冷水三,就业友好条款背后,是国家也看见了金字塔底部的裂缝。
岗位改造、技能培训、开发新型岗位,行政手段能对冲一部分,但补不回那根"靠犯错成长"的梯子。这个问题的最终解法,在每家企业自己的培养机制里。
行动清单,三件事,按顺序来。
先选一个流程成熟的小队试点,别急着买全公司席位。
先建代码评审和质量门禁,再谈让Agent自主写。
先想清楚谁签字上线,再谈提效。
顺序错了,前面三盆冷水,一盆都躲不掉。
这场变革最残酷的地方,在于它把"写代码"这件事从工程师的护城河,变成了水电煤。真正还在河里的,是那些能定义问题、能守住品味、敢为后果签字的人。
政策给了两年时间把工具铺出去。能不能活下来,取决于你这两年,把自己从"写代码的人"变成"指挥代码的人"。
你们公司AI代码进生产前,最后一道人工签字是谁?评论区见。
产研流水线重做完,下一步是产品本身怎么变。下一篇,聊聊"智能伙伴"。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,给我个星标⭐~(订阅号列表顶部点星标,不然后面就沉下去啦)
谢谢你看我的文章,我们,下次再见 