ARTICLE · 1102007
AI 越跑越快,传统数仓该怎样进化?
AI 越跑越快,传统数仓该怎样进化?
最近看数仓岗位 JD,会发现一种有意思的“新旧并存”:有的岗位仍在强调离线、实时数仓、维度建模、ETL 和数据监控;有的已经写进了 AI Agent 调用、评测数据仓库、智能 SQL、口径对齐和质量巡检。 这不是数仓被 AI 替代的证据,反而说明数仓正在换一种方式发挥作用。过去,它主要把数据交给报表、分析师和业务系统;现在,还要面对会主动查询、组合工具、生成解释的 AI 应用。使用者变了,数仓交付“可信事实”的责任没有变,但交付方式必须进化。 在 BOSS 直聘可检索的职位里,字节跳动的数仓方向岗位仍要求建设离线与实时数据仓库,完成模型设计、ETL、性能优化和监控;另一条“数仓工程师—AI 数据服务”则提到评测数据仓库、分层建模、统一指标口径与血缘。美团的“数仓 AI Builder”把需求沟通、模型设计、SQL 开发、任务编排、质量巡检和口径对齐列为 Agent 工具要理解的工作流程。还有数仓开发岗位明确写到,要让数仓支撑业务分析和 AI Agent 调取。 它们共同指向一个值得重视的变化:企业既要有人把数据建对,也想让这套数据体系能被 AI 稳定使用,并用 AI 改进数据研发本身。这两件事相邻,却不是一回事。 假设业务问:“上周华东 GMV 为什么下降?”模型可以很快组织一段解释,但它首先需要知道:GMV 是支付金额还是下单金额?退款算在哪一天?华东按用户所在地还是订单履约地划分?上周是自然周还是滚动七天?如果这些口径没有定好,回答越流畅,风险可能越大。 所以传统数仓的基本功——业务过程、事实粒度、稳定主键、历史快照、指标口径、数据质量和血缘——并没有因为大模型出现而过时。它们决定“上周华东 GMV”究竟是一个可复算的事实,还是模型碰巧拼出来的一串数字。尤其在 AI 可以反复调用工具、把结果传播给更多人的情况下,错误口径会被放大。 数仓的第一步不是急着“接大模型”,而是盘点哪些核心数据真正可信:关键指标有没有单一口径,维度有没有一致的业务含义,变更能否追溯,质量失败时消费者能否知道。底层不稳,外面套多少 Agent 都只是把不确定性包装得更好看。 传统数仓常把业务含义藏在 SQL、报表配置、开发者经验和散落的文档里。分析师知道该连哪张表、该避开哪个已废弃字段,AI 却不知道。给模型开放一百张表,不等于交付了一百项可用能力。 更合理的做法,是为高价值问题建立机器可消费的语义契约:指标定义、允许的维度、时间口径、过滤条件、实体 ID、字段来源、权限范围,以及可验证的查询样例。以 GMV 为例,不能只给一个 gmv_amount 字段,还应说明它的计算规则、可用时间范围、退款处理方式和适用业务域。Snowflake 的 Cortex Analyst 把“已验证的问题—SQL”放入语义模型,正是用经过核对的样例约束自然语言问数的一种产品做法。 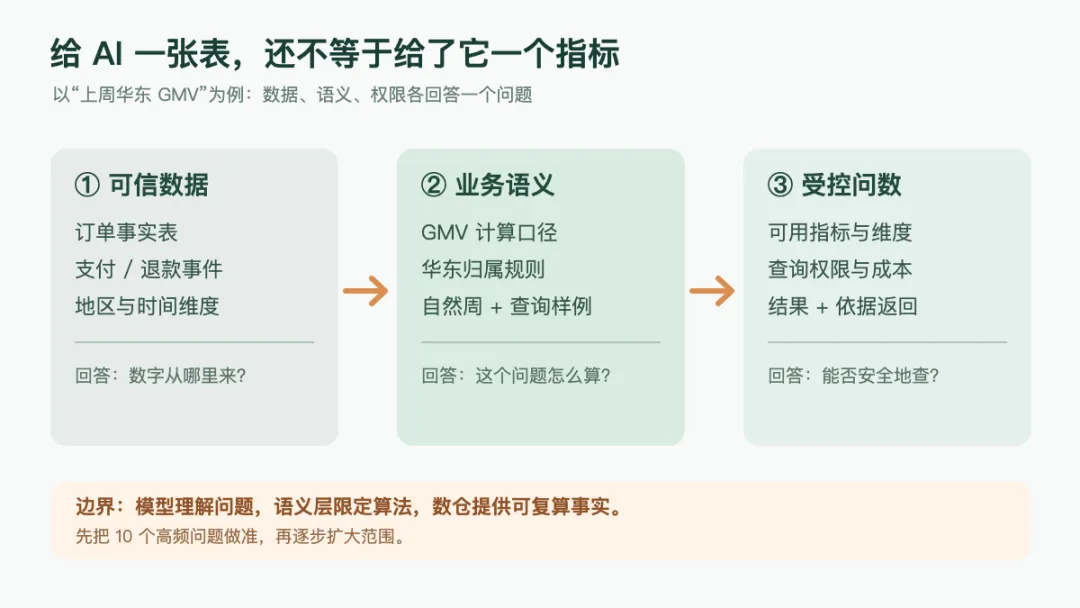
这一步不要求每家公司都造“企业级语义平台”。先挑十个高频、易错的问题,把口径、样例和反例做扎实,比一口气让模型查询全库更有价值。模型负责理解问题,语义层负责限定“什么问题可以怎样算”,数仓负责提供可复算的数据。 继续看 GMV 异动。一个较好的 AI 数据应用,不应只返回“下降了 12%,可能因为活动结束”这种看似完整的句子。它应先给出对比所用的指标版本、时间窗口和维度;再检查数据是否按时到齐、上游任务是否失败、退款或渠道结构是否变化。能确认的事实和待验证的推测,要清楚分开。 若发现某渠道的订单分区缺失,系统可以创建核查任务,附上异常证据与血缘路径。但“重跑分区”“修改指标口径”会改变生产数据,不能让模型直接决定并执行。动作需要明确的目标、参数、权限、人工审批和结果读回。接口返回成功也不等于业务数字已经恢复;质量规则和业务对账都应重新验证。 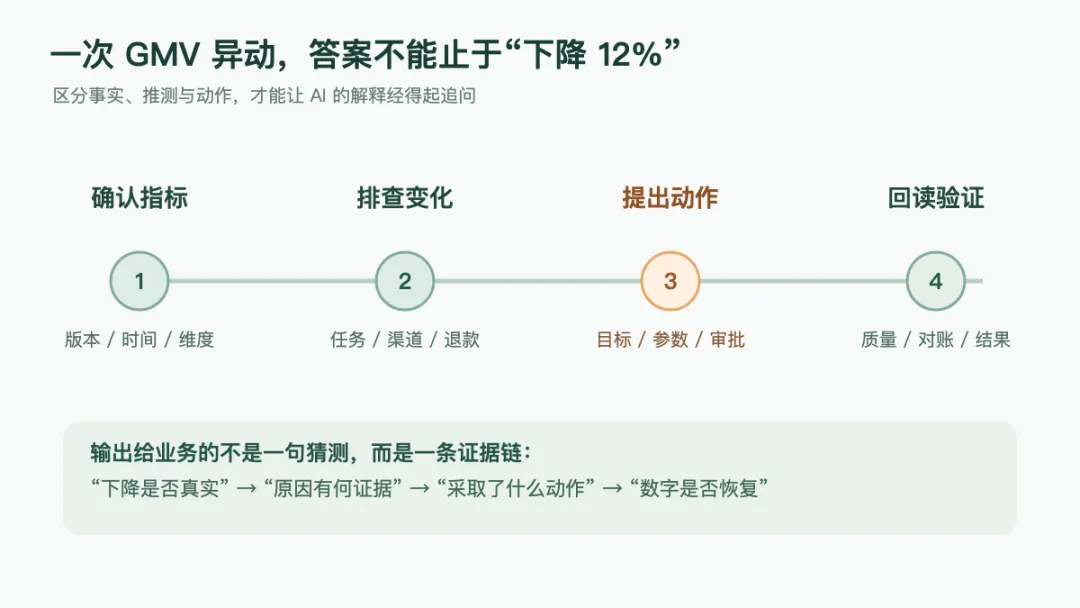
这里数仓的交付物就从一张结果表,扩展为一套可追问的事实服务:算出来的数据、解释它的口径、追溯它的证据,以及处理异常时的边界。这不是让数仓包办所有 AI 应用,而是让上层应用有可信、受控的入口。 另一条路线,是让 AI 进入数仓团队自己的工作流。需求解析、字段检索、SQL 初稿、血缘影响分析、质量规则建议和异常定位,都是适合辅助的环节。美团“数仓 AI Builder”一类 JD 之所以值得看,不是因为它在标题里加了 AI,而是把数仓团队原本高频、重复、容易出错的环节具体列了出来。 但 AI 生成 SQL,不代表 SQL 可以直接上线。仍要检查扫描成本、Join 粒度、时间分区、权限、边界样本和口径一致性;修改模型之前,要知道下游谁在使用;修复数据之后,要保留前后版本与回归结果。AI 可以压缩“写第一版”的时间,工程师仍要对“最后一版是否正确”负责。 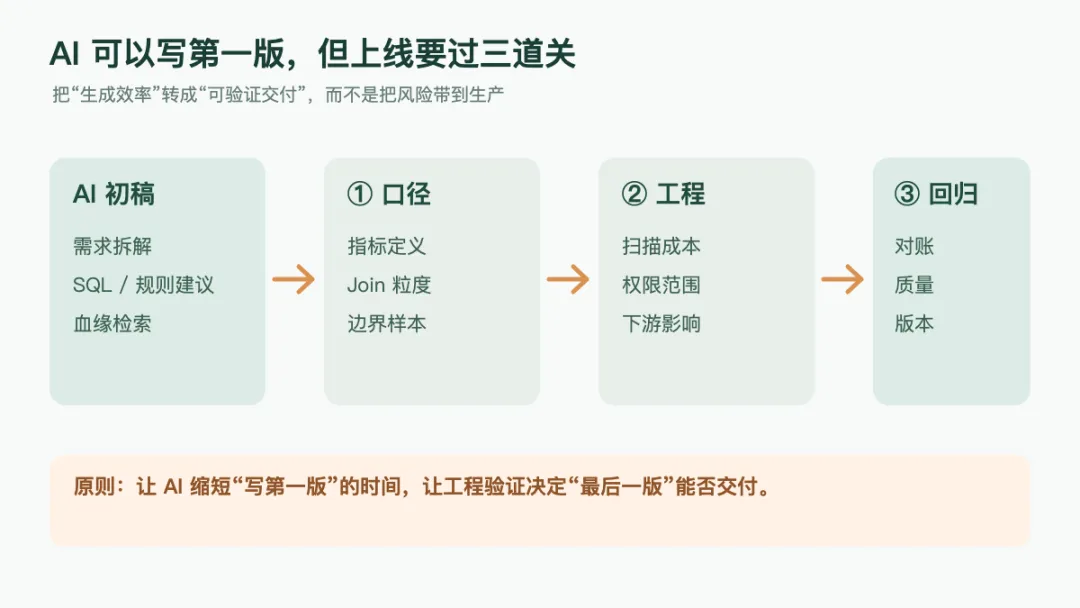
一个团队若想开始试,可以从低风险任务切入:把指标文档、表结构和血缘做成可检索资产;用一组真实历史需求评测 SQL 建议的正确率;再让 AI 辅助诊断数据质量告警。只有经过评测的环节,才逐步进入自动化。不要一上来就追求“无人值守数仓”。 如果你现在做的是传统数仓,我会建议按三个层次补能力。先把原有优势做深: 1. 业务建模、实时与离线链路、数据质量、指标治理和成本性能。这些是任何 AI 数据应用的地基。 2. 接着学会把数据作为产品交付:语义定义、数据服务接口、权限、版本和可观测性。 3. 最后再做一个小而完整的 AI 场景,验证模型究竟改善了哪个环节,而不是只展示“能聊天”。 简历或项目展示也可以随之改变:少写“搭建了 ODS、DWD、DWS、ADS 四层”,多讲一个具体问题——某指标因上游变更出现口径偏差,你怎样发现、定位、修正、回归,又怎样让业务或 Agent 在之后使用到同一套可信口径。层次仍然重要,但它服务的是结果,而不是项目的结尾。 传统数仓的下一站,未必是换一个时髦名字。更准确地说,它要从“报表的数据供应链”,进化为AI 可以调用、业务可以追问、工程师可以验证的事实底座。模型会越来越会说,数仓要负责让它说的每个关键数字都有来处。 Data+AI 实战获取:公众号主页私信【项目】
1. 先看 JD:传统能力没有消失,新消费方出现了
2. 数仓最不该丢的,恰好是 AI 最缺的
3. 从“给人看的表”,变成“机器也读得懂的语义”
4. 从“出数”延伸到“交付证据与受控动作”
5. AI 也会改造数仓研发,但不要把生成当交付