ARTICLE · 1105249
别再交AI会员费了:这5个免费工具,电脑就能跑
别再交AI会员费了:这5个免费工具,电脑就能跑9月20日,阿里千问团队开源了一个模型,叫 Qwen-Image-2.1。 说人话:它能按文字画图,能在你现有的照片上局部改图,还能直接生成透明背景的图。 这三件事,以前要三个工具、三笔钱。现在一个模型全干完,而且视觉部分只有 7B 参数——70 亿,这个体量,自己家电脑是跑得动的。 发布当天,ComfyUI、Diffusers、SGLang 这些常用的推理框架就同步支持了。业内管这个叫 Day 0 适配,意思是开箱即用,不用等。 这不是孤例。今年一整年,开源模型都在往同一个方向走:变小、变快、免费、能在你自己的机器上跑。 这是今年最值钱的一个变化——AI 的门槛,从「要买会员」,变成了「要有台电脑」。 先把话说清楚:不是所有活都适合放自己电脑上干。 云端的大模型还是最聪明的,知识面最广,反应也最快,这个不用自欺欺人。 本地跑的价值在另外三件事上:不花钱、断网能用、数据不出你的电脑。 尤其是最后一条。合同、病历、客户名单、还没公开的稿子——这些东西发给云端模型,等于你把数据交出去了。 所以正确的用法不是「全换成本地的」,而是「该本地的本地,该云端的云端」。 清单:这几个免费工具,从第一个开始试就行。 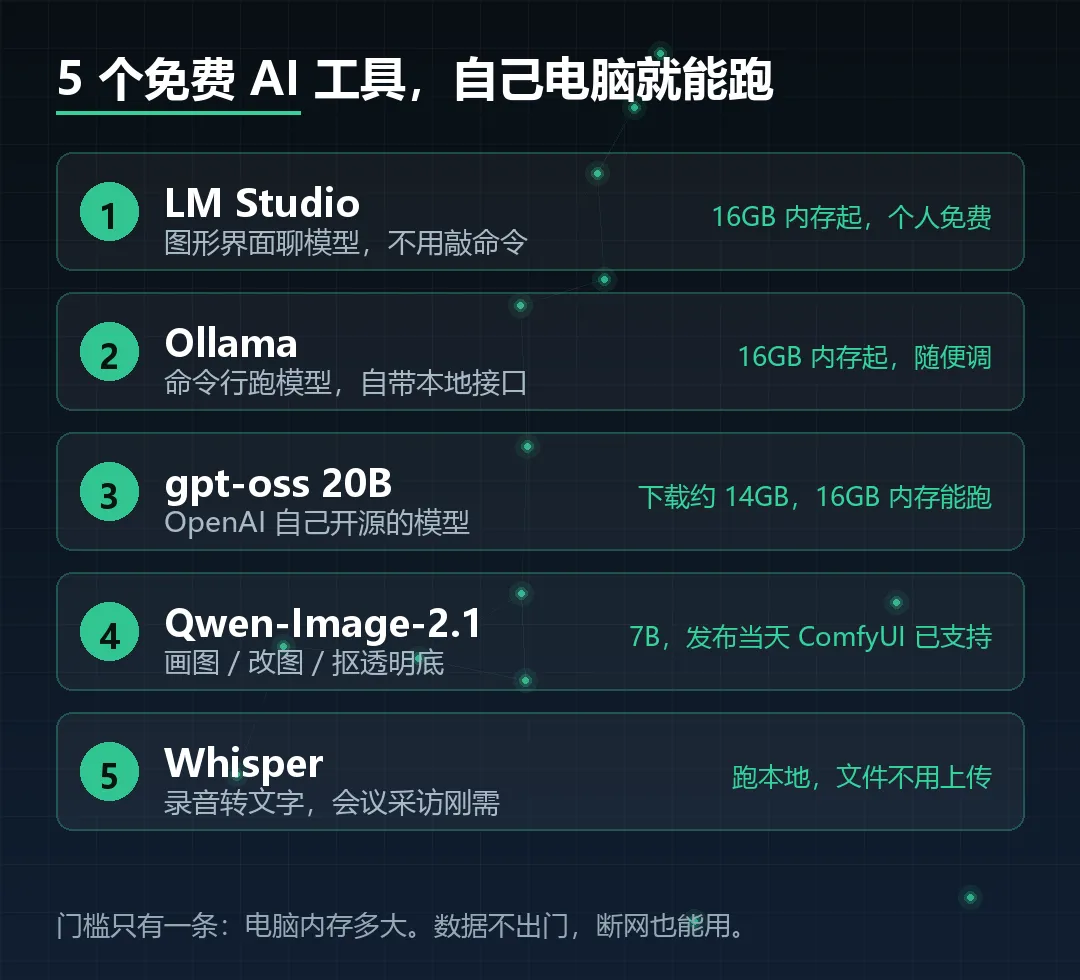
一、LM Studio。图形界面,不用敲命令,装完打开就能用。 它自带模型浏览器,每个模型要占多少内存、你这台机器跑不跑得动,它直接标出来。 官方建议至少 16GB 内存,Windows 上再有点独立显存会舒服很多。个人使用是免费的。 不熟悉命令行的,从这个开始。 二、Ollama。不排斥命令行的话,它是效率最高的那个。 装完一行命令就把模型拉下来跑起来,还会在你本机开一个接口,别的软件可以直接调它。 写脚本、接自动化、给别的程序当大脑,用它。 三、gpt-oss 20B。这是 OpenAI 自己开源的模型,20B 参数,下载大约 14GB。 官方说 16GB 内存的机器就能跑。一个「OpenAI 出的、能装在自己电脑上」的模型,这件事本身就挺有意思。 四、Qwen-Image-2.1 加 ComfyUI。就是开头那个模型,画图、改图、抠透明底。 它一次能吃 10 张参考图。官方举的例子是:模特、衣服、鞋、包、帽子,五张图进去,合成一套完整穿搭。 改图也不用自己涂蒙版,画个圈,圈住哪儿改哪儿。官方演示里一次圈了三处,同时改。 五、Whisper。录音转文字,开会、采访、听讲座的刚需。 开源、免费,跑在本地,录音文件不用传到任何服务器上。 整理访谈稿、做会议纪要,省下来的不只是订阅费。 该说说坑了,不然就是耍流氓。 第一,慢。同一个问题,你本地那个 8B 模型和云端的旗舰,回答质量是真的有差距。 第二,吃硬件。想跑 7B、8B 级别的模型,16GB 内存是底线,显存越大越流畅。 第三,要折腾。驱动、量化版本、上下文长度、显存不够要不要往内存里挪——每一步都有坑。 第四,本地模型不会自动联网。你问它今天的新闻,它是真不知道。 所以别听完就去把会员退掉。正经姿势是:先把本地这套跑起来,摸清它擅长什么、不行什么,再决定哪笔钱可以不花。 怎么开始,四个步骤。 第一步,先看自己电脑的内存和显卡。这一条基本就决定了你能跑多大的模型。 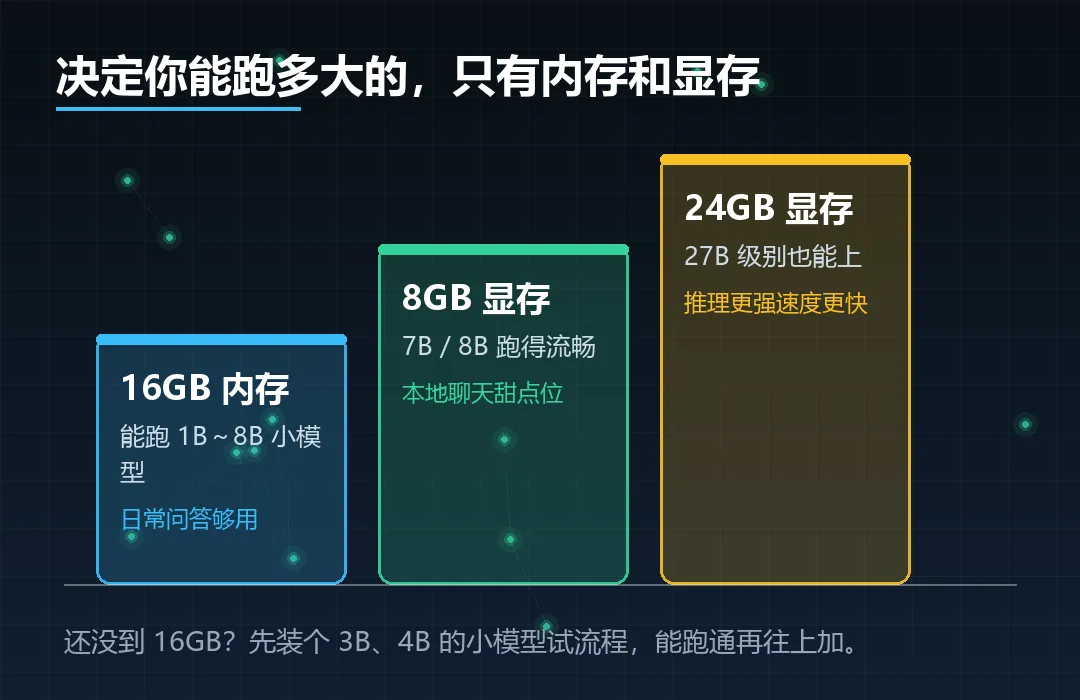
第二步,装 LM Studio 或者 Ollama,两个可以同时装着,不冲突。 第三步,从小模型开始。别一上来就下 30B、70B 的,先拿一个小的把流程跑通,感受一下速度。 第四步,拿你真实的工作去试。别用「你好,介绍一下你自己」来测,直接上你平时最头疼的那份文档。 开源这条路今年的变化,说白了就一句话:以前你只能等厂商降价,现在你可以自己动手。 花的是一台电脑的钱,省的是每个月都要续的那一笔。