ARTICLE · 1107043
工具做错、回答却说对:AI 训练到底奖励了什么?
工具做错、回答却说对:AI 训练到底奖励了什么?
作者: Yan Zhan、Shaobo Liu、Qiunan Liu 等 10 位作者论文: SLCA-GRPO: Resolving Cross-Segment Credit Misattribution in Tool-Calling RL数据: Toucan-Test、BFCL V3、tau²-Bench;Qwen2.5-3B/7B-Instruct、Qwen3-8B-Base
先看一个训练时很容易被忽略的瞬间
想象一个客服智能体正在处理退款。它先调用订单查询和退款政策工具,再给用户一句“可以原路退款”。如果工具证据其实显示商品已经拆封、只能退成店铺余额,那么最后这句总结就是错的;反过来,工具调用可能绕了远路,最后却把正确结果说清楚。同一条轨迹里,工具执行和最终回答完全可能一好一坏。
问题在于,很多 on-policy 强化学习方法只拿一个整条轨迹的分数更新所有生成 token。只要最终回答看起来不错,前面多余甚至错误的工具调用也可能被一起强化;如果总结写错,原本正确的工具决策又会被连带惩罚。
论文把这种现象称为“跨片段信用归因错误”:不是模型没有得到反馈,而是反馈被算给了错误的行为片段。这解释了为什么一些训练曲线上的总奖励在上涨,真正可执行的调用却没有同步变好。
“summary-reward variation can enter the tool-token advantage”
——论文引言
这句话点出了旧式统一奖励的漏洞:总结质量的波动会渗入工具 token 的更新。读者可以把它想成一张混合账单:餐厅服务和菜品质量被合成一个总分,厨师最后只知道“这桌得分高”,却不知道该改刀工还是改上菜流程。
论文真正要解决的疑问
作者没有把问题归结为“奖励太稀疏”,也没有简单增加更多奖励项,而是追问一个更具体的问题:当一条轨迹同时包含工具调用和自然语言总结时,哪一段行为应该接收哪一份反馈?
方法怎样工作:把反馈锁回对应片段
先把两种表现分开
SLCA-GRPO 的核心是 Segment-Locked Credit Assignment,也就是“分段锁定信用分配”。它仍然使用一个统一模型,但先把每条 rollout 按结构分成工具轨迹和最终总结,再分别计算、分别归一化、分别回传反馈。这样做的目标不是切断工具与答案的因果联系,而是阻断定义明确的“总结奖励流向工具 token”这条污染路径。
论文还配套构建了 Schema-Guided LLM Simulator(SGLS),用 schema 校验和模拟工具响应替代昂贵、易波动的真实 API;Hierarchical Rewards(HierR)则把工具执行质量和最终回答质量拆成两类分数。SGLS 负责让探索可控,HierR 负责让反馈足够密,SLCA 负责让反馈回到正确位置。
“Tool tokens are updated only by execution quality, while summary tokens are updated only by response quality.”
——论文方法概述
从案例到框架:为什么这不是一个小修补
诊断案例:一个总分如何把责任算错
在论文引言的诊断案例中,左侧轨迹调用了不必要的订单历史工具,但最后仍然正确告诉用户“正在派送”;右侧轨迹正确查询了订单和退款政策,却把“只能退店铺余额”总结成“可以原路退款”。这两个案例故意让工具段和总结段的好坏方向相反。
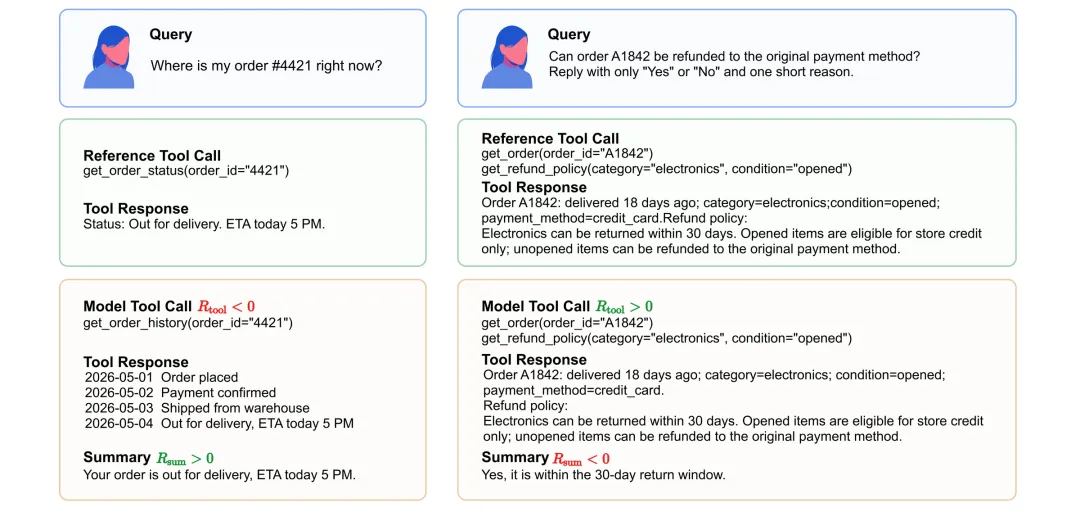
图 1|论文引言中的 Diagnostic cases:左侧是工具调用不理想但总结正确,右侧是工具证据正确但总结错误。
图中最值得注意的不是两句总结,而是两类奖励的符号方向:左侧工具奖励为负、总结奖励为正;右侧正好相反。统一优势会把这两个方向揉成一个信号,因此可能奖励多余调用,也可能惩罚本来正确的工具轨迹。这张图支持的是“存在结构性混淆”的机制诊断,不能单独证明所有真实任务都会出现同样的符号冲突。
方法框架:模拟器、层级奖励和锁定更新
接着看方法总览。它把一条请求如何进入工具环境、如何生成交错轨迹、如何得到两类回报,以及最终如何把优势送回模型,放在同一条信息流里。
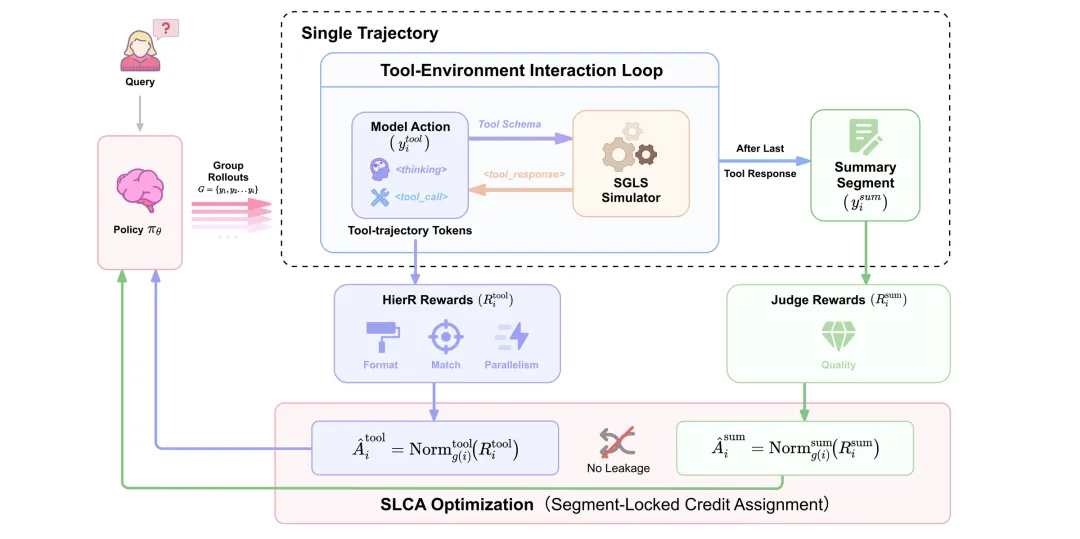
图 2|论文 Figure 1:SGLS 产生 schema 约束下的交互轨迹,HierR 分离执行与总结反馈,SLCA 将两种优势分别路由到对应片段。
从箭头可以看到,工具轨迹先进入 SGLS,最后一次工具响应之后才进入总结段;下方两条反馈路径在优化区被一堵“无泄漏”隔板分开。方法改变的关键环节是优势的支持范围,而不是模型结构或 rollout 数量。框架图能说明信息如何流动,却不能直接说明收益大小,后者要靠匹配实验和多次运行来验证。
实验:收益来自哪里
先看主结果,而不是只看最高分
论文在三个尺度上训练,并用同一套 Qwen2.5-7B-Instruct 设置做主要消融。下表把统一优势的 SFT+GRPO 与完整 SLCA-GRPO 放在一起,数值是三次独立运行的均值和标准差。
| 79.13% ± 1.05 | 69.77% ± 0.47 | 41.02% ± 1.01 | |
表里的差距有两个层次。Toucan 说明同分布工具执行确实改善,BFCL 说明面对未见过的 schema 仍有小幅迁移,tau²-Bench 的跃升则更像是长程协作里“少走弯路”的回报。不能把三个百分点直接理解成能力全面提升:不同基准的任务、评分器和失败模式并不相同。
训练动态:更高的成功率,还更少的工具回合
如果只看最终表格,仍然不知道模型是怎么到达那里。论文 Figure 2 把训练过程和工具回合数放在一起,比较 SLCA、ToolPO 和 RLTR 的代表性单次运行。
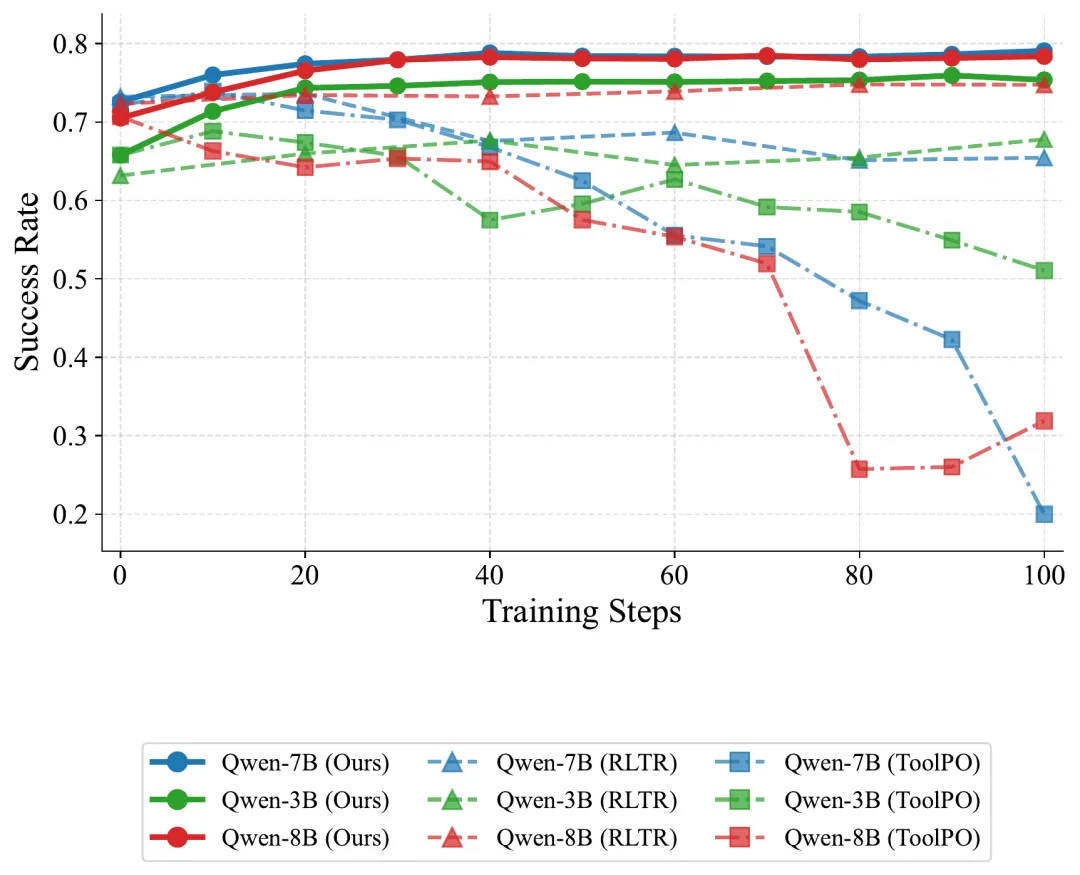
图 3|论文 Figure 2(a) 的训练曲线:三种模型尺度上,SLCA-GRPO 的成功率保持上升,ToolPO 在部分设置后期下滑。
图中实线的 SLCA 曲线在 3B、7B、8B 上都走向较高平台,而 ToolPO 的 7B 曲线在中后段明显下坠;这与论文记录的格式合法性和调用数量异常相互呼应。成功率和工具回合数同时观察时,SLCA 以更短的轨迹达到更高结果,说明它减少了“为了迎合总结奖励而多调用几次”的倾向。但这组曲线是代表性单次运行,不等同于多随机种子的显著性检验。
分布外泛化:小幅 BFCL,明显的协作差距
论文把泛化拆成两个问题:BFCL V3 看未见 schema 的原子调用,tau²-Bench 看 Airline、Retail、Telecom 三类双控环境中的长程协作。Figure 3 的柱状图把三个 backbone 和多个基线放在同一坐标系里。
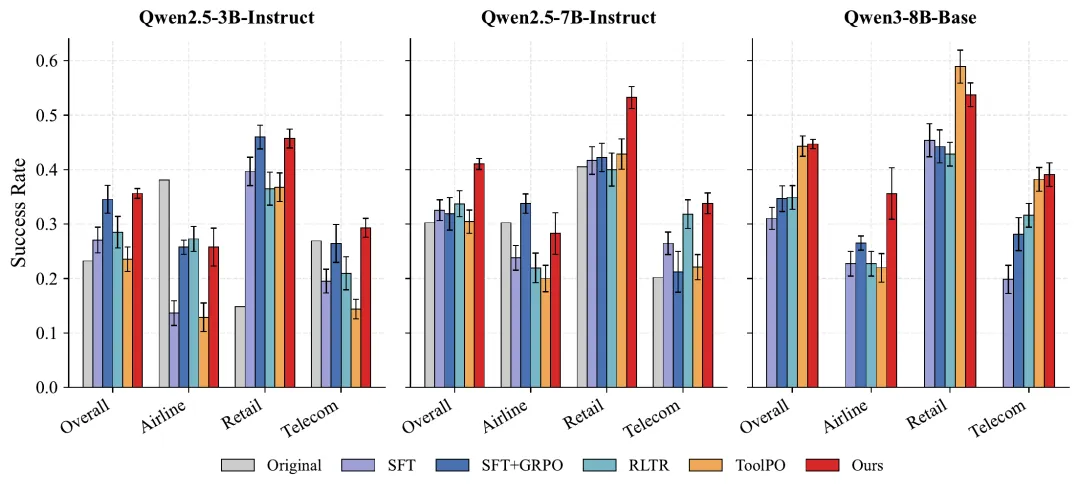
图 4|论文 Figure 3(b) 的 tau²-Bench 结果:三个模型尺度和四个业务域中,SLCA-GRPO 与基线的协作通过率对照。
右侧图的共同趋势是,SLCA 的红色柱在整体和多个领域都更高,尤其在 7B 的整体通过率上比统一 GRPO 高 9.15 个百分点;论文还报告 8B 在 BFCL 达到 70.31%,高于匹配 GRPO 的 66.96%。这提示结构化信用分配可能更能帮助长链路协作,而不只是单次函数调用。不过 BFCL 主比较只使用单轮样本,tau²-Bench 也依赖有限任务集,因此不能据此宣称对所有工具生态都稳健。
消融:三个组件各自承担什么
主表之外,论文在 7B 上逐个去掉组件,结果把作用拆得更清楚:
这些消融支持“路由、探索、反馈”三项设计要求,但 w/o SLCA 同时改变了归一化和 token 支持范围,不能把它解释成只隔离了某一个微小因素。更稳妥的结论是:完整组合在受控比较中有效,组件之间的独立因果贡献仍需要更细的实验。
证据边界与适用局限
作者明确承认,清晰的工具调用—自由文本边界是 SLCA 的前提;内联代码生成或连续混合输出可能需要学习式分段。工具过程奖励主要依赖 gold trajectory 匹配,当存在多条同样有效的 API 计划时,替代方案可能被低估。
从实验设计还可以看到三条边界。第一,工具段内部仍只有一个标量优势,无法区分“第一次调用正确、第二次调用失败”;第二,实验最大规模是 8B,探索主要依赖 SGLS,尚未覆盖更大模型和真实 API 噪声;第三,tau²-Bench 的提升很亮眼,但它不能替代更广泛的生产环境验证。
回到开头:训练系统需要知道“谁做了什么”
这篇论文最有价值的地方,不是再加一个奖励名,而是把一个常被总分掩盖的问题说清楚:工具执行是行动,最终总结是表达,它们应该被评价,也应该被更新,但不该互相背锅。SLCA-GRPO 的做法像把一张混合账单拆成厨房和前台两张单据,再把每条意见交给真正负责的人。
如果你只记住三句话,可以这样复述:工具调用和最终回答会在同一条轨迹里表现不一致;统一奖励会把这种差异混成错误的更新方向;SLCA-GRPO 通过分段反馈和锁定路由,让执行质量更新工具片段、回答质量更新总结片段。它解决的是信用归因的“对象错位”,而不是所有 agent 训练问题。
END
💡 实时了解更多AI论文,关注 Tau Lab