ARTICLE · 1107338
服务器RAS软件开发经验分享——从Linux、BMC与BIOS三个层面谈工程实践(一)
服务器RAS(Reliability可靠性、Availability可用性、Serviceability可维护性)并不是某一个独立软件模块能够实现的能力,而是CPU、内存、PCIe设备、BIOS、BMC、OS等软硬件协同的结果。
一个硬件错误从产生到最终被感知,需要经历硬件检测、固件采集、错误上报、系统处理、带外记录、故障定位等多个环节。做好RAS开发,除了理解具体的错误处理机制,还要建立端到端故障处理思维。
从软件角度来看,服务器RAS通常由BIOS、BMC、Linux内核及驱动这三个部件承载:BIOS负责底层硬件初始化及错误能力配置,BMC负责带外监控、故障记录和运维管理,Linux内核及驱动负责运行阶段的错误处理、隔离与恢复。
二、硬件能力是前提
1.硬件能力是RAS 的基础前提:只有硬件原生具备对应的检测机制,上层软件才能基于该能力实现错误处理。
举例:
CPU MCA(Machine Check Architecture):处理器通过 Machine Check Bank 等机制记录 CPU Core、Cache、内存层次及片间互连相关硬件错误,并可通过 Machine Check Exception 等机制通知OS;Linux等OS在内核 RAS 框架基础上完成错误解析、日志记录以及后续恢复处理
内存ECC:内存子系统需要具备 ECC 检错、纠错能力,内存控制器才能检测并记录 CE(Corrected Error)、UE/UCE(Uncorrected Error)等事件,随后由BIOS和 OS RAS 框架进行处理。
PCIe AER(Advanced Error Reporting):PCIe Root Port、Switch Port、Endpoint 需要支持 PCIe错误检测和上报能力,平台才能完成 Correctable、Uncorrectable Non-Fatal、Uncorrectable Fatal 等错误的记录、上报与恢复。
热插拔、冗余电源、RAID:能力上限同样取决于硬件架构。
故障隔离/降级运行:硬件提供错误检测、隔离或冗余机制后,BIOS、BMC、OS才能决策恢复策略和降级策略。
2.CPU、芯片组、PCIe 设备的硬件 RAS 能力细节,可查阅 Intel、AMD 等芯片厂商官方文档:
比如:Intel的Software Developer Manual:
AMD的System Programming Manual:
三、BIOS层:硬件RAS能力配置与错误交接
CPU、内存等硬件的RAS能力是否开启、如何配置、如何暴露给OS,很大程度上由BIOS决定。
1.BIOS要正确配置硬件RAS能力
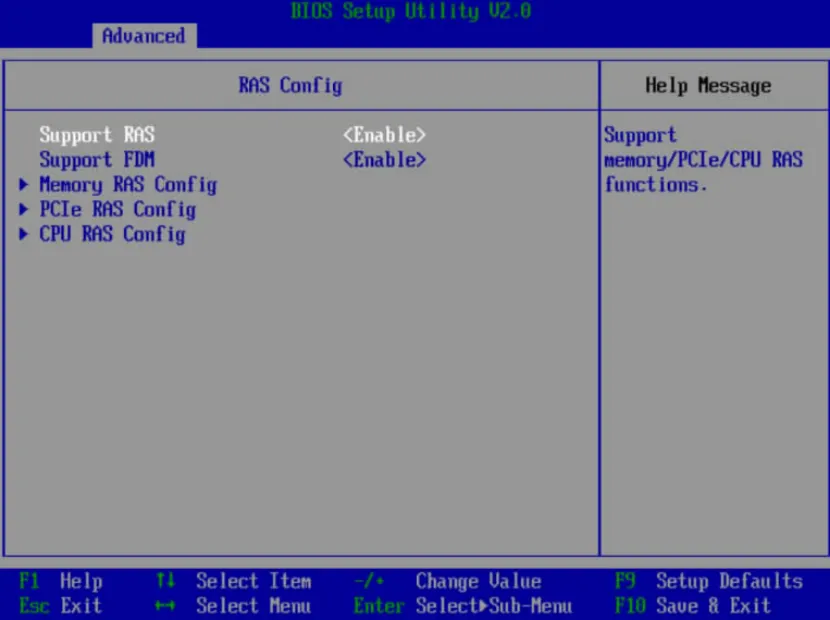
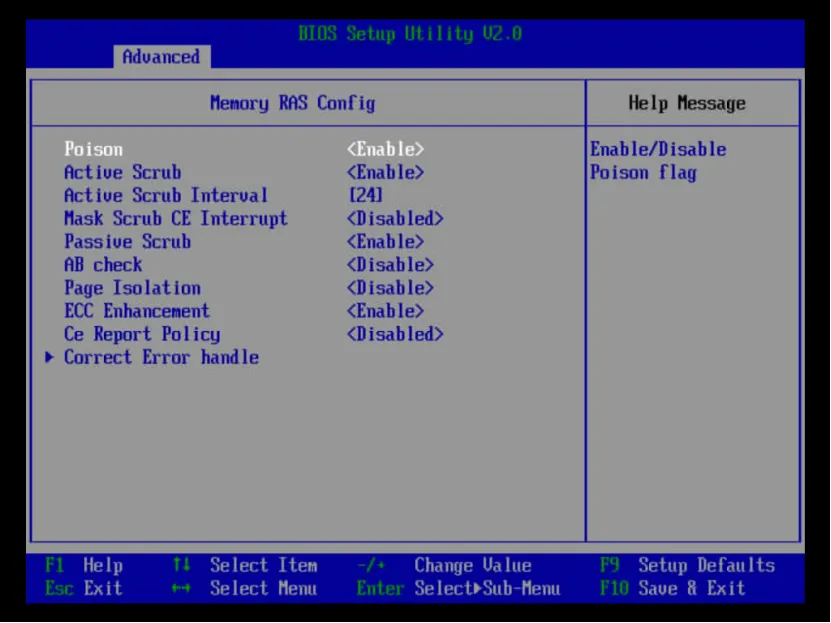
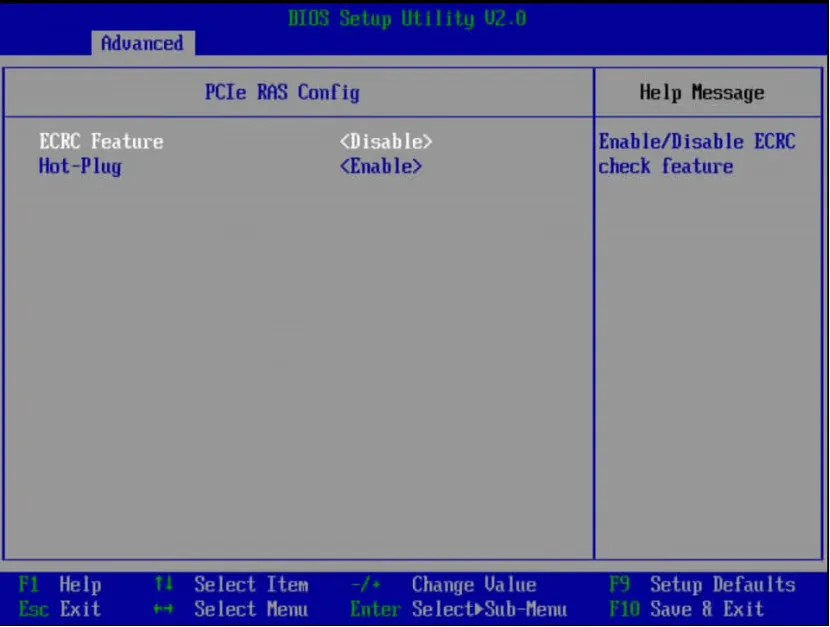
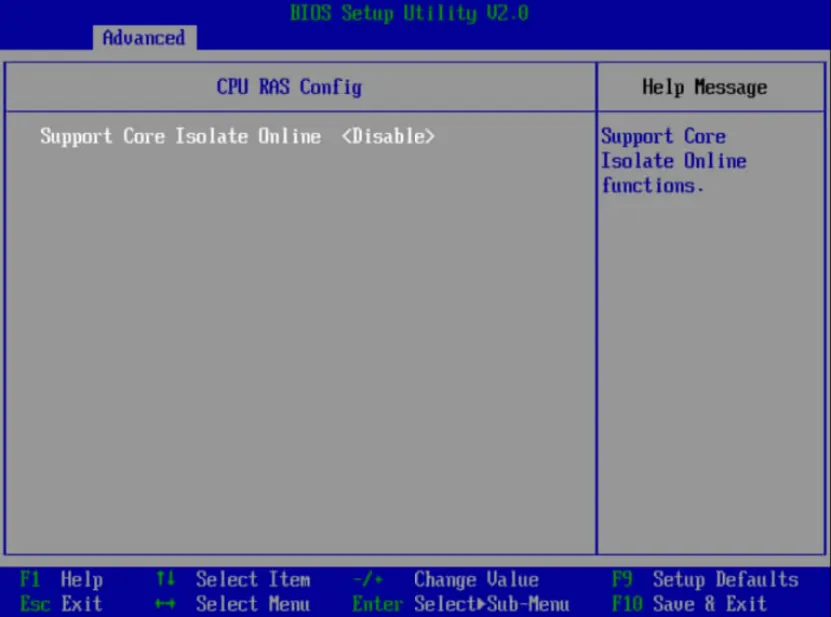
服务器启动过程中,BIOS需要完成CPU、内存、PCIe等设备初始化,同时配置大量RAS相关参数,例如ECC开关、各类错误上报机制、设备热插拔、CPU Core 隔离等。如果 BIOS 配置不当,操作系统将无法使用硬件 RAS 能力。
下图是Taishan服务器的BIOS RAS配置图,读者可以参考:
2.BIOS与OS之间的关键接口:ACPI
硬件错误上报高度依赖ACPI APEI(ACPI Platform Error Interface)相关数据表及接口。
典型运行期处理链路为:
CPU、内存控制器或芯片组检测到硬件错误后,平台硬件/固件生成符合CPER(Common Platform Error Record)格式的错误记录;
BIOS 通过 HEST(Hardware Error Source Table)描述系统内所有错误源,其中GHES(Generic Hardware Error Source)定义通用硬件错误源的状态区域及NMI、SCI 等通知机制;
Linux APEI/GHES 驱动收到通知后,读取并解析CPER 错误记录,再交由相应 RAS 子系统进行日志记录、故障恢复或隔离处理。
ERST(Error Record Serialization Table):主要定义平台错误记录的持久化访问机制,供操作系统读取、写入、清除平台侧持久化错误记录;
BERT(Boot Error Record Table):向OS描述Boot Error Region,使 OS 在启动后能够获取平台在启动阶段或 OS 尚不具备正常错误接收能力时保存的错误信息。
若HEST/GHES 内的错误状态地址、错误源类型或通知方式配置异常,即便即便内存控制器已经检测到 ECC 可纠正错误,也会因为 GHES 通知链路未正确建立,造成 Linux 收不到硬件错误,形成静默失效。
若ERST 配置异常,则平台持久化错误记录无法正常读取、写入或清除。
若BERT 指向的 Boot Error Region 或内部 CPER 数据结构不符合规范,即使 Linux 识别到启动错误记录,也无法正确解析 Section Type、Error Severity、FRU 信息以及具体硬件位置,影响 Memory、Processor、Cache、PCIe 等故障源定位。
3.启动阶段故障处理
服务器上电、POST 和 BIOS初始化阶段也会发生硬件故障,例如DIMM 初始化或 Memory Training 失败、CPU 初始化失败、PCIe Link Training 失败、PCIe 设备枚举异常等。
此时Linux 尚未启动,GHES 等运行期错误通知机制还未就绪,无法依靠Linux 实时接收和记录这些故障。
例如:BIOS 在 Memory Training 阶段发现某条DIMM 无法正常完成训练。
此时怎么办呢?
BIOS可以根据内存控制器返回的错误状态以及CPU、Channel、DIMM Slot的拓扑信息,将故障定位到具体FRU,如 CPU0 / Channel 2 / DIMM A2。
然后,BIOS 可以将能够使用标准 CPER Section 表达的错误组织为 CPER 错误记录,并写入 Boot Error Region,通过 ACPI BERT 将该区域提供给后续启动的 OS;对于平台特有的初始化失败信息,也可采用厂商扩展的错误记录格式。
同时,BIOS还可以通过 IPMI/KCS、Mailbox、共享内存或厂商私有接口,将启动阶段故障信息传递给BMC。BMC 生成 SEL 或其他平台事件记录,并通过Redfish、SNMP 等带外管理接口上报运维管理系统。
如果OS能正常启动,Linux ACPI/APEI 驱动会解析 BERT,读取 BIOS 在 OS 启动之前存入 Boot Error Region 的 CPER 记录,从而获知启动阶段发生的Memory、Processor、PCIe 等硬件错误。
如果故障严重到OS无法启动,例如CPU初始化失败导致系统无法完成POST,或者 Memory Training 失败导致没有可用系统内存,则依靠BMC带外能力保存并上报故障。
4.BIOS RAS开发参考资料
BIOS RAS 开发涉及处理器架构、UEFI、ACPI、PCIe 以及平台定制逻辑,需要结合多份规范与文档。
初学者优先阅读 UEFI Forum 发布的 ACPI Specification,重点掌握 APEI 体系下的 HEST、GHES、BERT、ERST、EINJ 等错误处理机制;结合 UEFI Specification 学习 CPER 标准错误记录格式;通过 UEFI PI Specification 理解 PEI、DXE 等 BIOS 初始化阶段与平台初始化机制。
硬件层面,参考Intel SDM、AMD Processor Programming Reference/Architecture Manual,以及对应处理器 / 平台的 Datasheet、寄存器手册、BIOS Writer's Guide、RAS Feature Guide。
PCIe 相关错误,参考 PCI Express Base Specification 中 AER、DPC、Link 相关章节。
代码实现层面,可阅读TianoCore EDK II 开源 UEFI 项目中 ACPI Table、DXE、SMM、PCIe 模块的参考实现。
在实际服务器项目中,还需要结合OEM/ODM 内部规范,如 BIOS Design Specification、RAS Design Specification、BIOS-BMC Interface Specification 做故障定位。