ARTICLE · 1116659
AI 不只会聊天:一文看懂 LLM 与 Jev 的区别
AI 通俗讲义 · 约 6 分钟
LLM 与 JEV 的本质区别:一个写内容,一个做判断
用一条退货消息,读懂两种 AI 的分工。
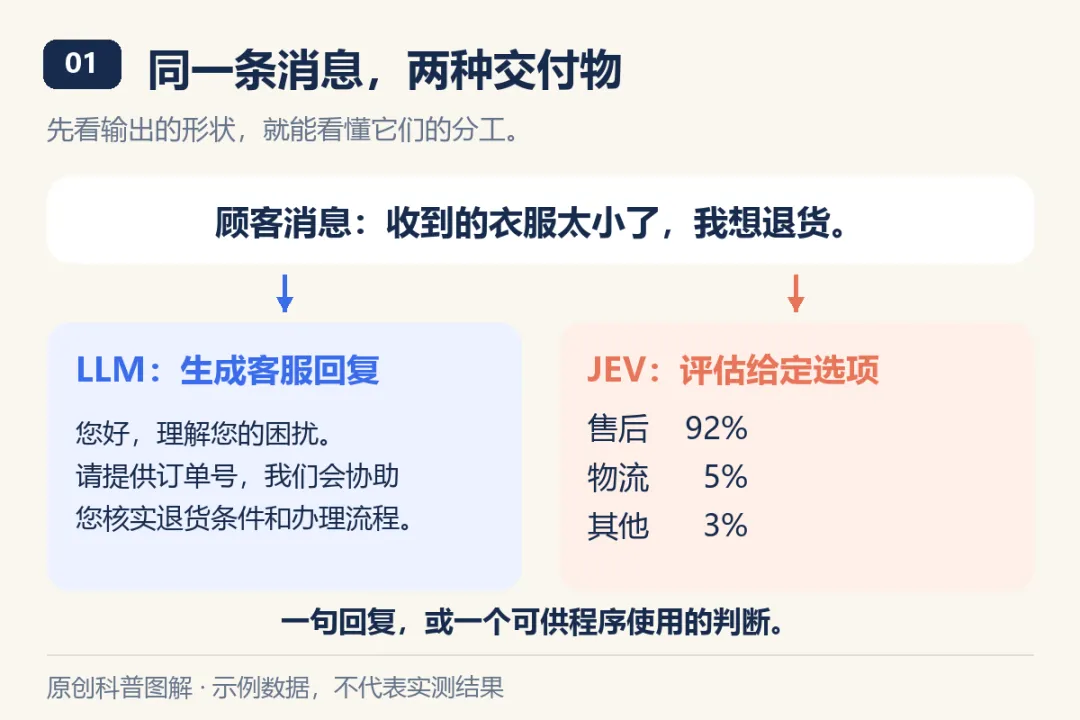
你给 AI 发一句话:“收到的衣服太小了,我想退货。”
它可以写一段客服回复,也可以判断这条消息该交给售后部门。
两件事都需要理解语言,最后交付的东西却很不一样:前者是一段新内容,后者是一个判断。
本文的 JEV 指 TypeSafe AI 的 Jev 决策模型。LLM 是大语言模型这一类别,Jev 是具体产品;下文比较的是常见生成式 LLM 与 Jev 的设计取向。Jev 官方简介
01一个像回复员,一个像分拣员
想象一家电商公司的客服中心。
LLM 更像能写回复的客服。你说“帮我回复这个顾客”,它可以生成礼貌的解释、提醒顾客提供订单号,还能调整语气。
Jev 更像工单分拣员。你先告诉它可选的部门:售后、物流、其他;再让它判断这条消息应该去哪一类。它返回选项和概率,程序就能据此进入相应流程。
“为什么要这么分?请写一段解释。”适合交给 LLM。
“从这几个部门里选一个。”是 Jev 更典型的工作。
它们像不同岗位的同事。这个比喻讲的是分工,并不意味着 LLM 不会分类。
02本质区别:下一段内容,还是给定选项?
常见生成式 LLM 的基本工作方式,是根据已有上下文预测接下来的文本片段,再把新片段接回上下文,继续生成。这些片段叫 token,你可以暂时把它理解成“文字积木”,它不一定恰好等于一个字。
积木一块块接起来,就成了回复、文章、代码,甚至一步步写出的推导。语言模型通过大量训练学到复杂的规律,所以这并非简单背诵或随意接龙。语言模型研究:GPT-3
Jev 的公开定位则是:输入上下文和定义好的问题,直接返回结构化的判断与概率,不生成开放式自然语言。
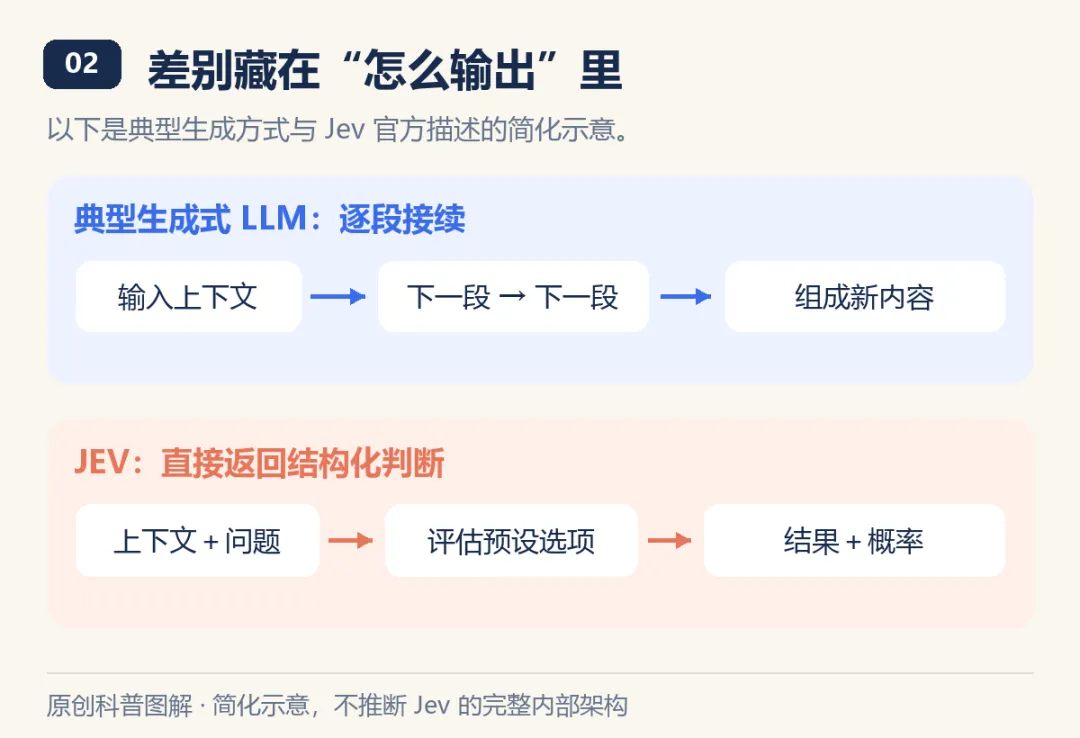
所以,最值得记住的区别是:LLM 主要面对“接下来写什么”;Jev 主要面对“这些答案里选什么、如何打分”。
这里说的是工作方式和目标。Jev 同样使用学习出来的模型判断,不是把一串固定规则换了个名字。官方称其采用新的架构、并行输出方式和训练方法;公开信息也不足以让我们把某个社区复现方案直接当成它的完整内部结构。TypeSafe 发布说明
03它怎样把“判断”交给程序?
Jev 的主要接口可以理解为三个按钮:
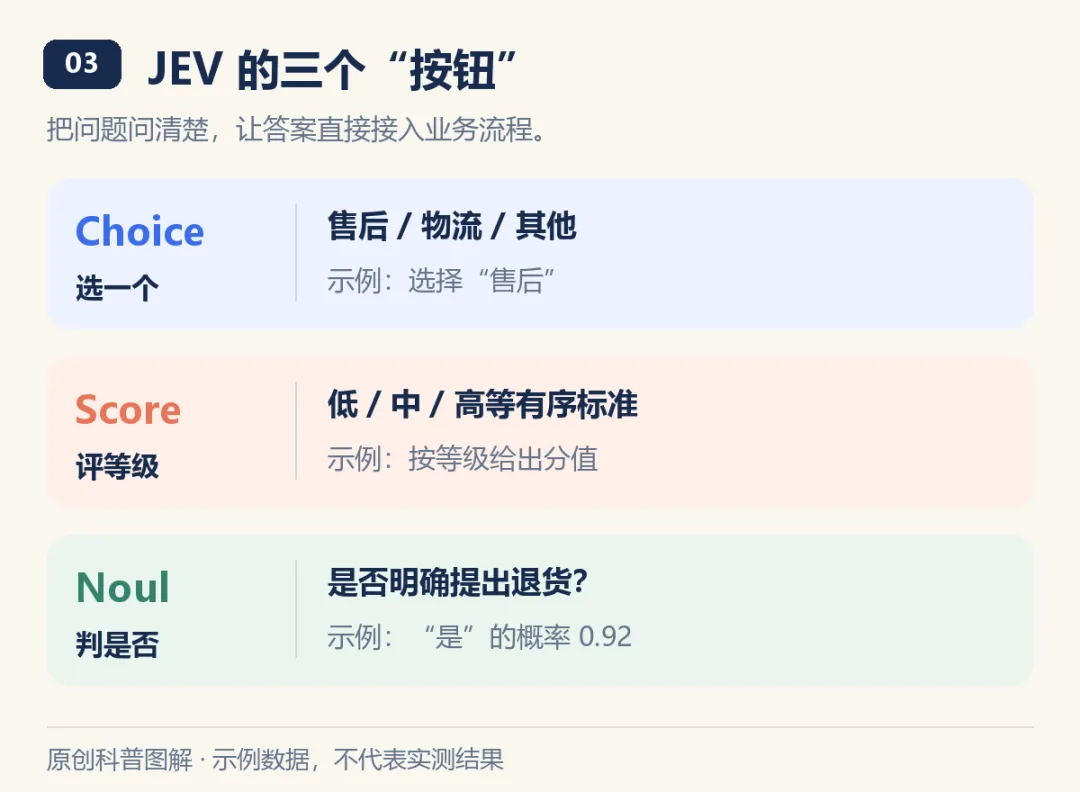
Choice:做选择。比如在“售后、物流、其他”中选出最合适的类别,并返回各选项的概率。
Score:按标准评分。比如先定义“低、中、高”三个紧急程度,再评估消息的位置。标准需要由使用者说清楚,分值也可以落在相邻等级之间。
Noul:判断是否。比如“顾客是否明确提出退货?”返回“是”的概率。接近 1 偏向是,接近 0 偏向否,接近 0.5 表示不确定。它不是另外生成一个“未知”标签。官方问题类型说明
这就像填一张事先设计好的表。填写后的值能被程序直接拿来比较、排序、分流。
04快的价值:很多时候,只需要一个小判断
假设有十万条客服消息,你只想知道它们该分到哪个部门。
如果每条都先生成一段分析,再从分析里提取部门,就可能做了许多额外工作。Jev 把目标放在判断本身,并支持把多个独立问题放在一次请求中并行评估。官方批量提问说明
它的优势因此更容易出现在大量、重复、答案范围明确的任务里,例如工单路由、消息分类和按规则评分。
这不是“快就一定更聪明”。让一个模型写三千字文章,和让另一个模型选择一个部门,交付物本来就不同。具体省多少时间和成本,还要看输入长度、任务难度、比较的模型与部署条件。
05概率和置信度:别把“有把握”当成“不会错”
Jev 官方把训练方法称为 RLCD——面向校准决策的强化学习。名字很长,目标可以用一句话理解:让报出来的概率,更贴近实际发生的比例。
如果一个模型对很多事件都预测“发生概率 80%”,理想情况下,这一组事件应当大约有 80% 真的发生。这叫概率校准。它描述长期统计,不保证某一次一定正确。官方训练与校准说明
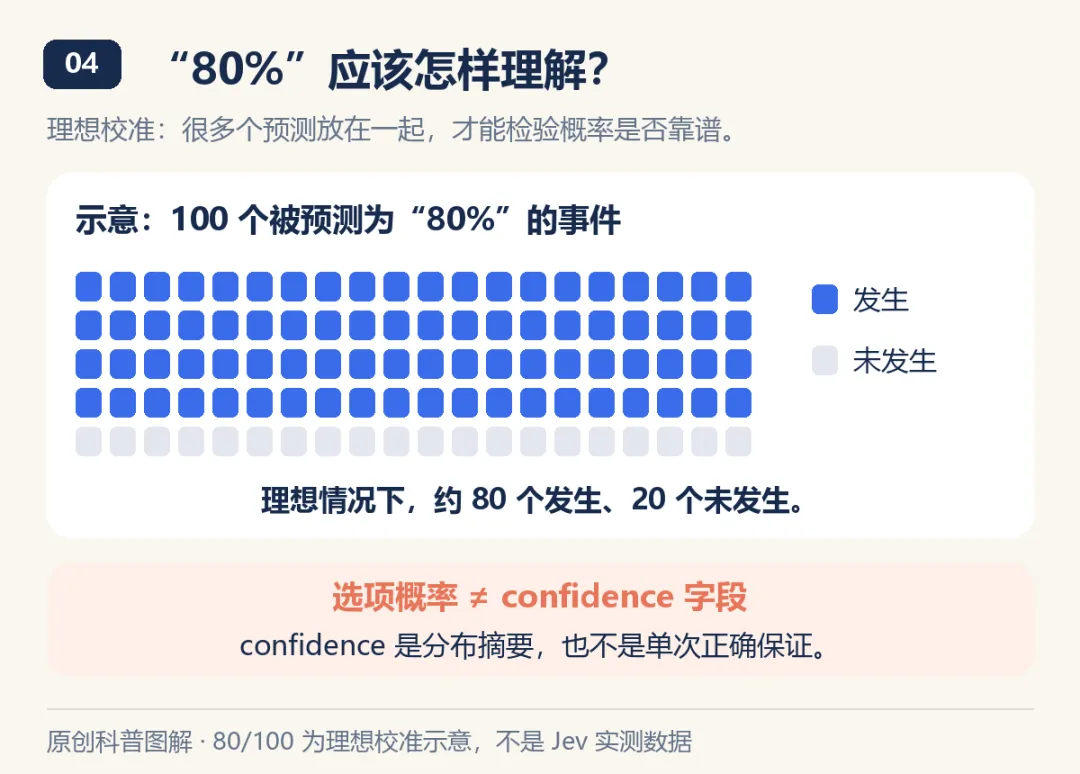
还要区分两个数:选项概率,以及接口里叫 confidence 的字段。后者是对概率分布确定程度的摘要,不等于这个模型在你的业务里能达到的准确率。官方置信度说明
这相当于分拣员除了告诉你“我选售后”,还提供了判断有多明确的信号。你可以据此设计复核流程,但阈值需要在真实业务数据上验证。
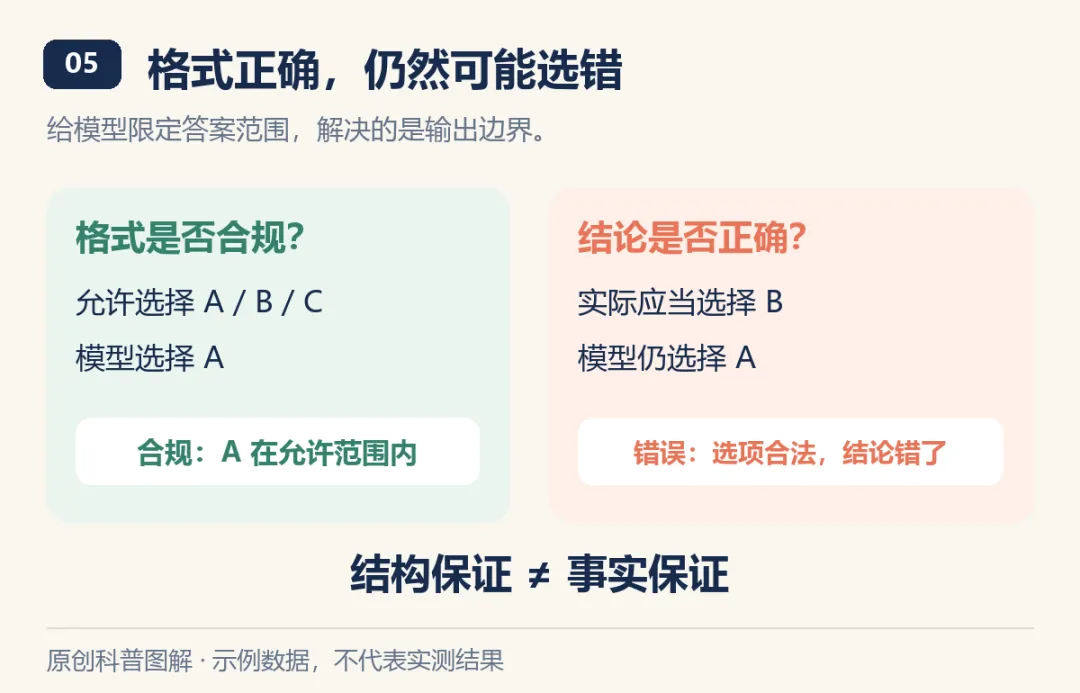
另一个容易误读的说法是“没有幻觉”。限定输出能避免凭空造出一个不在列表里的部门,仍然可能把消息分到错误的部门。
一项近期比较 Jev 与 LLM 评分器的预印本发现,它们在部分任务上会犯相似的错误。因此,先让 Jev 判断、再让 LLM 接管,并不自动带来更高准确率。Jev 与 LLM 评分器比较研究
06LLM 也能做选择,两者可以一起工作
当然,你完全可以让 LLM 只输出“售后”,或使用支持结构化输出的模型,让它按指定格式返回结果。差别不只是“有没有 JSON”,还包括训练目标、输出方式,以及针对哪种任务优化。
只看“会不会分类”,很难选对工具。更好的问题是:我最终需要一段新内容,还是一个有明确范围的判断?
需要写文章、解释原因、生成代码或展开复杂推导,通常更适合生成式 LLM。答案范围清楚、需要频繁做分类和评分时,可以测试 Jev 是否更合适。官方产品定位与对照
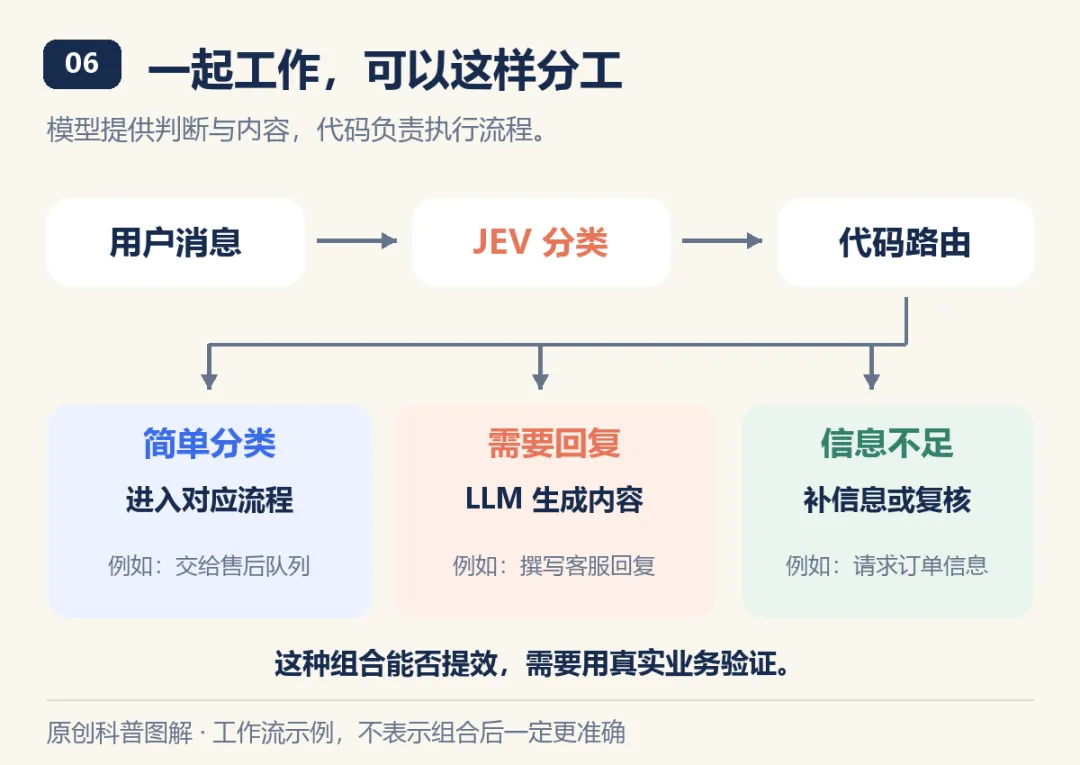
放回客服场景:Jev 判断顾客想做什么,代码把消息交给对应流程,LLM 根据订单信息和退货政策撰写回复。遇到模糊输入,流程再补充信息或转人工复核。
一个提供判断,一个生成内容,软件把它们组织成完整服务。
想让 AI 写出一份新东西,关注它的生成能力。想让 AI 在明确范围里选一个答案,关注它的判断能力。
下一次选择 AI 工具,不妨先想清楚:这一步,我究竟需要它交付什么?