ARTICLE · 1120516
RAG 检索到矛盾文档就翻车?三篇论文给出冲突消解三板斧
有个排查案例是这样的:知识库上了混合检索加重排序,Top-k 文档余弦相似度 0.86,检索指标全绿,可答案是错的。因为上下文里同时躺着一份原始财报和一份审计修订版,模型挑了一份,以 80% 的置信度输出,全程没有任何机制告诉它正在面对互相矛盾的信息。
这篇把这类失败拆开讲:为什么默认 RAG 处理不了冲突,现在主流的几条解法分别在干什么,以及上线时该按什么顺序加。
▍检索器优化的是相关性,不是一致性
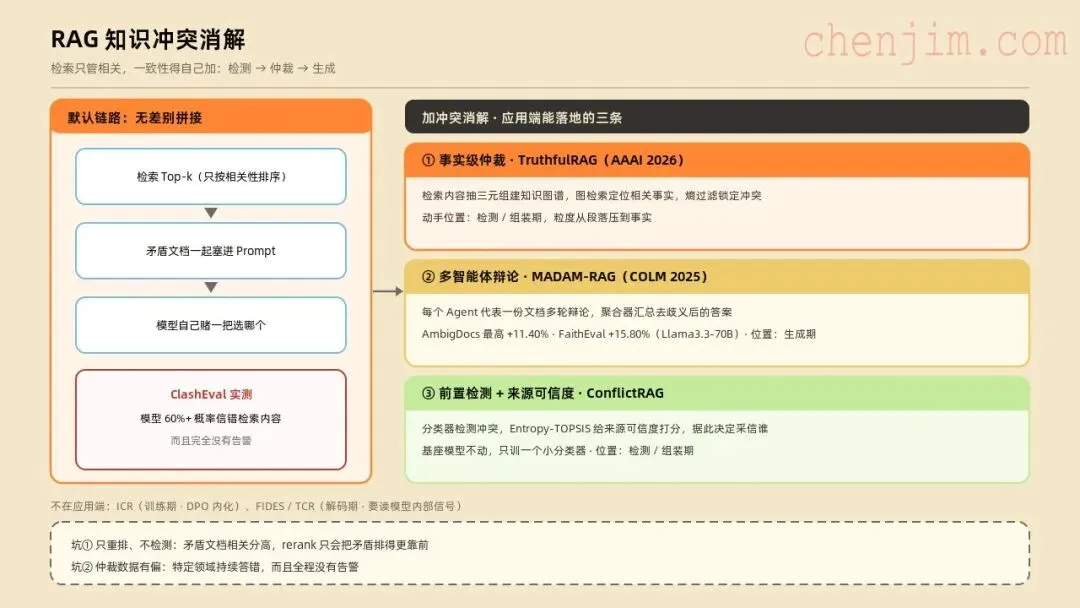
向量检索、BM25、重排序,整条链路优化的都是"跟查询相不相关"。麻烦在于两份打架的文档往往都高度相关:一份旧版临床指南和一份新版指南,跟"该用什么剂量"这个问题的相关分一样漂亮,于是被一起排进 top-k,一起塞进 Prompt。这类冲突有两种:检索内容彼此打架,或者检索内容跟模型自己的旧知识打架。
模型怎么处理这种局面,斯坦福的 ClashEval 测过:1200 多个问题、6 个领域(药物剂量、奥运记录、地点这些),测了含 GPT-4o 在内的 6 个头部模型,结果是模型有超过 60% 的概率采纳错误的检索内容,覆盖掉自己原本正确的知识。还有个附带发现,模型对自己初始答案越没把握,越容易被检索内容带走。
换句话说,冲突消解做得好不好,跟模型强不强关系不大。默认做法是把矛盾文档无差别拼进去,然后赌模型自己选对,按这个数据,赌局赢面四成。
▍应用端能落地的三种解法
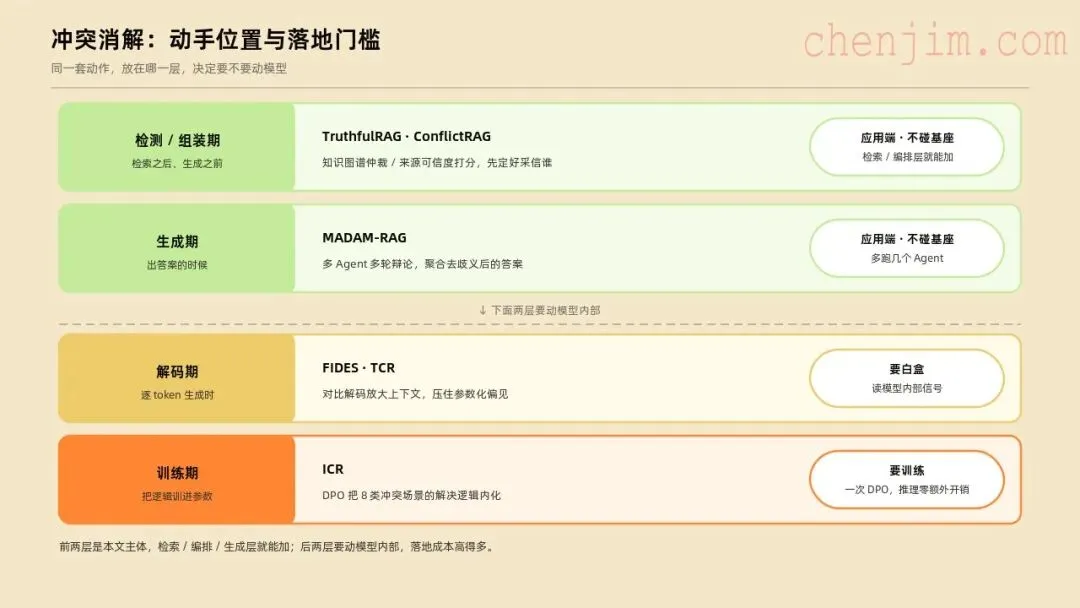
先划边界:这里只讲不碰基座模型、在检索/组装/编排层就能加的东西,对多数团队这才上得了线。要训练或改解码的,放到后面简单提。
三条路对应同一套动作的不同位置:先检测冲突在哪,再拿一份独立于模型的依据做仲裁,最后只把裁定后的结论送进生成。
事实级仲裁:TruthfulRAG(AAAI 2026)
TruthfulRAG 的判断是现成方案都在 token 级和语义级打转,看到零碎差异,抓不到"到底哪条事实冲突"。它的做法是从检索内容里抽三元组建知识图谱,用基于查询的图检索定位相关知识,再用熵过滤精确定位冲突元素,只让不打架的部分进生成。
粒度从段落压到事实,好处是能说清"同一个主语同一个谓词、两个不同宾语在打架",仲裁要的正是这个。
多智能体辩论:MADAM-RAG(COLM 2025)
不建图。多个 LLM Agent 各代表一份文档,就同一个答案多轮辩论,聚合器汇总去歧义后的回答,同时丢掉误导信息和噪声。两个数字值得记:AmbigDocs 上比强 RAG 基线最高提升 11.40%,FaithEval 上最高提升 15.80%(绝对值),两个都是 up to,都在 Llama3.3-70B-Instruct 上测的,脱离这两个限定词引用就是骗人。
同一篇论文提的数据集 RAMDocs 把歧义、误导、噪声三件事同时塞进一个查询,更接近线上真实情况。基线的惨状是 Llama3.3-70B-Instruct 只拿到 32.60 的 exact match。
前置检测 + 来源可信度:ConflictRAG
ConflictRAG 把"先检测、再生成"做成一条完整管线:先用轻量分类器粗筛、再有选择地让 LLM 复核,论文称 API 成本降 62%、检测准确率仍有 90.8%;确认冲突后用 Entropy-TOPSIS 给来源可信度打分,据此决定采信哪份,比人工规则高 7.1%。不动基座模型,只训一个很小的分类器。
三条路横向摆一下:
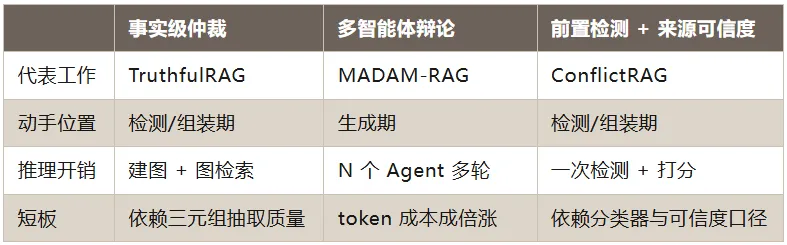
单用哪条都有短板。实际系统一般先做冲突检测兜底,高价值查询再叠辩论。
▍不在应用端的思路(简单提一下)
要动模型内部或训练的做法更彻底,但落地成本高得多。偏好内化这一类(ICR)用 DPO 把 8 类冲突场景的解决逻辑训进参数,一次训练、推理零额外调用,短板是覆盖不到训练时没见过的冲突;解码期干预(FIDES 等)不改权重、也不额外调 LLM,靠对比解码压住参数化偏见,但要读模型内部信号,纯 API 调不动。
▍两个坑:一个少做,一个做歪
只做重排序、不做冲突检测,就是开头那个案例的成因。矛盾文档相关分高,rerank 只会把它们排得更靠前,等于发了张优先入场券。检测必须插在检索之后、prompt 组装之前,放到最后,模型已经带着两套结论开始编了。
另一个坑是消解模块自己有偏。如果用来仲裁的数据偏向某类来源,它会系统性偏爱那一侧,导致 RAG 在特定领域持续输出错误答案而且没有任何告警,因为每一步置信度都很高。医疗、法律、金融最容易踩,也最难发现。工程上的应对手段是按来源维度切片看准确率,总分看不出问题,某一类来源被偏爱只反映在切片里。
▍上线的先后顺序
先上冲突检测,插在检索后、组装前。成本最低,收益是把"无差别拼接"变成"至少知道有冲突"。 给输出加证据标注,哪条结论来自哪份文档。没有这个,冲突发生了也没法事后复核。 仲裁依据必须外部独立,来源可信度表、知识图谱、熵都行,唯独不能让模型自己评"你更信哪个",那是在让被告当法官。 评测用现成的。AmbigDocs 有 36098 例,FaithEval 有 4900 题(ICLR 2025),ClashEval 和 RAMDocs 也都公开,用它们才知道自己离及格线差多少。
多智能体辩论放最后,先把检测和标注做扎实,再考虑花几倍 token 去辩论。
说到底,冲突不是模型不够强,是检索目标里压根没有"一致性"这一项。检测放组装前,仲裁依据放模型外,评测用公开基准,这三件做到,RAG 才算能采信。
你们的 RAG 系统有没有遇到过两份文档打架的情况,最后是怎么发现的?评论区聊聊。
觉得有用的话,点赞👍 + 转发↗️ + 推荐❤ + 关注⭐ 一键四连,下次找起来方便,也能让更多人看到。