ARTICLE · 1120506
Laya 源码解读:Jev 们的开源样本
Laya作为Jev"系列"的经典之一,它解决什么问题?工单分诊、内容安全、agent 调工具前的风险评估、搜索重排、量表打分——这些环节不需要模型说话,只需要模型判断:要快、要便宜、输出受控、置信度能当门限。现在的做法是让生成式大模型输出 JSON,一次分类要走完整个逐 token 生成,慢且贵,输出可能越界,报的置信度和真实命中率没有关系。决策模型的回答是:判断这件事,本来就不该用"生成"来做。整条链路一句话:
state + 问题 schema → 单次前向(不生成 token)→ 每个候选选项一个概率 → 结构化决策一、先看格局:品类成立,数字打折,两条路线
品类成立。 Jev 只提供三种决策原语:choice(最多 255 个选项里选一个)、score(有序量表打分)、noul(布尔判断,返回 P(true),名字是 Bernoulli 的缩写)。答案空间在请求发出前就声明好,模型在构造上不可能输出 schema 之外的值——官方因此宣称结构化输出错误率 0%,但注意这是定义性的:格式安全和判断正确是两回事,模型完全可能自信地选错一个合法选项。发布两周内,从 API 到网关(Vercel 称 24 小时内近 13% 付费团队启用,史上最快)到数据仓库(Databricks 原生 SQL 函数 ai_decide),三层基础设施全部跟进。不管 Jev 这个模型最终怎样,"决策模型"作为品类成立了。
数字打折。 官方说最高快 193.6 倍、省 444 倍;第三方系统评测(49 个任务的公开基准,外加近八千条人工标注的预注册研究)的口径是:中位约 7 倍快、30 倍省,准确率与中价位 LLM 持平、落后前沿 6.5–11.5 个百分点。方向成立,数字缩水一个数量级,知道折扣率就好。
两条复刻路线。 Hugging Face 的 Niels Rogge 发帖推测 Jev 的解码方式:context 和 schema 一次性 prefill 进 KV cache,然后只读你关心的那几个 token 的 logits,全程不生成。这个推测直接变成了配方,两天内六个复刻分成两派。一派是 LoRA 路线,代表 Bespoke Labs 的 Nimble:拿现成的 9B 生成式模型微调,让每个答案恰好是一个 token(字母码),算概率时只投影候选 token 对应的那几行输出层权重,全词表其余十五万个 token 根本不算;训练数据靠对比式策展——造两条只差一个关键事实、答案因此翻转的样本对,逼模型学会哪条证据该改变决策;在 13 个人工标注数据集上跑到 Jev 的 98%(74.8% 对 76.0%)。另一派是 encoder 路线,就是 Laya:不碰生成式模型,直接拿 ModernBERT 这种双向编码器,从零训练一个专用决策头。分野很干净:Nimble 复用大模型的泛化、开箱即用,但背着 9B 的体量;Laya 极致小快、随处自托管,但零样本接近随机,必须微调才能用。
二、先讲框架:Laya 凭什么快
以下基于我对 Laya 仓库(v0.3.4)的完整通读。核心就三个文件:common.py(模型结构和奖励函数)、agent.py(推理)、router.py(多模型路由)。
先说传统做法慢在哪。让生成式大模型做分类,相当于让人用写作文的方式回答选择题:它要一个 token 一个 token 地把答案"写"出来,每写一个词都要把十五万词的词表整个过一遍,写完你还要从这段话里把答案挑出来。你要的只是一个判断,它的算力大头花在了"说话"上。
Laya 把这件事改成了涂答题卡。底座 ModernBERT 是双向编码器,粗略理解就是"只读不写":把整段输入读一遍,给每个位置算一个向量,本身没有生成能力。输入被构造成一张答题卡:
[CLS] 题型: 问题 [SEP] [MASK] 选项A [MASK] 选项B [MASK] 选项C [SEP] 待判断文本 [SEP]每个选项占一个 [MASK] 格子。模型把整张卡读一遍,决策头在每个格子上打一个分数,softmax 之后就是各选项的概率。三种题型各返回各的:choice 返回胜出选项和每项概率;score 返回期望档位,可以落在两档之间;noul 返回一个 P(true)。以"agent 想删生产数据库,先做风险评估"为例:
agent.system_one( state="用户请求删除生产数据库,理由是测试数据没用了。", questions={ "risk": {"t": "choice", "options": ["低", "中", "高"]}, "reversible": {"t": "noul"}, # 这个操作可逆吗 }, ) # risk → choice: "高",附每项概率和置信度 # reversible → noul: 0.02工程上的用法是拿概率当门限:置信度不够就升级给人。"要不要升级"这件事本身也被做成了模型的一个输出头,第三节讲。
快的来源就这么简单:没有逐 token 生成,没有全词表投影,421M 的小模型把文本读一遍就出结果,多个问题还能排在同一张卡上一批读完。官方自报数字(Tesla T4,不含模型加载):英文 checkpoint 单问 39.5ms,多语 checkpoint 单问 32.8ms、批量 10 问摊到每问 7.2ms。
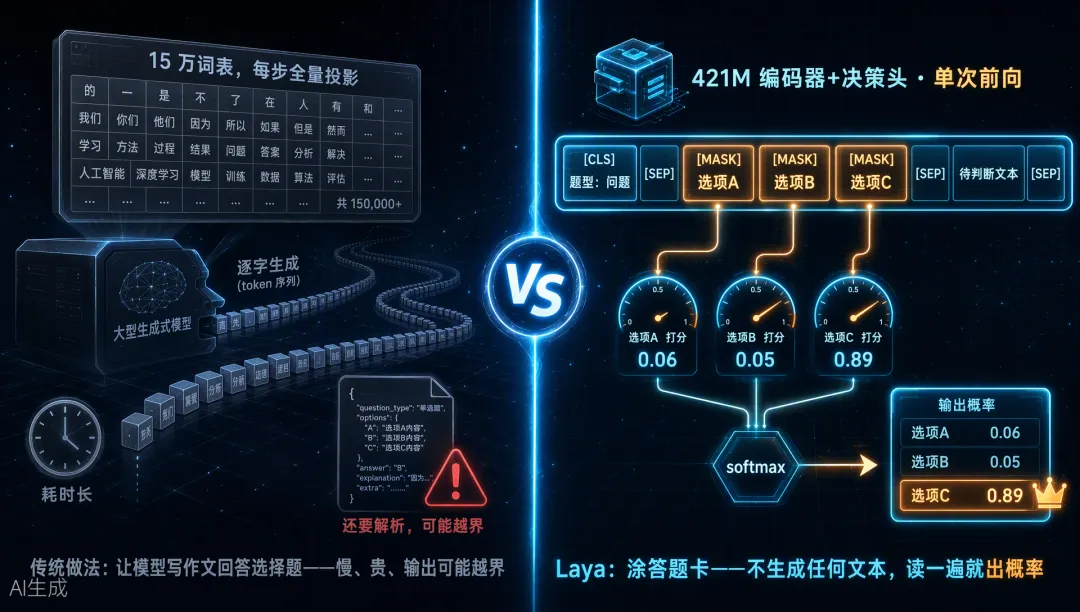
传统生成 vs Laya 答题卡打分
三、拆源码:一条调用链,五个设计决策
3.1 从请求到概率
一次 choice 调用经过的环节:
Agent.system_one(state, questions)( agent.py)接收文本和问题 schema;build_sequence()( common.py)把每个问题拼成答题卡,记录每个[MASK]格子的位置(marker_pos);超预算的选项文本在这一步被按比例截断;collate_items()把 N 个问题 pad 成一个 batch,一次前向全部答完; DecisionModel.forward()里,编码器读卡,决策头再过两层, torch.gather按marker_pos取出每个格子的向量,scorer压成每格一个标量;回到 agent.py:按(题型, 选项数)查分桶温度,缩放,softmax,组装输出。
整条链没有一步在"生成":输出是 Python 直接从 logits 组装的,不存在"生成再解析"的断裂面。
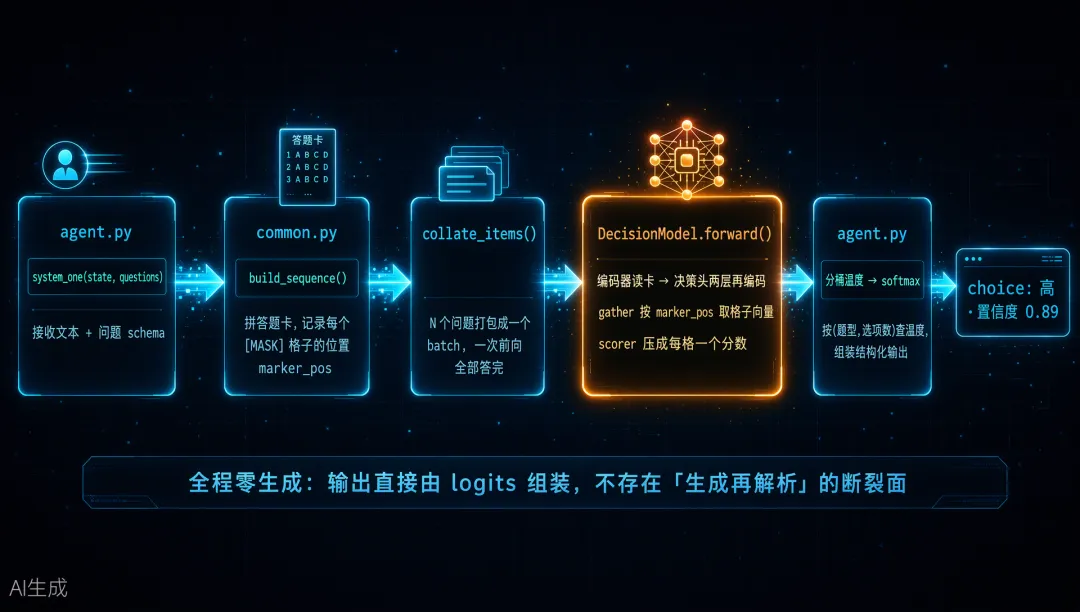
Laya 调用链:从请求到概率
3.2 为什么是每个选项一个格子,而不是一个分类头
决策头的代码很短:
class DecisionModel(nn.Module): def __init__(self, encoder, head_layers=2, ...): self.encoder = encoder # ModernBERT-large,395M self.head = nn.TransformerEncoder(...) # 2 层 transformer,再编码 self.type_emb = nn.Embedding(3, d) # choice/score/noul 题型嵌入 self.scorer = nn.Sequential(LayerNorm, Linear, GELU, Linear(d, 1))编码器读卡,head 再过两层,scorer 把每个 [MASK] 格子的向量压成一个分数;type_emb 把题型作为嵌入加到每个位置上,让同一台机器读三种卡。决策头 26M 参数,加编码器一共 421M。
这里有两个值得追问的设计(作者没有写设计文档,以下是我的推断,但代码结构支持这个读法)。
第一,为什么不用常规的 [CLS] 分类头?因为分类头把"类别"编码进权重:类别数固定、每个类别的语义靠训练学进去,加一个选项就要改权重、重训。而 Laya 守的不变量是"选项数在请求时定义"——选项就是普通文本,写进答题卡里,模型比的是"这张卡上哪一段文字更匹配待判断文本",选项本身是输入的一部分。理论上加选项不用重训,代价由下一小节说明。
第二,为什么 encoder 之上还要再叠 2 层 TransformerEncoder?编码器的输出是"读懂文本"的通用表示,但决策需要选项之间的相对比较。head 的 self-attention 让各个 [MASK] 位置再互相看一遍——"选项 A 比选项 B 更贴切"由此变成一个可计算的比较,而不是三个孤立的打分。这两层是"阅卷机"和"阅读器"的分工边界。
3.3 格子区宽度是写死的:高基数分类崩掉的根因
Laya 在 Banking77(77 类意图分类)上只有 0.425,Jev 是 0.870。看着像能力差距,但 README 自己承认这是输入预算的架构约束:选项区的宽度是写死的(英文 192 个 token,多语 256),塞不下就按比例压缩每个选项的文字。77 个选项分 192 个 token,每项只剩 3 到 4 个 token,选项名字写不全,阅卷机自然分不清。待判断文本的预算同理:整张卡总长 512 或 1024,选项区拿走一块,剩下的才轮到正文。作为对照,Jev 的上下文是 32K。
在当前 checkpoint 和输入构造下,选项超过 20 个、单问超过 1024 token 会快速进入低可靠区。这不是调参能救的,选型之前先量自己的场景。
3.4 分桶温度和置信度
推理代码里直接可见:
t_scale = self.temperature_by_options.get(temp_bucket(qtype, k), ...) z = logits / t_scale # 按 (题型, 选项数) 分桶的温度 p = softmax(z)为什么要分桶?温度校准是拿验证集给输出"定标",但 2 选 1 和 20 选 1 的 logits 尺度天然不同——选项越多,分布越平,单一温度两头都顾不好。Laya 做得比同类细:按题型和选项数各拟合各的温度,官方自报的出厂 ECE(概率与真实命中率的差距,越小越好)从 0.466 压到 0.081。
置信度也不取最大概率,而是用归一化熵 confidence = 1 - H(p)/log(k):分布越集中置信度越高,且对选项数归一化,2 选 1 和 20 选 1 的置信度可比。对照一下:Nimble 的温度是后补拟合的,新 checkpoint 干脆没校准,模型卡专门警告别复用旧温度。在"概率能不能信"这个问题上,Laya 是三家里工程上较真的那个。
3.5 RLCD:没有生成的模型怎么做强化学习
训练目标是整个仓库里值得逐行读的部分,也是容易被一带而过的部分——因为这里有个表面矛盾:GRPO 是生在"采样一批生成结果"场景里的算法,Laya 不生成任何东西,强化学习学什么?
拆开就清楚了。Laya 的"动作"不是 token,而是它报告的那整个概率分布。每次前向,模型对一组选项输出分布 q,这个动作直接拿到奖励:
log_score = (target * log(q)).sum() # 对数得分 sph = (target * q).sum() / q.norm() # 球面得分 r = log_score + w_sph * sph # score 题再减一项排序概率得分:用 CDF 差距惩罚有序档位上的分布错误这两个得分都是严格适当评分规则(strictly proper scoring rule),数学性质是:只有你报告的概率等于你的真实信念时,期望得分才最大——吹牛和过分谦虚都扣分。直觉可以看对数得分:假设你心里认为答案正确的概率是 p,却报告 q,期望得分对 q 求导,极值点恰好在 q = p。考试规则被设计成"诚实就是最优策略",概率的可信度是被训练目标逼出来的。
有了动作和奖励,GRPO 的角色就明确了:在同一批(组)样本内把奖励归一化成优势——比同组平均答得好且诚实,梯度就推你一把——再用策略梯度回传到决策头的 logits。不需要采样多种回答,因为概率分布本身就是"一次交出所有可能回答的权重"。这就是"GRPO 风格"的含义:借它的组内基线,不借它的生成。(源码没有单独注释组划分细节,这段是按 GRPO 的标准做法对 proper_reward + 策略梯度代码的重建,读源码时可以对号入座。)
仓库里还有一个 TD(λ) 实现,把多轮对话轨迹的奖励往前回传,配合一个预测"该不该升级给人类"的动作头(act_head),让同一个引擎能在对话里每步决定要不要 escalate。微调闭环作者也做成了现成的:官方 Kaggle notebook,双 T4、四五个小时、约三万问,跑完建数据、RL 训练、温度拟合、评估全流程。
提醒一个术语陷阱:开源社区至少有两个叫 RLCD 的东西,Laya 这个和另一个同名项目的算法不是一回事,它们跟 TypeSafe 未公开的 RLCD 也都不是一回事。引用这个词的时候留心。
3.6 Router:为什么路由必须在读卡之前
Laya 有三个 checkpoint:英文(421M,512 上下文)、多语(322M,1024)、typed-decisions 微调版。Router 负责按输入自动选一个。
为什么需要它?README 里有一组数字:英文 checkpoint 跑非英语任务,不是温和退化,是崩塌且自认高置信。20 选项任务上,印地语正确率 0.100(随机基线 0.050),置信度照报不误;高棉语正确率 0.000,平均置信度 0.952。全错,且自信地说自己全对。这个组合直接否决了一种天真的工程方案:"先跑英文模型,置信度低再换多语模型"——失准的模型不知道自己失准,置信度门控救不了你,路由必须在第一次读卡之前就定下来。
Router 的实现因此做得很保守:主信号是纯 Python 的 Unicode 区间统计(26 个脚本区间,0.5ms 以内,零依赖),拉丁文字内部再用停用词启发式猜语言,且要求非英语以明显优势赢过英语才改判——宁可把法语误判成英语,不能把英语误路由走。typed-decisions checkpoint 从不静默启用:只有显式打开自动检测、且问题 id 集合精确匹配四个预定义工作流之一才会选它。模型常驻用 LRU 管理,文档明说如果只允许常驻一个模型而请求在语言间交替,会导致每请求重载(CPU 上中位 7.4 秒),生产环境必须预热。每个路由决定都带完整理由,可审计。
四、亲手验证:零样本到底差到什么程度
纸面结论读完,我在本机跑了一遍。环境:一台 Apple Silicon 笔记本,纯 CPU,Node 版 ONNX 运行时,英文 421M checkpoint,fp32 权重 1.6GB。模型加载 4.2 秒,首次调用约 600ms,热机后单问中位 105.4ms——官方"Apple Silicon CPU 三问约 140ms"的量级属实,速度宣传可信。
但质量是另一回事。三个 case,全部零样本、未微调、未校准:
| noul 0.8909(判安全) |
第三个 case 值得停一秒:一个高危操作被零样本模型以 0.89 的概率判为安全——而护栏恰恰是决策模型宣传里的典型用途。README 里"零样本接近随机,别直接用"不是谦辞,是字面事实;微调和温度校准是上线前提,不是优化项。这也是我推荐这个项目的原因:一个 30k stars 的项目敢把这句话和"自己垫底的基准行"放在 README 里,它放出来的其他数字反而可信。
当然也有摩擦:ONNX 运行时首次使用要下 1.6G 权重;没有 GPU 的机器上第三方实测延迟崩到过几十秒;typed-decisions 的启用条件藏得深,不看源码很容易以为自己已经在用微调版。这个项目适合愿意把 README 读完的人。
五、设计边界与选型
把三家的局限放在一起看,比单独看任何一家都清楚。
出厂概率不能直接当门限。 Laya 出厂未校准时严重过自信(3.4 节的数字);Nimble 校准前平均置信度 0.89、实际命中率只有 73%;Jev 在分布外两个方向都错。共同教训:拿 50 到 300 条自己业务的标注数据拟合温度,是上线前的必要步骤。成本很低,不做的代价很高。"校准是后处理,不是属性"——以后看到任何模型输出概率,第一个问题应该是:温度拟合过了吗,拿什么数据拟合的。
能力边界各不相同。 Laya 高基数(>20 选项)和长上下文(>1024/问)是架构层面的硬约束;Nimble 背着约 18GB 的 9B 体量;Jev 开箱即用但闭源,校准无公开证据。要开放还是要开箱,目前只能选一个。
黑箱问题属于整个品类。 Simon Willison 的批评我基本同意:LLM 至少能被要求解释理由,决策模型只返回一个浮点数,可解释性是倒退的。凡是涉及对人打分的场景(招聘、信贷),决策模型的输出只能当参考信号,不能当结论。官方文档也承认不擅长数字、日期和对抗性内容——这类判断留在代码里。
上线前别只看准确率。 在自己的数据上至少过这几项:ECE、Brier、分置信度区间的真实命中率、覆盖率与准确率的交换曲线,以及分语言、分选项数、分文本长度的分项表现。
六、课后随想
不变量驱动设计在 Nimble 和 Laya 身上各有所施展。Nimble 的不变量是"答案必须恰好一个 token",于是有了扫遍整个词表挑双字母码这种看着别扭、实际干净的做法。Laya 的不变量是"选项数在请求时定义",于是有了 [MASK] 打分的决策头,以及由此而来的格子区预算这个阿喀琉斯之踵。同一个问题,守住不同的不变量,长出两种完全不同的架构。架构设计里难的不是选方案,是想清楚哪个不变量不能破——以及愿意为它在别处付什么代价。
在Jev“系列”陆续出现后,出现了很多推崇的声音和观点,但我认为其最有价值的是它的架构设计,可以解决日常随线性增长的场景实现范围收缩,存在不少值得尝试的混合使用场景。
最后设立一个开放问题:你的系统里那些分类、打分、护栏环节,现在是让 LLM 顺便做的,你会考虑换成专用决策模型吗?门槛和顾虑是什么?评论区聊聊。