ARTICLE · 1125185
AI Infra 早报|llama.cpp 让推测解码按概率验收草稿
📅 2026-10-04
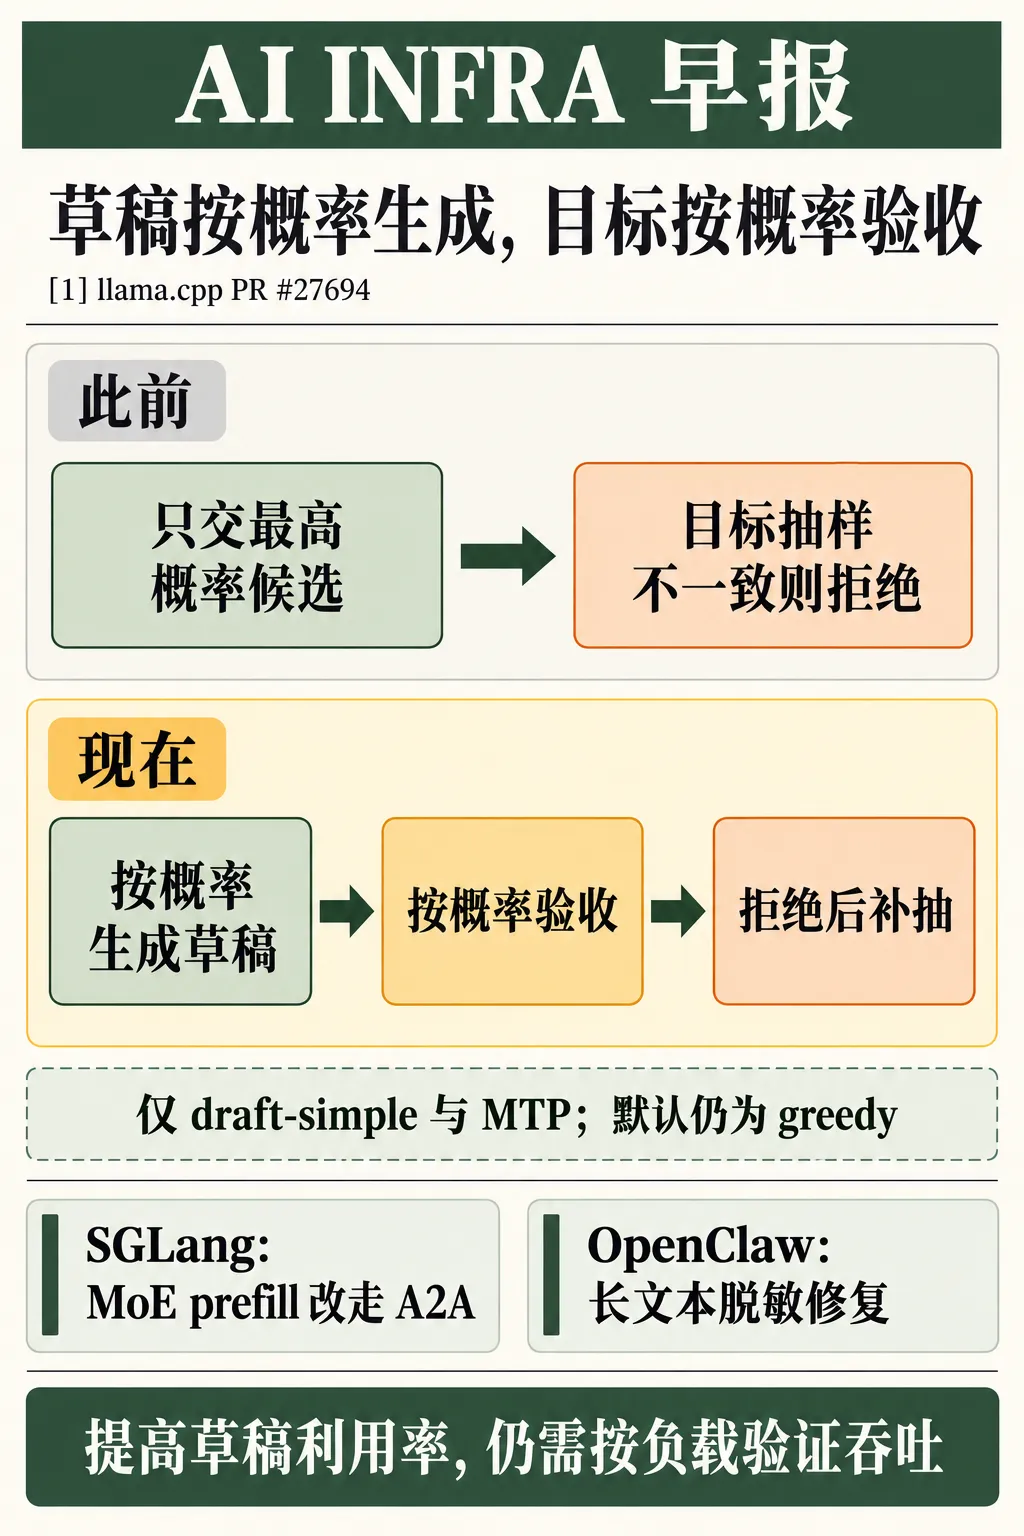
llama.cpp 的新版本改了推测解码的验收方式。使用非零温度生成时,草稿模型终于能按概率交候选;今天看懂它为何能多接住草稿,又为什么默认还没打开。
今日头条|草稿不再只交最有把握的答案
推测解码让小模型先猜几个 token,目标模型再一次验收。一次接住的草稿越多,目标模型就越少单独生成。此前 llama.cpp 的 draft-simple 和 MTP 草稿器虽然运行了采样器,实际仍只交最高概率候选;目标模型在非零温度下随机抽样,两边常常选不中同一个 token。[1]
10 月 2 日合并的 PR #27694 改了两步:草稿模型按自己的概率分布抽候选,目标模型用拒绝采样决定是否接收。若拒绝,它再从修正过的剩余分布补抽。多接住草稿的同时,目标模型原本的输出分布仍需保持。 这项改动已进入 10 月 3 日发布的 b11368。[1][2]
PR 给出一组明确条件的测试:RTX 5090 上,Llama-3.1-8B 搭配 3B-Q8_0 草稿模型,温度 0.8,草稿上限 3;每次运行 12 个各 256 token 的样本。相比旧路径,平均接受长度增加 14.35%,吞吐增加 15.40%。这些数字只说明该测试配置的结果,不能当成所有服务负载的加速比例。 温度 0 的对照组,接受长度没有变化。[1]
新参数 --spec-draft-sampling 仍默认 greedy,需要主动切到 probabilistic。目前只覆盖 draft-simple 和 MTP;Eagle3 尚待评估,DFlash 在 PR 实验中未受益。运行固定输出或高并发服务的人,应先检查自身模型、温度与请求长度,再决定是否启用。[1]
另外两条动态
SGLang 合并了 MoE prefill 的通信路径调整。此前指定 FlashInfer A2A,普通 prefill 仍可能走 all-gather 加 reduce-scatter;现在可直接使用 A2A。PR 在 4 张 B300、GLM-5.2-NVFP4、每 rank 4096 个 prefill token 的配置下,报告 trtllm_routed 输入吞吐增加 6.1%。较小批次原本已走 A2A,收益接近持平;这项增益有明确负载边界。[3]
OpenClaw 修复了长工具输出的日志脱敏:旧实现按 16,384 字符无重叠切块,跨边界的凭证可能漏检,异常重复串还可能卡住主线程。新实现完整扫描内置规则,PR 中特制压力样本的耗时从 6,105 毫秒降至 60 毫秒。这是已合并的修复,正式版收录仍待确认。[4]
接下来关注
下一步看 llama.cpp 在更多草稿模型和真实并发请求下,平均接受长度与端到端吞吐能否一起提高。先在固定模型、温度和请求长度上对比两种模式,再决定是否启用概率草稿。
一句话结论:概率草稿能在非零温度下提高候选利用率,但收益要按模型和负载实测。
更多完整证据和技术细节,请点击文末“阅读原文”。
延伸阅读
参考
[1] llama.cpp PR #27694:概率草稿与拒绝采样:https://github.com/ggml-org/llama.cpp/pull/27694
[2] llama.cpp b11368 Release:https://github.com/ggml-org/llama.cpp/releases/tag/b11368
[3] SGLang PR #39818:MoE prefill 使用 FlashInfer A2A:https://github.com/sgl-project/sglang/pull/39818
[4] OpenClaw PR #161480:长文本日志脱敏修复:https://github.com/openclaw/openclaw/pull/161480
Less hype · more systems.
MiracleFarms · BRIEF · DAILY