ARTICLE · 1127475
你改了文档,Agent 知道吗?一个 DSH 插件让你一眼看清
你有没有遇到过这种情况:你让 Agent 读了一篇文档,它给了你一个答案。过了一会儿,你改了那篇文档里的一个数字。然后你又问 Agent 一个相关的问题,它还是基于旧版文档在回答。
你不知道。它也不知道你改了。
这不是 Agent 的问题,是我们没有一个地方能看到:这篇文档,Agent 到底读了没有?读的是哪一版?读完之后有没有被改过?
很多工具在这个问题上是空白的,少数会替你猜一句"Agent 还不知道最新版"。但这句话其实是猜的。你怎么知道它不知道?也许它刚好又读了一次呢?
我做了一个插件,叫 Knit。它不猜。它只写三个字:"读后已更新。"
Knit 是什么
Knit 是 DeepSeek Harness(简称 DSH)的插件,目前只跑在 DSH 上。它做两件事。
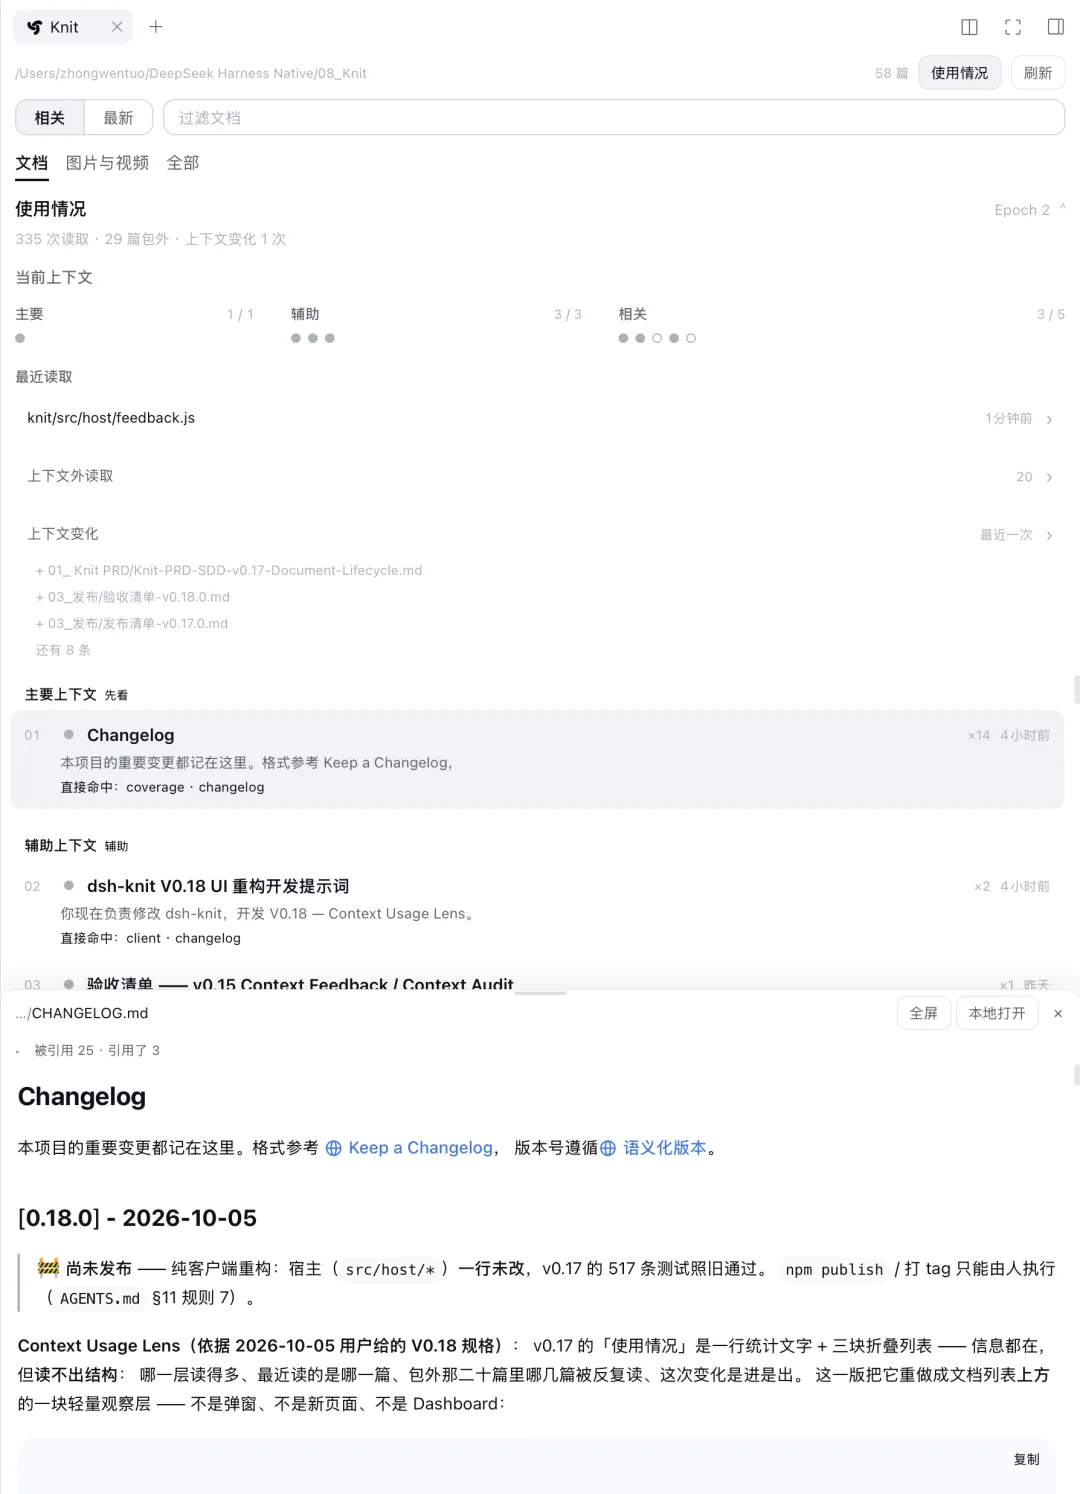
第一件,在右侧栏列出你工作区里所有的 Markdown、图片、视频,按你当前正在聊的内容排序。你正在聊架构,架构文档就浮上来;你正在聊竞品,竞品分析就浮上来。不需要你输入搜索词,它跟着对话走。
第二件,把同一份排序也给 Agent 当工具用,叫 knit_docs。Agent 问"哪几篇相关",拿回来的不只是排名,还有每篇里命中的那段原文。
这两件事用的是同一份排序。你看到的和 Agent 拿到的,是同一篇文档。我管这叫"人 Agent 同构"。
听起来简单,但大多数工具做不到。要么只给人看一个文件列表,Agent 自己去 glob 去 read;要么只给 Agent 一个检索工具,人看不到 Agent 在看什么。两边是脱节的。
相关性怎么算
没有玄学,就是字符串运算。
三步。第一步,读当前会话最近 6 条真人用户消息。注意是真人输入的,Agent 自己塞进来的合成上下文不算,那会把话题带偏。越新的消息权重越高,3、2、1、1 这样递减。
第二步,抽关键词。英文词取值很高,出现一次就要,比如 chokidar、mtime 这种精确词。中文用 2 字和 3 字的词组,需要出现两次,或者出现在最新那条消息里。靠首字和尾字的虚词判据丢弃跨词边界的碎片,比如"的文"这种。
第三步,BM25 打分。字段权重是标题乘 4、摘要乘 2、正文前 2500 字乘 1。再叠 10% 的时间新鲜度,7 天窗口。
零模型、零联网、零依赖、零 token。文档不出本机。
我知道你会问:BM25 够吗?不用向量吗?
我做过评测。21 个用例,旧的"加权命中" top-1 准确率 76.2%,BM25 达到 95.2%。MRR 从 0.830 涨到 0.976。对工作区文档这种短文本、专业术语密集的场景,BM25 够用了,而且可复现、可审计、零成本。
向量不是不能加,是现在不需要。加了向量就要建索引、就要嵌入、就要维护,复杂度上去了,收益不一定有多大。
v0.17.0:文档读完之后,现在处于什么状态
前面几版回答的是:Knit 推荐了什么、Agent 有没有读、读落在哪一层。
这一版接着回答:一篇文档被 Agent 读完之后,现在处于什么状态。
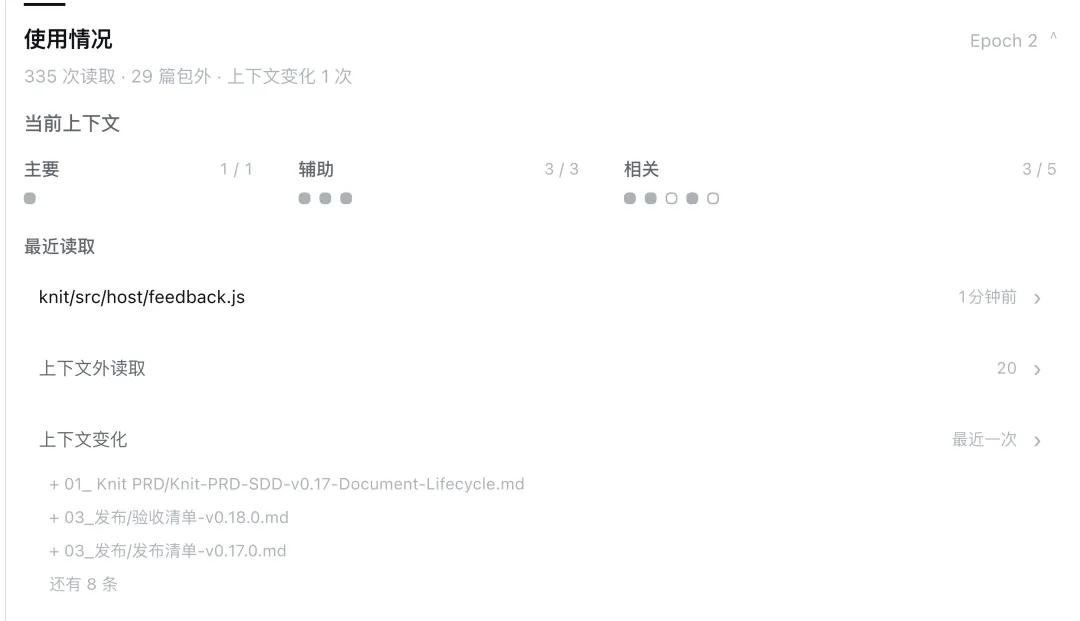
只做四件事:文档状态、最近读取、包外读取明细、最近一次上下文变化。
检索侧一行没改。BM25、IDF、关键词抽取、长度归一化、freshness、分层、Context Pack 装配规则,一个字没动。没有分数、没有百分比、没有进度条、没有时间线、没有新面板、没有第二份存储。
四个事实状态
未读:本会话没有一次成功的 read
已读,或者已读乘 N:有过成功的 read,且最后一次成功读取之后文件版本没变
读后已更新:最后一次成功读取之后,文件的修改时间变过
修改后已重新读取:变过之后又成功读过一次;再变一次就退回上一档
判据复用现有工作区扫描拿到的修改时间,不引入内容哈希、不扫描全文、不新增索引、不落盘。
事实就是事实,不做推断。状态只说"文件在上次成功读取之后变过",不写"Agent 还不知道最新版",也不写"Agent 没看到你的修改"。这两句话我在测试里钉死了,不允许出现。
grep、glob、bash 不算 read。失败的 read 不算。拿不到修改时间时不下结论,宁可停在"已读"。文件只是被重新扫描过,不等于被重新读过。
三个轻量功能
最近读取:显示最近一次成功 read 对应的文件和相对时间。不叫"正在阅读",因为 Knit 无法证明 Agent 此刻还在读这篇。
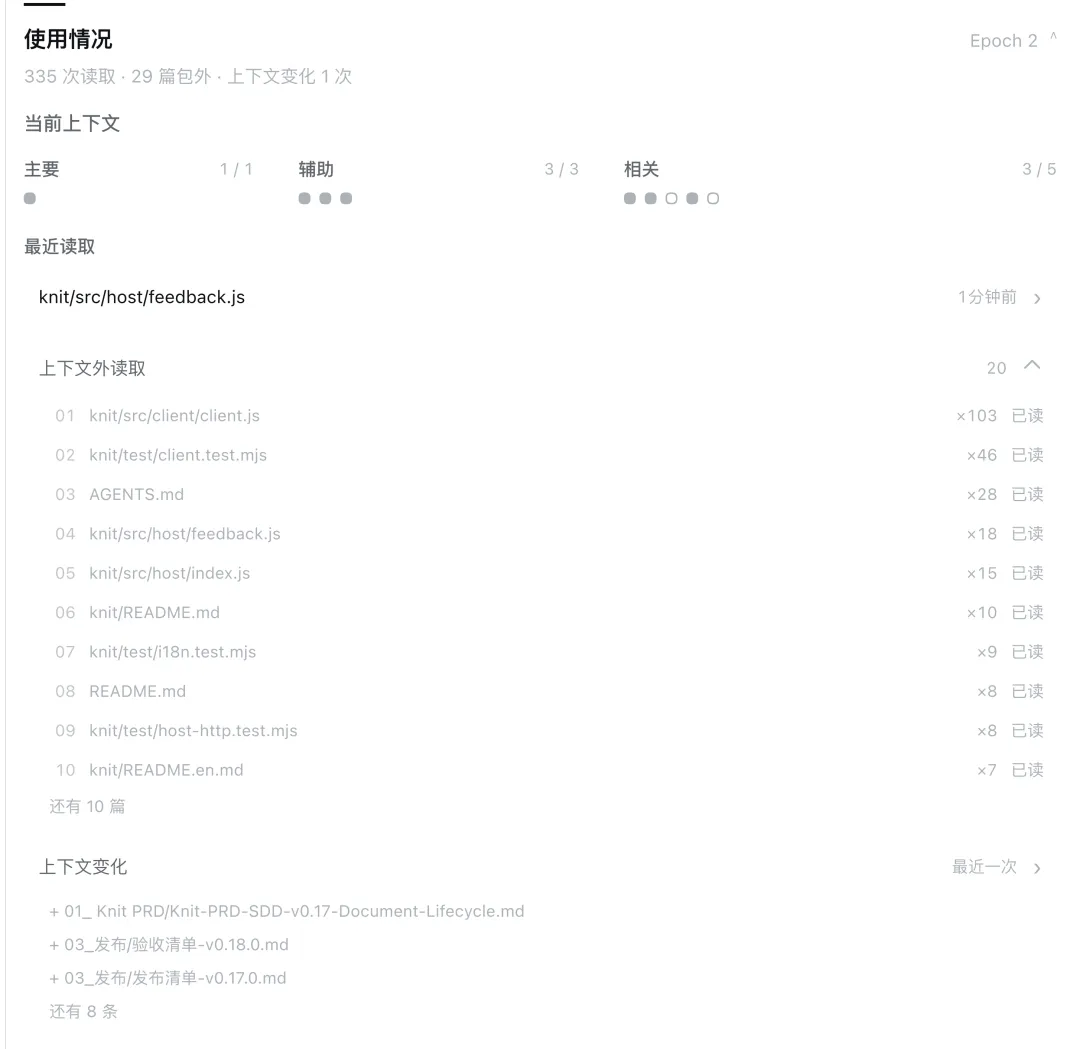
上下文外读取:原来只有一个数字,现在点得开,看得到是哪几篇。只表达"这篇不在当前推荐包里,但 Agent 确实成功读过它",不写"Knit 漏掉了",也不做漏召回率。
上下文刚刚变化:只展示最近一次变化,哪篇进入了、哪篇离开了、哪篇换了层。不产出时间线。
使用情况默认关。关着的时候不发请求、不初始化生命周期、DOM 里零新增节点。你不需要它的时候,它什么都不做。
这一版 517 项测试全过。
只做事实,不做推断
你可能觉得,这也太克制了。为什么不直接告诉用户"Agent 还不知道最新版"?
因为那是猜的。
Agent 读了一篇文档,你改了它。Agent 可能不知道,也可能刚好在你改了之后又读了一次。Knit 只看到"文件在上次成功读取之后变过",这是事实。"Agent 还不知道"是推断,Knit 没有证据。
做产品的人都知道,推断一旦说错一次,用户就不信你了。但事实不会错。文件变了就是变了,你自己判断 Agent 知不知道。
这也是为什么没有进度条、没有百分比、没有分数。这些东西看起来高级,但都是推断。"这篇文档相关度 87%"是什么意思?87% 是怎么算出来的?用户看不懂,也信不过。
Knit 给的是理由码。每篇文档下面写一行"为什么":命中了哪个词、在标题里还是正文里、出现了几次。你自己判断这篇该不该排这么高。
可复现、可审计、零成本。这比一个黑箱的百分比可信得多。
诚实的代价
说一个不太好听的真机数据。
我做过对照实验。冻结协议、4 道题、同一个 50 篇文档的工作区,Control 组和 Treatment 组各跑 4 次。Treatment 组的 Agent 可以调 knit_docs 工具,Control 组不能。
结果是:能调 knit_docs 的 Agent,工具调用次数反而更多了。Control 组平均 4.75 次,Treatment 组 6.0 次,算上 knit_docs 本身是 7.0 次。唯一消掉的是 glob,但 read 从 1.75 次涨到 3.75 次,distinct files 从 1.5 涨到 2.75。
步数没省,反而多了。
但四条答案全对。
这说明什么?说明 knit_docs 没有让 Agent 变快,但让 Agent 找对了文档。它读了更多的文件,但读的都是对的文件。Control 组可能 glob 到了一个错误的文件,基于错误的文件给了一个错误的答案,只是看起来步数少。
所以 Knit 的卖点不能落"提效"。它没省步数。
卖点是"对齐"。你和 Agent 永远在同一篇正确的文档上。你看到的右侧栏第一篇,就是 Agent 拿到的第一篇。你知道它在读什么,它读的是不是最新版。你不会在不知情的情况下,和 Agent 基于两份不同的文档在讨论。
这比省几步重要得多。
生态位
市面上也有其他做 Agent 上下文的工具。
最接近的是 zvec-ai 团队开源的 zg,同样是本地优先的工作区检索,同样用 BM25。区别是 zg 需要用户主动输入搜索词,Knit 是跟着对话自动排序;zg 支持代码、精确匹配和向量语义,Knit 只做 Markdown、图片、视频;zg 需要建索引和本地向量嵌入,Knit 零索引零模型。
再往上一个量级是火山引擎开源的 OpenViking,用文件系统范式做上下文数据库,管记忆、资源、技能三件事,需要服务端、建索引、向量嵌入和 LLM 生成摘要。Knit 只做文档发现这一件事,零模型零索引,第一天就满。不在一个量级,但解决的是同一个大问题的不同切片。
在 DSH 生态里也有类似方向的插件。比如 deja-vu,索引 35 个编码工具的会话历史做找回,Knit 做工作产物发现,两者互补。下载量都不大,但占了各自的位置。
Knit 目前只支持 DSH。不是不想支持其他 Agent,是 Codex 和 Claude Code 的沙箱不允许插件订阅 Agent 的工具调用事件。你连 Agent 什么时候 read 了哪个文件都不知道,Document Lifecycle 就无从谈起。这种深度集成,只有 DSH 这种开源宿主才跑得起来。
小,但独一份。
收尾
如果你也在用 DSH,也遇到过"Agent 到底读了哪篇"的困惑,可以试试 Knit。
安装命令是 dsh plugin --profile web add dsh-knit。源码在 github.com/PolinniZhong/dsh-knit。
它不会让 Agent 变快。但它会让你知道,Agent 在读什么、读的是不是最新版、你和它是不是在同一篇文档上。