ARTICLE · 1128335
AI4Paper:AI速搜 + 文献图谱 + 知识库,一站完成找文献、论文精读和综述整理
关键词刚输进去,结果页就出现几百篇论文。
标题看起来都相关,摘要也都能沾上边。你先下载了30篇,打开第一篇读了两页,又担心错过更重要的;换到第二篇,发现研究对象不一样;继续往后翻,半天过去了,仍然不知道哪几篇应该先读。
真正让人疲惫的,不是论文太多,而是没有一个从“搜索结果”走到“核心阅读清单”的判断过程。
这篇就用一个具体场景说明:如何在 AI4Paper 里从一个研究问题出发,先建立材料池,再沿引用关系校准,最后留下真正值得优先精读的论文。
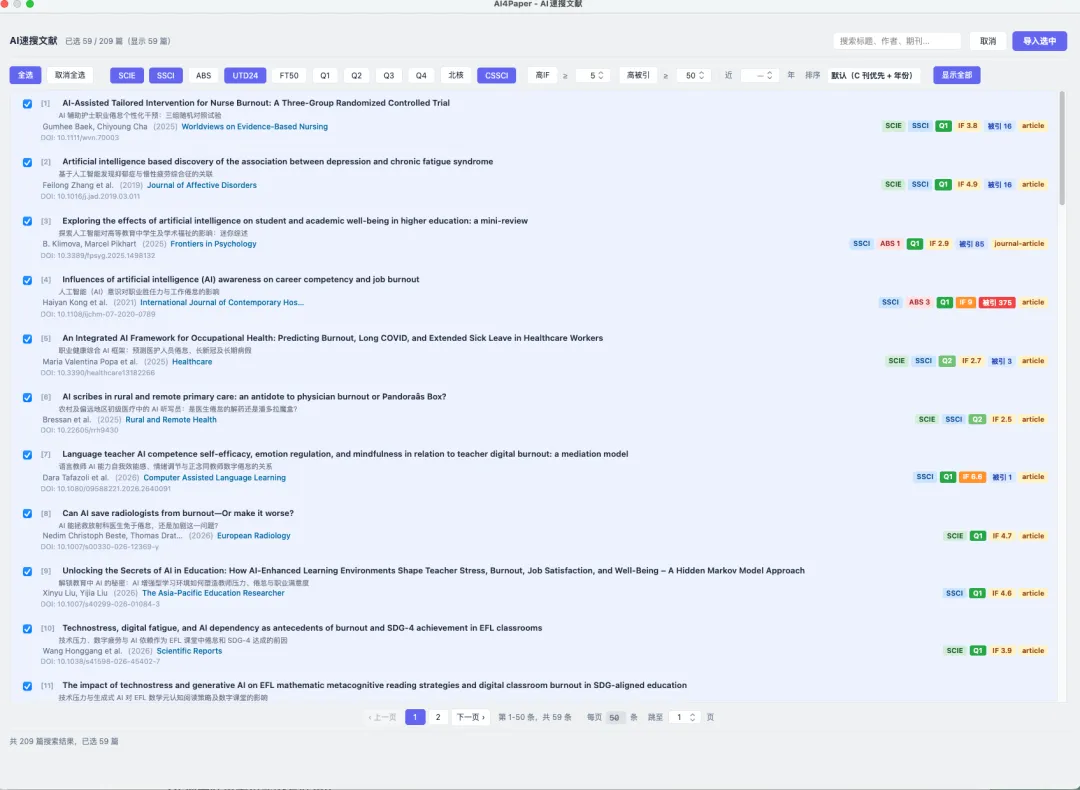
01|先看研究位置,再决定精读顺序
找文献和读文献不是同一个任务。
刚进入一个方向时,需要先判断这个领域有哪些研究路线、关键论文在哪里、最新研究沿着哪条路线继续。等范围清楚以后,再把时间投入到真正影响研究判断的论文上。
| AI速搜 | ||
| 引文追踪 | ||
| 重点精读 |
如果一开始就把搜索结果从第一篇读到最后一篇,阅读时间会被大量“看起来相关、实际回答别的问题”的论文占满。
先确定论文在研究脉络中的位置,再决定它是否值得逐页精读。
02|从一个具体问题建立候选材料池
假设你研究“生成式AI使用是否会通过技术压力影响高校教师倦怠”。
不要只输入“生成式AI 教育”。可以把研究对象、核心变量和关系表达清楚,再分别尝试中文、英文关键词,或者粘贴一篇高度相关的论文标题,让系统提取关键词并寻找相似研究。
第一轮筛选,重点看什么?
① 研究对象是否真的是高校教师,而不是泛泛讨论学生或企业员工;
② 论文是否讨论技术压力、工作负荷或职业倦怠之间的具体关系;
③ 方法能否支持它声称的结论,而不只是概念讨论;
④ 它是否能成为继续追踪参考文献与施引文献的可靠起点。
AI4Paper可按年份、来源、收录、影响力与被引等条件缩小结果,但分区和被引不能代替相关性判断。
这一轮不需要得到最终清单。目标是先找到三到五篇与你的问题高度贴合的种子论文。
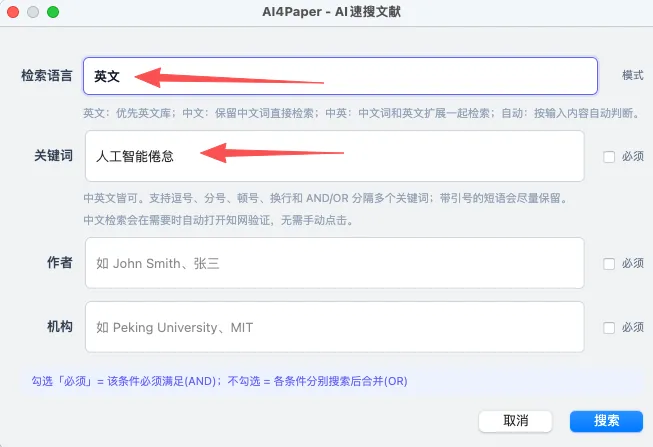
关键词、具体研究问题或论文标题,都可以作为检索起点
03|找到一篇相关论文后,继续追它的上下游
一篇论文的标题和摘要,只能告诉你它研究了什么;引用关系能告诉你,它从哪里来,又被谁继续推进。
参考文献里常常藏着理论来源、经典量表和早期证据;施引文献则可能出现最新验证、不同情境、反例和方法修正。
使用“与当前文献相关”或“以当前文献开始”,可以从已经确认相关的论文继续扩展,而不是每次回到搜索框重新猜词。
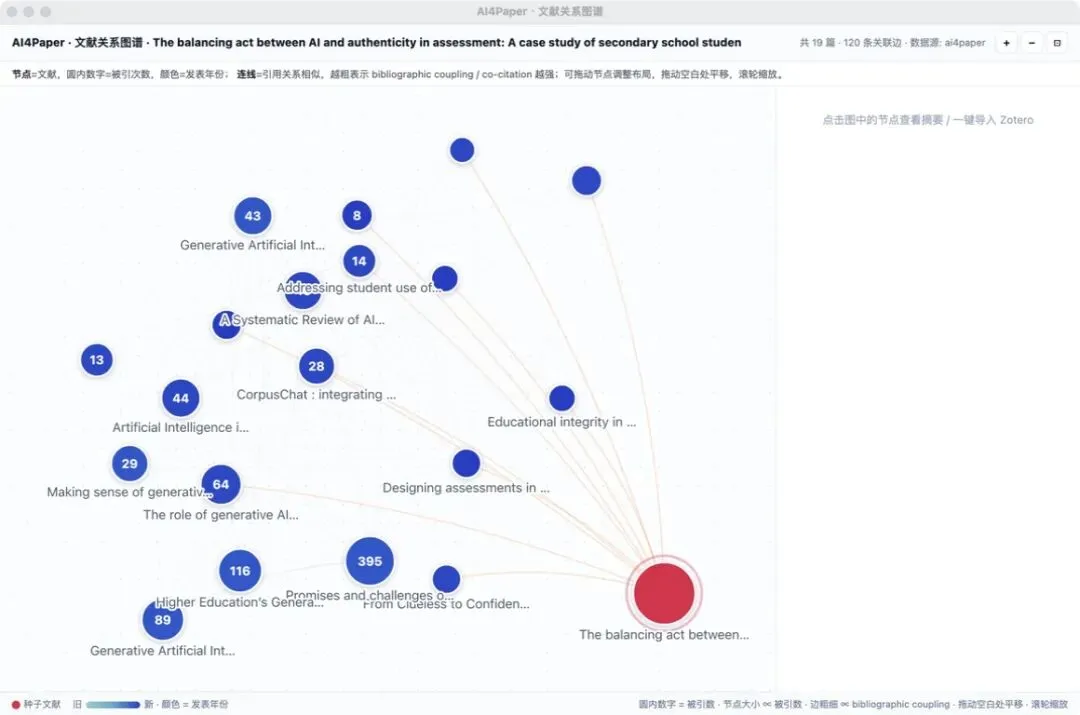
关系展开以后,重点保留哪几类论文?
高被引不等于一定要精读;真正优先的是能够改变你研究判断的论文。
04|把300篇结果,收缩成一份可执行的阅读顺序
最后留下的“10篇”,不是一个固定数字,而是一份能够覆盖关键研究位置的核心清单。
可以先保留两篇理论或方法基础论文、三篇与你对象和问题最接近的代表性研究、两篇近期进展、一到两篇结论相反的论文,再根据研究方向补足遗漏。
先读基础论文,知道概念和方法从哪里来;再读代表性研究,理解主流证据;随后读最新与异常论文,确认结论在哪些条件下被修正。
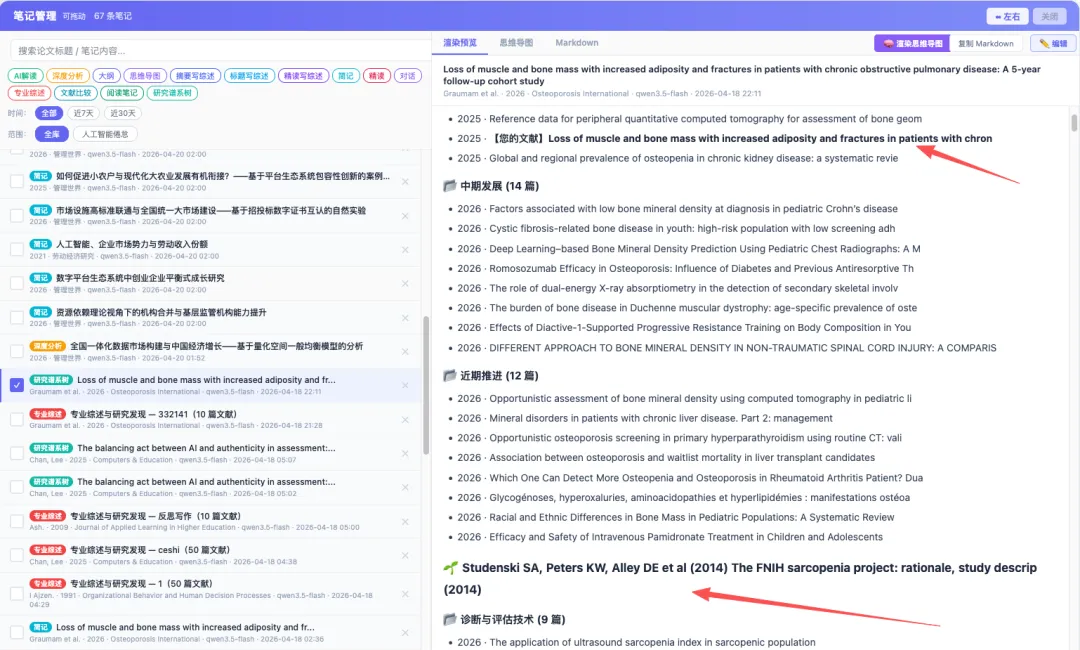
先检查核心清单是否覆盖主要研究方向,再进入逐篇精读
这套流程的重点,不是让AI替你宣布“这10篇最重要”,而是让每一篇被保留下来的论文都有清楚理由。
搜索负责扩大可能性,关系图谱负责看清位置,研究者最终负责决定证据是否值得使用。
当你能说清“为什么先读这篇、它与其他论文是什么关系、它能回答什么”,搜索结果才真正变成了研究材料。