ARTICLE · 1128848
华为OfficeAce升级:AI办公从单打独斗变团队作战
01 · 单模型为什么会胡说八道
让一个AI讲林黛玉倒拔垂杨柳,它真能煞有介事地讲下去。这笑话背后是个真问题:单一模型面对复杂业务,很容易陷入一本正经的幻觉。
原因不复杂。一个模型单次输出,没有第二个人帮它复核,错就错到底。我们把它当全能助理,但它既不知道你的上下文,也没人提醒它这句不对。
我复盘自己踩过的坑:让AI写周报,它把我没做的事写成已完成;让它算数据,它把口径搞混还给出漂亮结论。单模型缺的,正是被质疑这一环。
更麻烦的是,单模型没有代价感。它答错了不会丢饭碗,所以常常自信满满地把错的讲成对的。职场里一句错的结论传出去,补救成本远高于多花两分钟复核。我后来养成习惯,凡是AI给的关键数字和引用,一定自己再对一遍原始出处,把它当实习生而不是老专家,反而用得更稳。
02 · 多智能体怎么像团队一样工作
OfficeAce这次的核心叫专家思辨团。你下一个任务,不是一个AI闷头写,而是好几个不同角色的AI专家坐在一起讨论、争论、互相补漏洞。
更关键的是团队里设了专门的审查者角色,并内置factcheck事实核查技能,最后才输出结论。相当于给AI配了个质检,先挑完错再交给你。
我注意到一个细节:它不再追求秒吐千字,而是追求答得稳。这在办公场景太重要了,老板要的是靠谱,不是快。
当然,团队作战也不是万灵药。多个AI讨论,耗时和算力都更高,简单问题不必兴师动众。我的体会是,重要、复杂、要对外交付的任务才值得开思辨团;日常碎活,单模型够快就行。分场景用,才不会为可靠性付出没必要的成本,也别为了显得高级而滥用。
03 · 事实核查,才是办公AI的分水岭
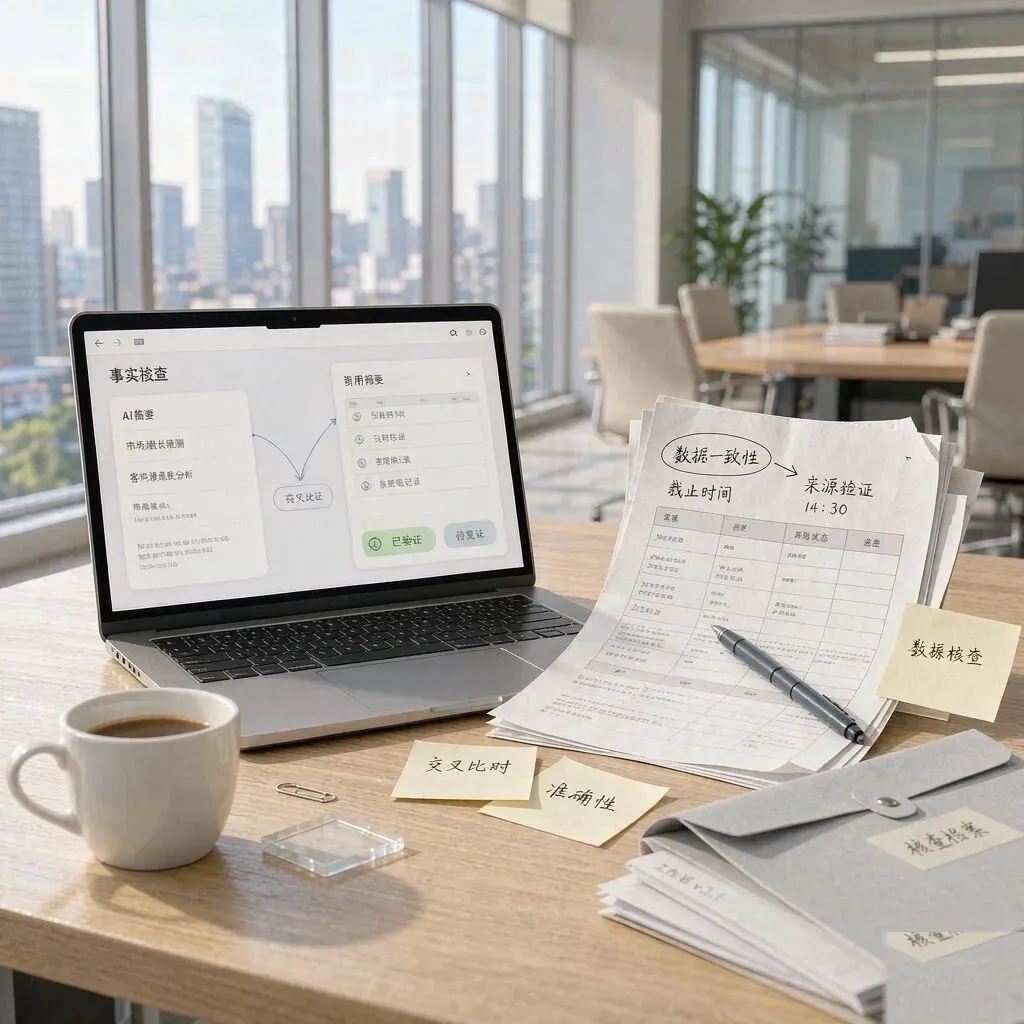
为什么factcheck这么关键?因为职场里的错,往往不是语法错,是事实错:张冠李戴的引用、对不上的数字、想当然的结论。
行业里也有参照。杰富瑞对8款主流AI Agent的实测里,阿里千问办公综合得分95排第一,Claude Cowork 94、OpenAI Codex 92紧随,拼的不只是速度,更是交付的可靠度。
我帮团队筛过这类工具,结论是:能自查、能引用的,才敢交出去;只会滔滔不绝的,留着当草稿机就好。靠不靠谱,比快不快值钱。
但也别神话factcheck。它是按已知事实去核对,遇到空白或争议领域,它同样可能漏。所以我的底线是,AI给的引用和结论,关键处仍要人核一遍。工具负责第一遍把关,人负责最后一道防线,两者缺一不可,可靠的产出是协作出来的,不是某一方单独保证的。
04 · 普通人怎么用才不踩坑
机制再好,也得会用。我的建议就三条:第一,把任务说清楚背景和约束,别只丢一句帮我写;第二,让它给出处,凡是没来源的论断都先打个问号。
第三,重要的事让它辩论一轮再定稿。你可以主动要求它先列反对意见,再给结论,把团队作战的好处真用起来。
我试了把每周例会用AI先生成纪要、再让它自查冲突项,遗漏确实少了。工具不会自动变可靠,是你用它的方式,决定了它靠不靠谱。
说到底,多智能体改变的不是AI的能力上限,而是它交付的可靠度。对职场人来说,这才是真红利:你不必再当AI的专职校对员,可以把它当成带质检的协作者。会用的人,省下的是反复改稿、替AI擦屁股的时间和信誉成本。
工具迭代很快,今天的多智能体明天可能又换形态。但有一条不变:越重要的产出,越要保留人的终审权。把AI当队友而不是拐杖,它才真的帮你把活干完,而不是帮你把坑挖大。这比追任何一个新功能都更值得花心思。
互动时间
你最希望AI帮你挑哪种错?①数据口径对不上 ②引用张冠李戴 ③结论想当然
觉得这篇把AI办公的新变化讲明白了,点个收藏,下次选工具先看它会不会自查。
往期推荐
#AI效率 #职场干货