ARTICLE · 1132705
AI 等不起 DRAM 建厂:大摩说这轮存储短缺,靠三招绕开
(本文约 2400 字,读完约 6 分钟)
唐哥的投研笔记 · 存储链系列
先说一个反常识的判断:存储缺货缺到什么程度?缺到 AI 开始"自我降配"了。
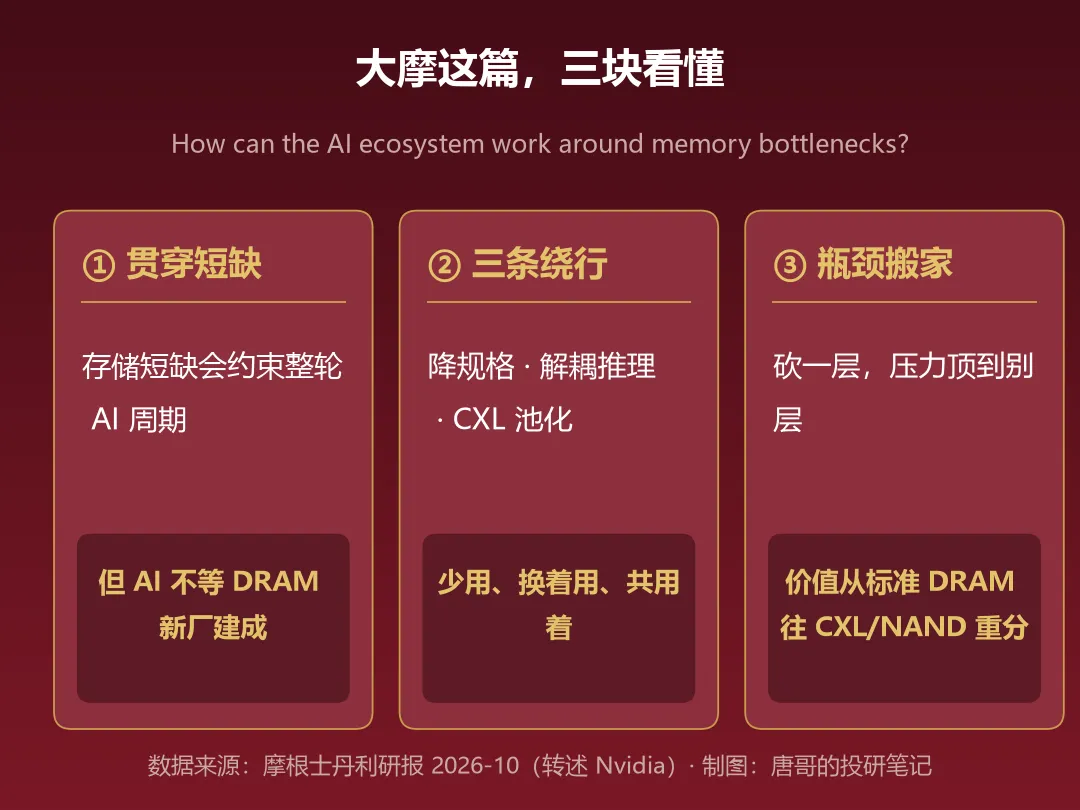
摩根士丹利这份半导体报告的核心观点很直接–存储短缺会是整轮 AI 周期的约束,但 AI 不会等 DRAM 新厂建起来。 于是整个生态开始想办法"绕开"内存墙。这篇我拿大摩的框架,用三块讲清楚:① 为什么这轮内存这么紧–模型每 6 个月翻一倍;② AI 绕开存储的三条路–降规格、解耦、CXL 池化;③ 为什么说降规格反而不是存储的坏消息。
一、内存为什么这么紧:三条需求线一起往上顶
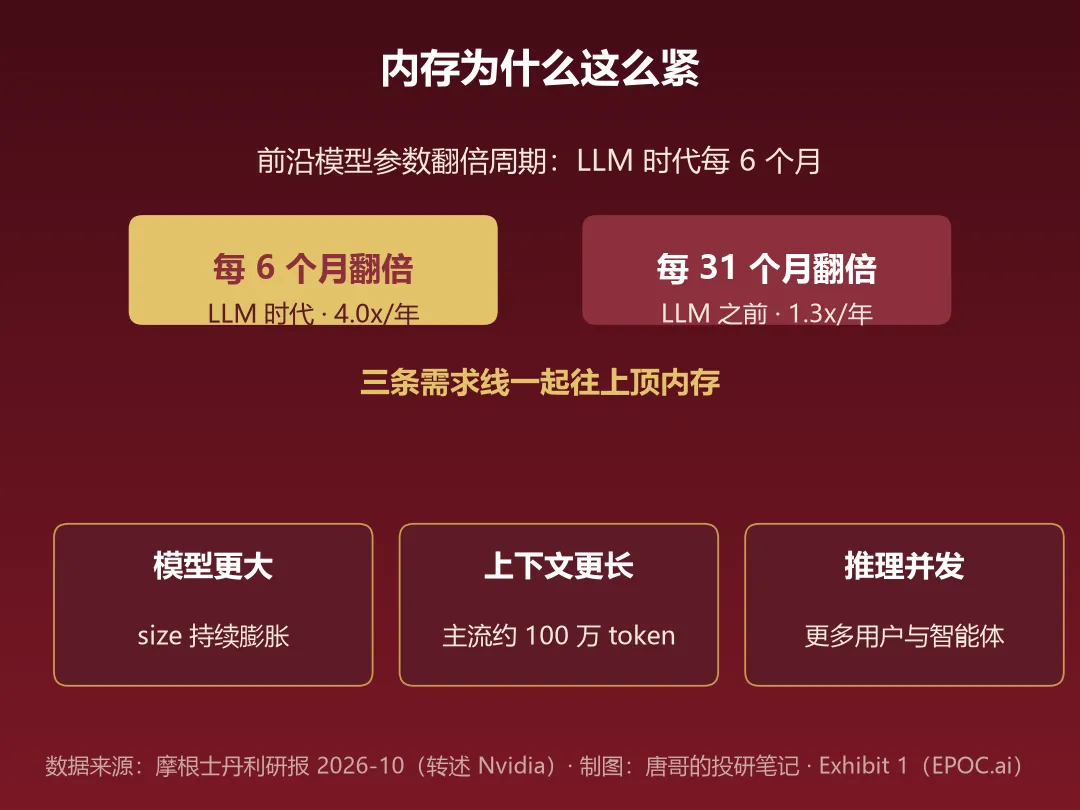
大摩开篇甩了一张图–前沿 AI 模型的参数量,在 LLM 时代每 6 个月就翻一倍;而 LLM 之前那几十年,是每 31 个月才翻一倍。增速差了一大截。
但这只是第一条线。大摩说,往后 LLM 会在三个方向同时吃内存:模型更大(size)、上下文更长(context length)、服务的用户和智能体更多(推理并发)。 现在主流模型的上下文窗口大约 100 万 token,而 AI 的重心正转向长链路的 agentic 任务–上下文窗口本身,就成了内存瓶颈。
三条线一起往上顶,DRAM 的产能却跟不上。这就是我前面几篇–存储超级周期、美光资本开支、AI 缺货地图–那条线的延续:缺货是真、是结构性的。但大摩这篇补了一个新角度–需求方不会干等。你 DRAM 交不出货,我就想办法少用、换着用。
(这条从"缺货"到"绕行"的主线要是你一直在跟,收藏一下–下面三条路,才是这篇的干货。)
二、绕开内存墙的三条路
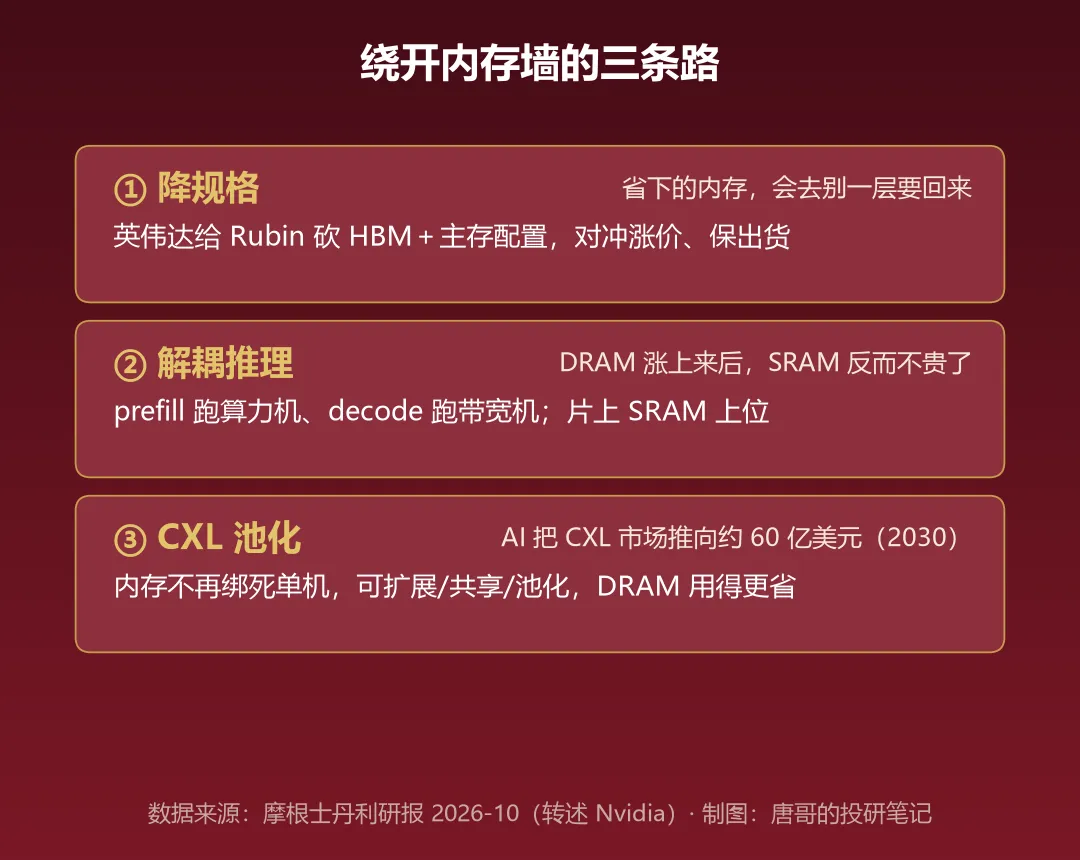
第一条,最直接的–降规格(大摩叫"暴力削减内存配置")。
英伟达在给下一代 Rubin 提供更低内存配置的版本,HBM 和主存都砍,目的是对冲内存涨价、保住出货量。但大摩提醒了一句关键的:到目前为止,每一次降规格,都会让内存瓶颈在算力的别处冒出来。 你在这一层省下的,会跑到那一层去要。
第二条,解耦推理(disaggregation)。
推理其实分两段:prefill(并行处理输入提示,偏算力密集)和 decode(一个 token 一个 token 生成,反复读权重和 KV 缓存,偏内存带宽和容量)。以前一块加速卡两段都得扛,资源错配。解耦就是把两段拆开、各用更合适的硬件–算力机器跑 prefill,带宽机器跑 decode。 这样两种资源能各自扩容、利用率更高,而不是每一段都配同一副"算力+高带宽内存"的组合。
这里冒出一个"省钱奇招":片上 SRAM。Groq、Cerebras 这类用大量片上 SRAM 的架构,历史上 SRAM 比 DRAM 贵得多–可现在 DRAM 涨上去了,SRAM 反而不贵了。于是 Cerebras 的晶圆级引擎、英伟达收进来的 Groq,都成了"绕开 DRAM"的一条路。
第三条,CXL 内存池化。
CXL 是一种高速互连,让内存不再死死绑在某一颗 CPU 或某一台服务器上–可以扩展、共享、池化,多台处理器共用一片 DRAM,把已部署的内存用得更省。大摩说,CXL 以前主要按"CPU 内存扩展"来算市场(控制器约 40 亿美元),现在 AI 把这块机会往大约 60 亿美元(2030 年)推。
三、降规格,反而不是存储的坏消息
读到这你可能会问:满世界都在降内存、换 SRAM、上 CXL,那对做 DRAM 的,岂不是利空?
大摩的回答很有意思:短期看,是有一点。但如果 AI 因为 DRAM 太紧而干脆停下来不建了,那才是更糟的。所以"绕开"这件事,对存储行业不是需求消失,而是瓶颈在层级之间搬家。
它的逻辑是这样:你在 HBM 这一层砍了容量,数据不会凭空消失–它得往别处放,于是给 CXL 网络内存、给 NAND/闪存这些"别的层级"创造了需求。砍一层,压力就顶到剩下几层。
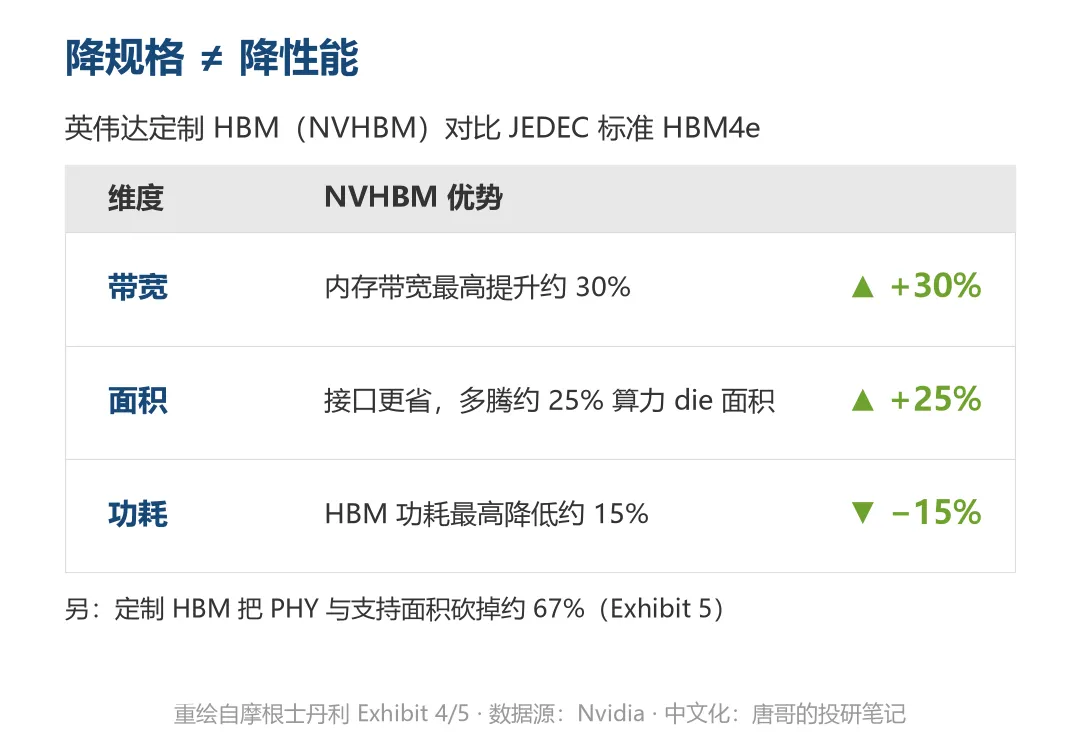
而且降规格不等于降性能。大摩引英伟达的数据:它的定制 HBM(NVHBM)相比 JEDEC 标准 HBM4e,带宽反而高约 30%、能给算力 die 多腾约 25% 的面积、功耗还低约 15%–因为把内存接口做窄了,PHY 和支持面积砍掉了约 67%。换句话说,省下来的地方,拿去塞更多算力。
至于谁受益,大摩点了几类:解耦推理里的 Cerebras(晶圆级 SRAM)、英伟达(通过 Groq 的 LPU);CXL 里的 Astera Labs(Leo 内存控制器,预计 2027 年在两家美国超大规模客户放量、含定制 KV 缓存卸载)和 Marvell(Structera X)。注意,这只是研报点名的潜在受益方向,不是买入建议。 我把它们摆出来,是想让你看清这条"绕行链"上,价值正在从标准 DRAM 往定制 HBM、CXL、NAND 这些环节重新分配。
结语:把大摩这篇读透,其实是一句话–这轮存储短缺的解法,不是等产能,是重新分配。 AI 用降规格、解耦、CXL 三招,把内存从"最贵的那一层"往"更划算的层级"搬。对做存储的人,别只盯着"DRAM 会不会被少用",要盯"瓶颈搬到了哪一层"–因为搬去哪儿,哪儿就缺货、哪儿就有价。
(数据归源:摩根士丹利 Joseph Moore 团队半导体研报,2026-10;英伟达定制 HBM 数据引自该报告转述 Nvidia。本文为第三方研报观点转述与解读,非个股推荐。)