ARTICLE · 1132711
AI 说话越发看不明白?ASD-STE100 规范实测
Kapathy 最近一条动态很多媒体报道(原文翻译后截图):
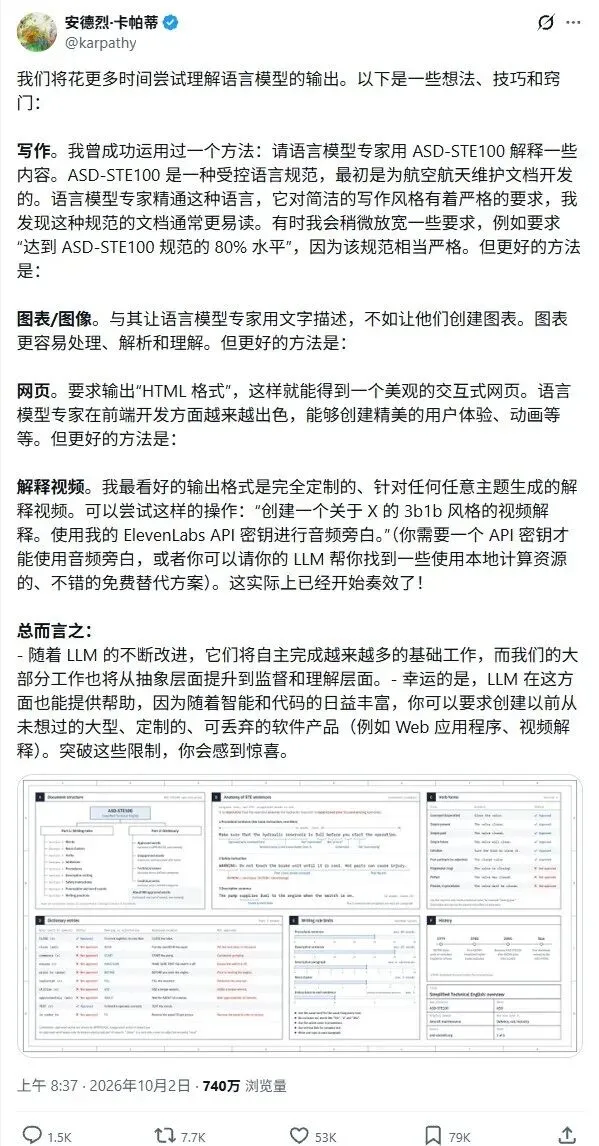
https://x.com/karpathy/status/2105819303471976479
能让 AI 写的文档更易读,我觉得都很了不起了。
现在,AI(GPT) 写的内容,可以说越来越冗长,还爱把一个东西用不同的词、甚至随意夹杂英语单词来表达。若不干预,它还绝逼会把一个关键文档,比如项目 README,哔哩吧啦,维护得,字数多到令人发指。
虽然,遗漏的代价可能更大,但面对一堆内容,你说直接清理吧,怕真漏了什么,一条条检查吧,那文风,读起来可真叫人一个头两个大。
我确实有为此而专门应对(仅供参考):
1.先定义术语,对话时候,让 AI 务必使用术语表中的词汇
2.尽量用代码自身的逻辑来防范未然,而不是随意追加说明
3.限定某个文档,不许超过多少行
4.说话具体:
……存在对应代码、目录、产物或已定义术语时必须明确引用,不得用未定义缩写、抽象词或内部黑话替代具体对象……
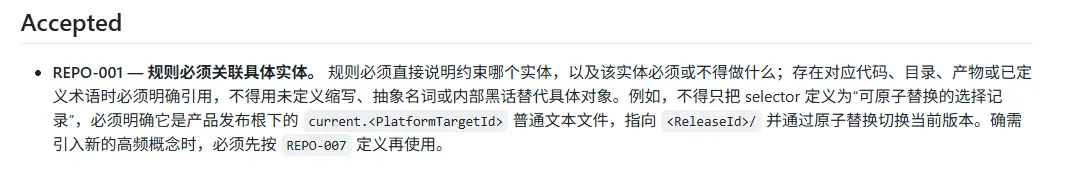
我项目的一个 AGENTS.md 原文:
https://github.com/SwawHQ/swaw-harness/blob/0c833580091337d000af2bc51927d72291ccb0a5/AGENTS.md
二、
前一篇文章,修订过程,我就让 ChatGPT 帮我看,它说:“如果保持你的原意,我会收成下面这样...”
我:“对于你刚刚的这一版,请使用 ASD-STE100 风格重写”
然后我得到了两个版本,紫色是ChatGPT 原版,蓝色是 ASD-STE100 风格的重写版,我贴出来,作为一个样例,供大家感受(我觉得效果很明显):
相比 AI 现在究竟有多强,我觉得更令人不安的,是它进步的速度,以及每次变化的幅度。
相比 AI 当前的能力,我更担心它变化的速度。
我也担心每次变化的幅度。
一个越来越奇怪的感觉是:我越认真学习“怎样更好地使用这一代 AI”,下一代 AI 就越可能直接把我刚刚学会的东西变成默认能力。
现在,我遇到一个问题。
我花时间学习怎样更好地使用当前的 AI。但是,下一代 AI 可能会直接提供这些能力。
也许真正迅速贬值的,不只是某一种编程技能,而是“驾驭 AI 的技能”本身。
因此,一些“使用 AI 的技能”也可能很快失去价值。
于是一个很奇怪的问题出现了:
我们为了适应 AI 而获得的经验,它的半衰期是不是也正在越来越短?
因此,我有一个问题:
我们为了适应 AI 而获得的经验,它的有效期是不是正在变短?
最近几个例子让我这种感觉尤其强烈。一个以前没有破过密码的人,可以借助 frontier model 去解一个两百多年没人完整破解的历史密文。AI 系统开始在 Navier–Stokes 这样的数学问题上产生严肃成果,Claude 也在黎曼猜想相关问题上推进了几十年来停滞的界。
最近的一些案例加强了我的这种感觉。
Carter Church 说,他以前没有破解密码的经验。但是,他使用一个 frontier model 破解了一份两百多年前的历史密文。
AI 系统也开始在 Navier–Stokes 等数学问题上产生重要结果。
Claude 也推进了一个与黎曼猜想有关的长期数学结果。
这些事情并不意味着专业知识突然没有价值。
但它们似乎在改变“专业能力是怎样获得的”。
这些案例不表示专业知识已经没有价值。
但是,它们可能正在改变专业能力的形成方式。
过去,某种罕见能力通常意味着一个人投入了很多年训练。决心、自律、长期积累,最终形成了一种稀缺性。
过去,一个人通常需要多年训练,才能获得一种稀缺能力。
训练需要时间。
训练也需要决心、自律和长期积累。
这些投入通常可以产生一种相对稳定的优势。
AI 却可以把其中一部分能力直接交给一个没有经历过这些训练过程的人。
AI 改变了这个关系。
AI 可以把某些能力提供给没有接受长期专业训练的人。
https://github.com/orgs/SwawHQ/repositories
我是做运维出身,回顾我做的这些项目,一个特点:添加功能时,会更慎重考虑后面可能的维护负担,并追求绝对易用。
目前这些,都还没达到要求。最近在密集开发的是 GIDD 这个 Skill。
读到这里的朋友,可以看看,其中有没有你也感兴趣的…欢迎留言区评论、交流🌹