ARTICLE · 1139724
AI时代,软件开发还有护城河吗?
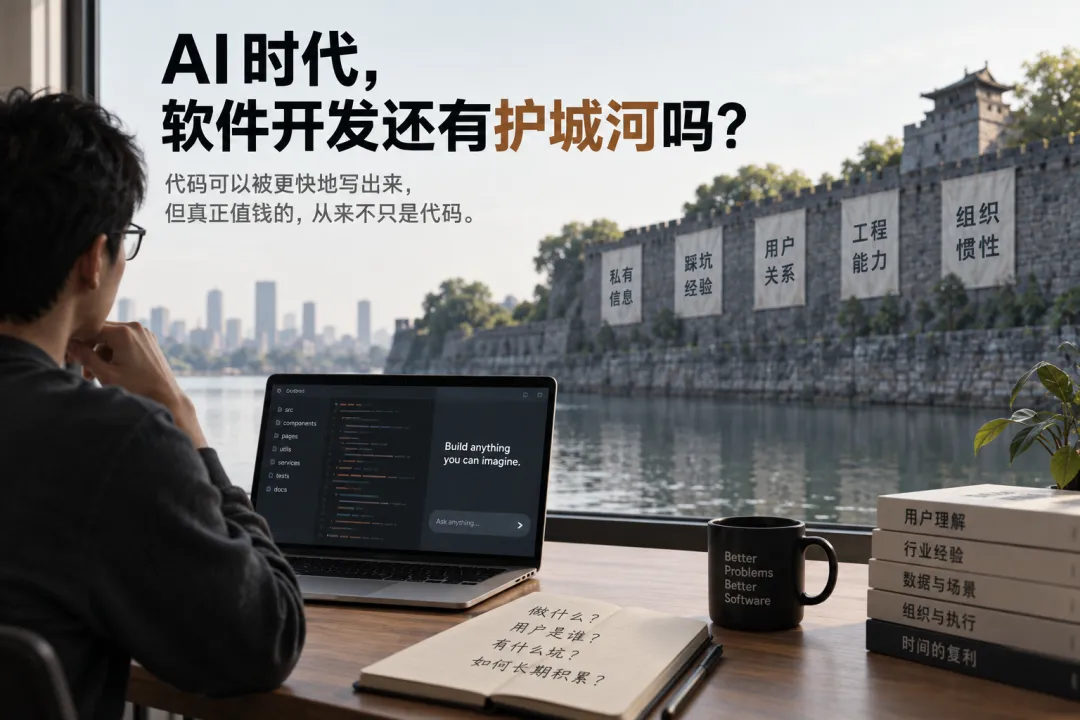
最近和几个做软件的朋友聊天,话题绕来绕去都落在同一个问题上:AI 把写代码变得这么便宜,软件还有护城河吗?
有人说,他用 AI 花几个小时就重写了一个成熟的可视化库;逆向一个商业软件,也不过几天的事。
因此,我做一个滑坡推论,如果代码已经不值钱,开源还是闭源都无所谓了。是的,编码这份劳动确实不值钱了,但我觉得值钱的本来就不是它。
软件的护城河是难以复制的判断,以及这些判断留下的沉淀:私有信息、踩坑经验、用户关系。编码劳动从来只是它的成本,AI 降的是这份成本。
编码劳动从来不是护城河
写代码这件事,从来只是成本。一个功能该不该做、做成什么样、哪些场景要兼顾、哪些可以放弃,这些想清楚之后,剩下的才是敲键盘。
过去,想清楚的人把编码工作分发给程序员;现在,分发给 AI。执行者换了,上游的判断、设计和取舍没有换。
所以“AI 让代码护城河消失”这个说法,只说对了一半:消失的是执行门槛。一家软件公司值钱的地方,从来不是那几百万行代码本身,而是这些代码为什么长成这样。同一个需求,十个团队会做出十种系统,差别不在打字速度。
AI 只是让这一点暴露得更彻底。从前要抄一个产品,得先凑一支团队;这道执行门槛过去确实挡住过不少人,算半条护城河。现在一个人加一个模型就能开工,这半条没了,大家才看清,真正拉开差距的东西一直在别处。
有意思的是,认为代码已经不值钱的人,谈到大公司为什么不用 AI 重构自己的系统时,给出的理由是成本、部门划分、内部竞争和背锅风险,“你自己的东西你都动不了”。这里面没有一条是代码问题。连主张代码没有护城河的人也承认,真正难的部分在代码之外。
代码不值钱了,大厂为什么还闭源
如果代码真的无所谓,最理性的做法是全部开源,换一个好名声。现实却是大厂的核心产品依旧闭源,而且捂得很紧。
闭源当然有安全、合规、商业谈判这些常规理由。但我认为还有三个很少被说破的原因,它们恰好指出了护城河真正的位置。
一、藏拙
很多商业代码是在工期、KPI 和历史包袱下将就出来的,质量远不如外界想象。外面的人看一家大公司,默认它的代码配得上它的市值;真打开看,临时方案叠着临时方案的地方并不少。
闭源在这里保护的是体面和信誉,谈不上技术优势。代码写成这样,产品照样卖得好,可见买单的人买的不是代码。
二、藏巧思
一个系统里真正有价值的,往往只是少数几处关键设计:一个架构上的取舍,一个棘手问题的精妙解法。它们在代码量里占比极小,却是团队多年试错的结晶,而且一看就能学走。
这解释了一个常见现象:源码被打包泄露之后,公司的反应常常激烈得不成比例。按理说,几十万行代码,对手未必读得完。让它们紧张的是那几处想法。想法和代码不一样,学走它不需要读懂全部,只需要看到。
三、隔离关键业务
真正核心的业务,跑在内部基础设施和内部模型上,与外部环境隔离。外人能拿到的是客户端、接口、外壳;数据、流程、内部多年积累的工具链,拿不到。有说法称,有的 AI 公司每次内部模型迭代,都优先用来升级自家的基础设施:最好的工具先留给自己。
所以即便 AI 能在几天内逆向出一个商业软件,逆向出来的也只是外壳。壳子后面那套东西怎么搭起来的、为什么这样搭,才是这家公司的智力存量。
三条归到一起:闭源藏的,要么是不想让人看见的将就,要么是不想让人学走的想法,要么是根本没打算让人碰的核心系统。没有一条是在保护代码量。
反过来的例子同样说明问题。Android、Chromium、VS Code 的核心代码都是公开的,谁都能拿去改,Google 和微软在这些产品上的位置并没有因此动摇。代码给出去了,生态、分发和持续做对决定的团队给不出去。
速度、服务、工程、惯性,说的是同一件事
关于新的护城河在哪里,我听到过四种答案。它们彼此争论,在我看来却指向同一个东西。
有人说是速度。 触达用户要快,迭代要快,慢一拍就被淘汰。可大家用的是同样的模型,谁都能一天发三个版本。快已经不稀缺,稀缺的是方向对。往哪里快,是判断。
有人说是服务。 开源一个版本引流,靠定制和服务赚钱,因为用户付费是出于精力有限,并非自己写不出来。这话没错。但服务好不好,取决于你对用户理解多深、能不能替他把决定做对。卖的仍然是判断,只是不再包在代码里卖。
有人说是软件工程。 写脚本容易,做工程难,对 AI 也一样;好的架构、克制的复用、对用户习惯的尊重才是壁垒。我完全同意,这正是我说的判断,换了个名字。人人都能造轮子的时代,一次性代码只会更多,工程判断力只会更贵。
有人说是用户惯性。 迁移成本不接近零,用户就不会离开舒适区;重写一个工具却没人迁过来,只是在服务自己。但惯性从哪里来?来自当初有人把产品做到让用户懒得换。它是过去的判断沉淀下来的资产。后来者再聪明也不能一步跨过去,只能用同样长时间的正确判断去换。
还有几样东西不在这四种答案里:网络效应、独占数据、渠道、资本、牌照。它们不能都算成判断,当然也不能硬算。但它们不是 AI 时代才出现的,也不因为代码变便宜而消失。这篇文章讨论的是代码变便宜之后,软件自身还剩什么。
至于 AI 写的代码到底行不行,争论同样很多。有人说新模型的出错率已经低于人,也有人亲眼见过 AI 重写的应用性能一塌糊涂。两边都是真的,因为变量不在模型,在用模型的人。同一个模型,有人拿它搭出结构清楚的系统,有人拿它堆出一坨没法维护的过程化代码。
两种“屎山”
我以前说过一句玩笑话:软件最大的护城河就是屎山。这和前面说的“闭源是为了藏拙”听起来矛盾:既然是护城河,何必藏?
其实是两种东西共用了一个名字。
第一种是将就出来的烂代码。赶工期留下的,没人敢动的,这是要藏的拙。它不构成任何壁垒,只构成负担。
第二种看上去同样难看,却是被真实场景一条一条磨出来的:某个客户的奇怪环境,某次事故后加的兜底,某个老版本的兼容分支。每一行丑陋的 if 后面,都有一个真实踩过的坑。
AI 可以几小时重写出主干功能,却写不出这些它根本不知道存在的坑。重写出来的东西演示时一切正常,上了生产才发现缺的是那十年。
开头那个几小时重写可视化库的例子,要放在这里看。成熟的开源库,坑都写在代码、测试和 issue 里,AI 是照着答案抄的。商业软件的坑没有公开,这个例子推广不过去。
兼容性是这类积累里最大的一种。一位做单一硬件产品的朋友说,市面上的基础设施为兼容妥协了太多,他只取自己用得到的部分,一个需求固化一个版本。对他来说这完全合理。但面向所有人的平台砍不掉兼容性:Windows 常被人说快不行了,可它几十年攒下的硬件兼容性,至今没人能复制。代码可以重写,适配过的那些设备和场景重写不出来。
第二种才是护城河。值钱的不是这些代码写起来多费劲,是它们记录的那些决定:用时间和事故换来的、沉淀在代码里的经验。所以准确的说法是:编码劳动不值钱,代码里沉淀的决策一直值钱。
AI 越来越聪明,这条护城河会被填平吗
这是最有力的反驳:如果护城河是人的判断,而 AI 的判断力正在快速追上来,这条河迟早会干。
我的回答分三层。
第一,判断需要原料,而原料大多是私有的。 AI 在“怎么做”上进步飞快。但“做什么”依赖对具体用户、具体行业、具体时机的理解,这些信息大多不在任何公开语料里,在某些人的脑子里,在某些公司的内网里。严格说,这一层是信息壁垒,不是智力壁垒:模型再聪明,没见过的东西也推不出来。这也是前面说的第三条:关键的东西本来就被隔离着。
第二,在看得见的几年里,AI 是放大器,放大的是使用者原有的判断力。 会提问题、会做取舍、会验收结果的人,产出被放大十倍;不会的人,得到的是十倍的一次性代码。所以 AI 越强,人和人、组织和组织之间的差距越大。这一条是有时限的判断。已经有人主张需求也可以交给 AI:把零散的想法碎碎念给它,让它整理成需求,人只做少量指导。哪天 AI 连这点指导也不需要,能自己提出问题、自己验收,放大器的说法就不成立了。不过眼下,那些碎碎念仍然是人手里的原料,这又回到了第一层。
第三,就算那一天到来,有些东西也不随智力转移。 用户信任的是谁,出了事谁负责,十年事故换来的经验记在谁的系统里,这些不会因为模型变聪明就换了主人。
这条河短期内不会干,只会改道:从“谁能写出来”流向“谁知道该写什么”,再流向谁手里握着别人拿不到的信息和信任。
写在最后
编码劳动的门槛消失了,但它从来只是成本。闭源依然普遍,藏的是拙,是巧思,是隔离起来的核心系统。速度、服务、工程、惯性,都是判断落在不同位置的投影,或是它留下的沉淀。
过去我们把想法分发给程序员,现在分发给 AI。分发的对象变了,值钱的始终是那个想法,以及能判断它好坏的人。
对做软件的人来说,这算是好消息:打字的活可以交出去了,时间该花在把问题想清楚上。
文:fable整理
图:gpt-image-2.5