ARTICLE · 1139958
让 AI 亲手拆解你不会的 App
它把 Hopper、Ghidra、JADX 这些逆向工程引擎接到你的 AI 编程助手上。你说"帮我看看这个软件是怎么做到的",它自己去拆。
先说结论
逆向工程这件事,过去必须由会用 Hopper、会看汇编的人来做。现在有一个叫 REA 的开源项目把这些工具包成了 MCP(模型上下文协议)服务,你的 Claude Code、Codex、Cursor 就能直接调用它们。
它值得关注的理由有三个:分析全在本地跑,目标程序不会上传到任何服务器;每个结论都带证据和局限性说明,不会给你一个"看起来对"的瞎猜;覆盖面很广,从原生二进制、Electron 应用到 APK、固件、.NET 程序都能拆。
但也要说清楚:它不恢复原始源码,也不是"一键克隆"的工具。它的价值是把你从"完全看不懂"带到"我知道它大概怎么做的,并且知道该去验证哪一行"。
它到底是什么
REA 全称 Reverse Engineer Anything,在 npm 上的包名是 rea-agents,用 TypeScript 写,MIT 协议。
定位上它有两个入口:MCP 服务端(让你的编码助手调用)和命令行工具(rea,你在终端里直接用)。两者共用同一套工作流和同一套"证据记录"格式。
整个项目的核心是一个三段式循环,作者自己也是这么描述的:
• Decompile(反编译):打开目标,捞出可读代码、字符串、符号名这些线索。 • Understand(理解):沿着控制流和数据流在应用里追踪,直到能解释某个具体功能。 • Recreate(复现):把理解到的东西写成你自己技术栈里的代码。
这里有个容易被忽略的架构设计:三个阶段各自产出结构化的中间结果,包括可复现的 Evidence 记录。这意味着你这次逆向出来的结论,可以导出、导入、和另一次的分析做diff。也就是说,一次性的逆向session变成了可审计、可复查的团队资产。团队里做互操作研究或者安全审计的人,这一点比"能反编译"本身更有价值。
它到底能拆哪些东西,看这张图就明白了:
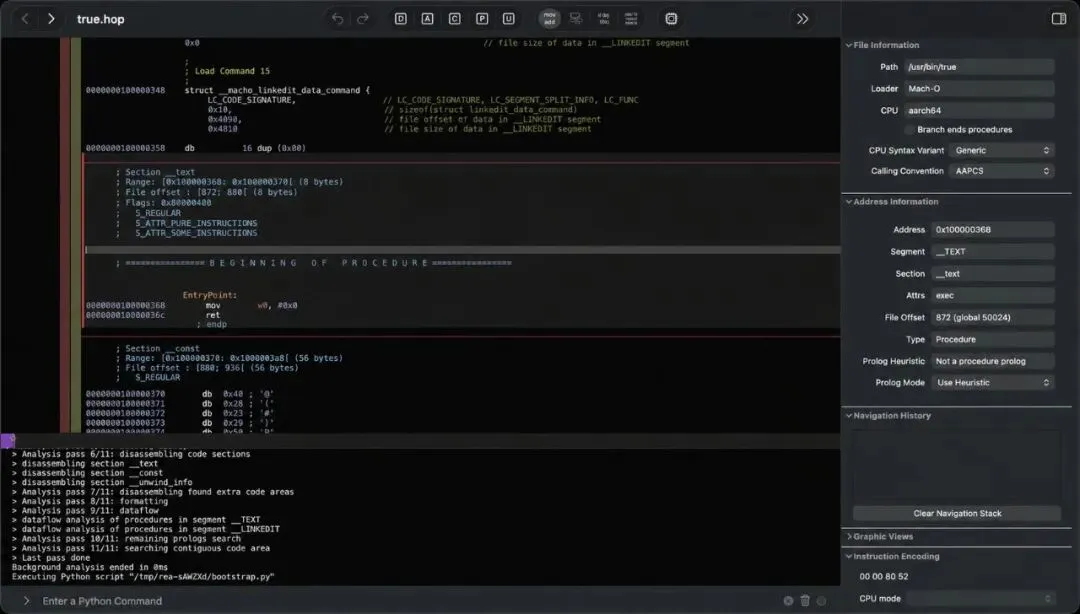
上面这张是 REA 启动它的分析桥、同时在 Hopper 里检查一个原生二进制的实拍。工具目录本身也是它和"套壳 wrapper"的分界线:
所谓工具目录,具体展开是 11 个工具族、120 多个工具:原生检视占 41 个,证据与工作区追踪占 21 个,其余分布在 JavaScript/Electron 应用、Android APK、.NET 程序集、网站、固件、进程行为捕获等方向。
核心机制:为什么它敢把"不确定性"直接写进结果
逆向工程最容易翻车的地方不是工具不够强,而是工具给了个答案,你信了。反编译出来的伪代码经常是残缺的,符号可能丢失,控制流可能猜错。
REA 的做法是把这些不确定性变成结构化数据,而不是藏起来。每个结论后面跟着它的证据、它的限制条件,还有它明确标出的"未知"部分。多个外部评测都注意到这一点,并且把它列为这个类别里少见的诚实度。
第二个机制是引擎选择拒绝猜。如果你装了多个逆向引擎(Hopper + Ghidra + IDA),目标又刚好是这些引擎都能处理的格式,REA 不会自己挑一个——它返回 capability_unavailable,标记 selection_reason: "ambiguous",把候选的引擎 ID 列给你,让你自己选一次。这个选择会被记住,后续整个会话都用它。
这种"拒绝猜"的策略看起来保守,但它解决的是逆向工程里一个真实的坑:不同引擎的反编译质量差异很大,选错引擎你可能得到一份看起来完整、实际错误的伪代码。
第三个机制是只读与临时副本。Ghidra 适配器分析的是目标的临时副本,会话关闭时删掉临时工程,不碰你的原始文件。4.1.0 版本加的 Windows Ghidra 支持也是明确标注为实验性的,配了 Job Object 隔离和私有 DACL——团队在文档里直说加固还没做完。
真实场景怎么用
装法就一条命令,需要 Node.js 22.19+:
npx rea-agents setup这个 setup 过程有几个细节值得注意:它会检测你装了哪些编码助手(Claude Code、Codex、Cursor、Gemini CLI、Windsurf、Devin、OpenCode、VS Code 等),但检测不等于选中——没有任何东西是预勾选的,每项能力都有独立的确认清单。写入配置前会备份,写完还会回读校验。有个例外很有意思:Devin 被检测到但故意不配置,因为它没有公开的本地 MCP 配置边界,作者认为这在安全上不妥当。
装好之后重启助手,用大白话问就行:
Understand how search works in the Notes app, show me the evidence, and build a similar feature for my project.命令行党也有对应的:
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json装成全局命令之后用起来更顺手:
npm install --global rea-agentsrea --helprea update它最实际的一个用途
项目自己给了三个完整案例,其中 Notion 那个对前端开发者最有参考价值:找到渲染进程里的剪贴板 API,跟着它穿过 preload 和 IPC 进到主进程,再去看富文本剪贴板格式。这条路径——从渲染层一路追到主进程——正是很多团队自己梳理 Electron 应用时最花时间的部分。
另外两个案例(DX-Ball 的声像定位算法重写、TH04 的 DOS 子弹环角度计算)更硬核:DX-Ball 那个重写版本通过了 3205 个原始 x86 测试用例,并且复现了全部 63 个编译后的函数字节。这种"能被验证的复现"是逆向工程里最难的部分,README 里给出的这个数字比任何"支持 XX 格式"的列表都有说服力。
需要注意的边界
• 原生分析必须自备引擎。Hopper 是商业软件(有 demo 模式,限制由厂商定义),Ghidra 和 IDA 要用你自己装的。这是刻意设计——为了保持 MIT 协议干净、也为了不捆绑商业授权。 • 运行环境有要求:macOS 12+,或 Ubuntu 24.04+ / Fedora 41+ / 64位 Arch。Windows 的 Ghidra 支持还标着实验性。 • 合规责任在你。项目自己声明只用于合法逆向研究、分析和重建,授权和合规由使用者负责。翻商业 App 的闭源实现来重建功能,法律边界你自己清楚。
和同类方案比有什么不同
同类项目里最常被拿来比的是 Ghidra 自己的 MCP server 和各种"让 AI 读代码"的项目(比如把代码库变成知识图谱的工具)。
差别在于入口不同。那些项目假设你有源码——Graphify 之类的工具作用于你自己的代码库。REA 作用于你没有源码的软件:一台没装的 macOS 应用、一个从应用商店下的客户端、一个你收到但不知道逻辑的固件镜像。这两个问题的工具链几乎不重叠。
另一个差别在输出契约。逆向工具的输出天然是"不可信的猜测",而 LLM 的默认行为是"自信地补全"。REA 用 Evidence 记录这个结构把两者缝在一起,等于给 LLM 的猜测加了一层显式的不确定性标注。评测者认为"这种认知上的诚实在这一类项目里很罕见,也立刻表明这个项目是面向严肃的、被授权的工作,而不是想走捷径的人"。
还有一个生态位的差别:这次4.1.0 加了无头 JADX 的静态 APK 分析、Binwalk/Unblob 的固件解包、.NET 程序集元数据和 CIL 指令检视、以及网站在你自己 Chrome 里的被动观测。它的目标是"一个 MCP 覆盖所有逆向场景",而不是在某个单一格式上做到最深。
代价也很清楚:它是个调度层,不是引擎。真正的分析质量取决于你装的那个引擎。MCP 接线、流程编排、证据管理是它的价值,反编译本身的精度不是。
总结
REA 真正改变的不是"能不能反编译",而是让不懂逆向的人第一次能和安全地走完全程。
过去你要么完全放弃,要么请人代做。现在你可以让助手先跑一遍,把伪代码、调用关系、证据都摊在你面前,你只需要在关键处做判断。它的"承认不知道"的设计,比它能反编译多少格式更值得学。
如果你手上有想弄明白但没有源码的软件,这可能是目前最值得试的一条路。