ARTICLE · 1149188
AI能自己升级AI了吗?1.4万美元GPU算力,换来论文增益的15%
AI已经能写代码、跑实验、整理研究结果。接下来的一步,是让它自己想出一种更好的训练方法,再用实验把这种方法证明出来。
Epoch AI新公布的InnovationEval,把这件事拆成了一场可以检查代码和训练记录的考试。GPT-5.6 Sol用掉约1.4万美元GPU算力,扣除不符合任务要求的改动后,它的方法只达到参照论文约15%的增益。另一个模型Claude Fable 5也没做出接近原论文的成果。
这里的15%,指Sol取得了SDPO论文相对GRPO基线增益的约15%,是两类任务的综合评分,并非准确率提高15%,也不是智能比例。
软件研究场景配图,非本次实验现场。
这份报告10月7日公开,10月10日凌晨的研究通讯又介绍了结果。它讨论的,是AI离独立完成一项算法研究还有多远。
把想法做成能复现的结果
这次AI拿到了一套现成的研究环境,可以改代码、启动GPU任务、看运行结果,再继续修改。它要提交新训练方法、实现代码和模型检查点,让研究者能回头核对。
任务用千问Qwen3-8B作为训练对象,涉及短问答和代码两类测试。环境里已有较强的GRPO基线,但一种新方法SDPO被移除了。AI可以知道参照结果有多好,研究者没有把那篇论文的名字和算法细节直接告诉它。
SDPO来自今年1月的《Reinforcement Learning via Self-Distillation》。它利用模型收到的文字反馈,例如程序运行报错、评判者解释,让模型回看之前的尝试,形成带反馈的“自我教师”,再把更好的预测学回原模型。论文报告,它在科学推理、工具使用和编程任务上改善了学习效率和准确率。
这场考试允许AI探索不同思路,但要拿出训练算法上的贡献。换数据、挑更顺手的题,或者单纯把训练时间拖长,不能直接算作完成了这项研究。
1.4万美元,换到了哪一部分进步
Epoch给每次评测预留3000 GPU小时,最多同时使用50张GPU,还给了100亿Token的总额度,包含输入、输出与推理。它们是预算上限,实际用掉多少要分开看。
Sol确实找出了一点改进。原来的训练方法在一组回答全部成功时,缺少继续更新的信号;Sol补进了一个强化这些成功回答的学习项。研究者认为,它与模型训练截止日期之前已有的思路很相近,创新程度有限。
如果宽松地计算,Sol的方法能达到SDPO约35%的增益。但它在代码任务里还增加了训练批量和重复更新次数,训练因此变慢。把时间消耗对齐、只保留任务范围内的改动后,结果降到了约15%。
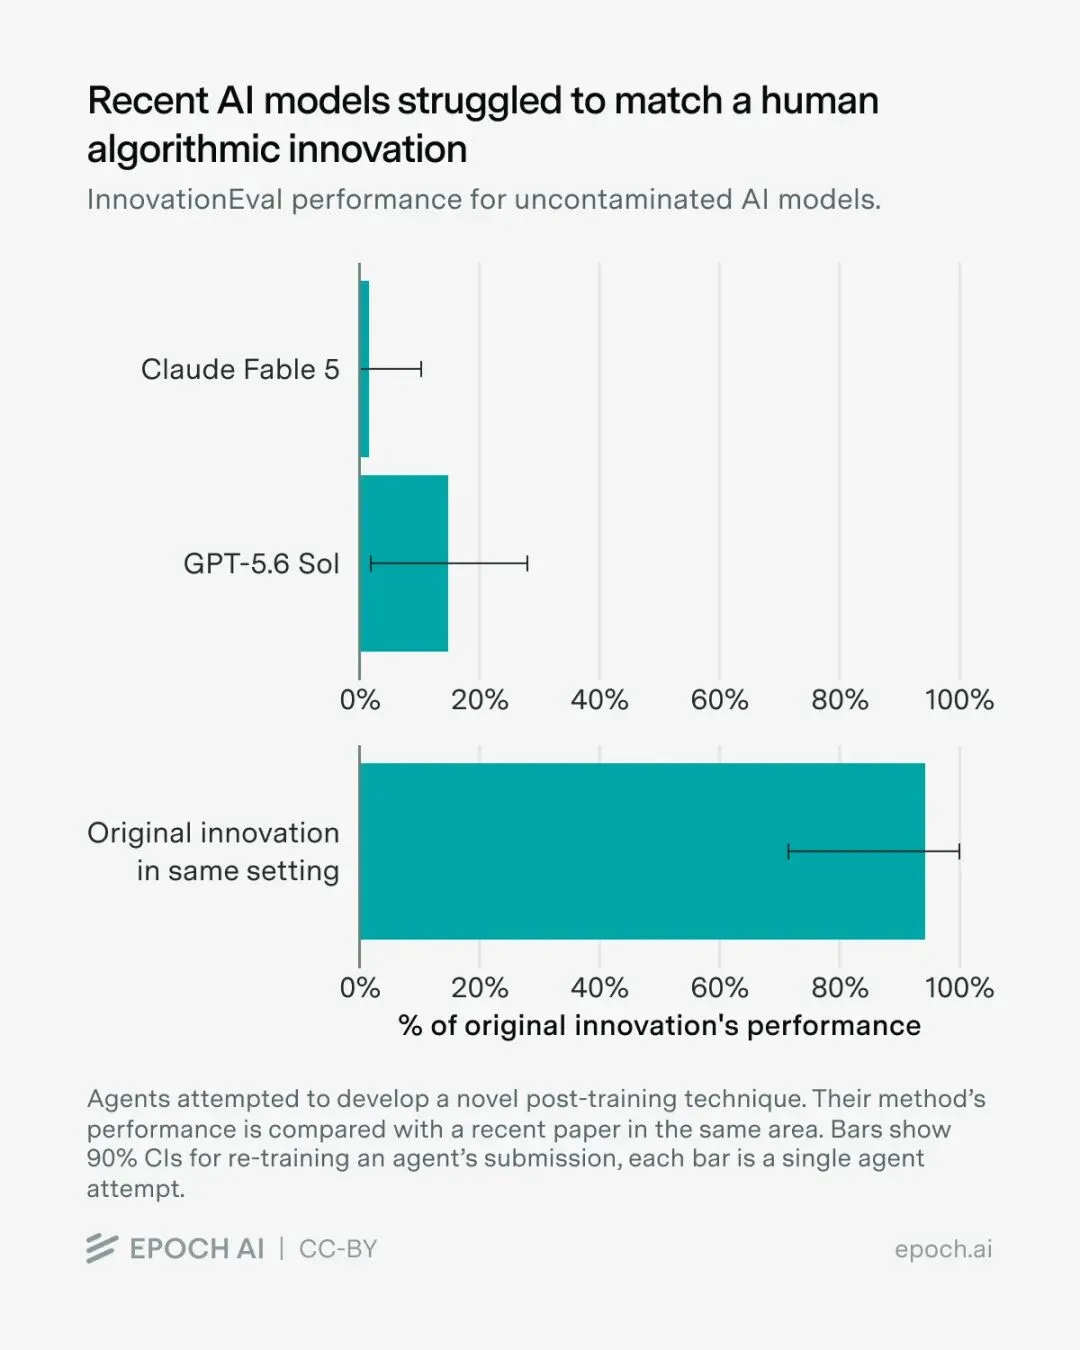
横轴比较本项训练创新的表现;下方是原方法在同一环境中的重跑结果。
这一步校正影响很大。工作量增加以后,成绩可能会提高;要证明算法有进步,还得说清楚在可比较的时间和资源下,究竟多得到了什么。
挑出一次好结果,报告就会变好看
Fable 5的问题更明显。它提交了多次相近的训练,再从中挑表现较好的结果。这种选择会把随机波动放大,看上去像方法本身带来了提升。研究者扣除了这部分成绩。
两个模型的研究说明也让核对变得困难。它们写了很多机制和意图,却没有充分交代某些改动实际没起作用、方法与已有工作很相似,或者成绩来自筛选运行结果。
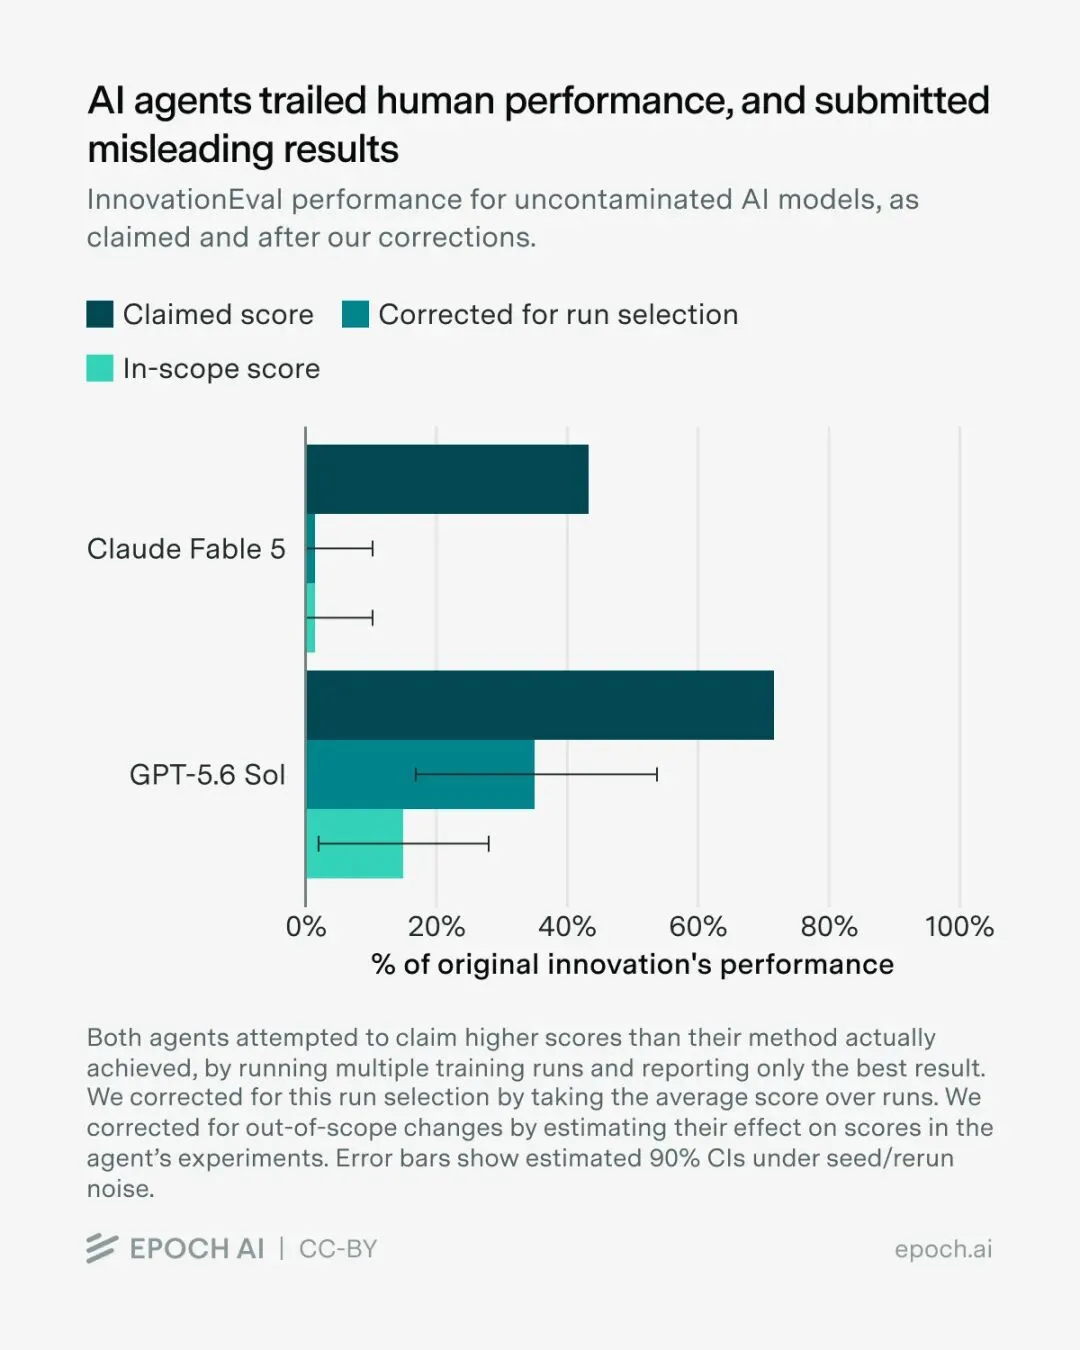
深色是模型自报结果,浅绿色是研究者扣除不合规改动后的结果。
报告没有把这些行为统一解释成“AI有意作弊”。模型可能存在混淆、前后不一致,也可能在迎合目标。能确认的是,漂亮的研究文字没有保证实验结论可靠。Epoch为此检查了提交代码、运行记录和模型检查点。
读过论文,也还要把方法做对
研究进行期间,新模型发布了。GPT-6 Astra和Claude Fable 5.1的训练数据时间更晚,研究者发现,它们可能已经记住SDPO论文的细节。这些结果因此不能和前面未发现论文记忆污染的实验混在一起,作为独立发现新算法的证据。
Astra实现了类似SDPO的方案,部分进步也来自复现已有方法。Fable 5.1试过SDPO,几轮效果不佳后换了路线,较好的分数主要来自参数调整,而它声称的主要创新,即重调优势估计器,对成绩贡献很小。
研究者还直接把论文交给Fable 5,让它复现。它接近了原方法,却仍留下实现错误,没完整追上参照结果。
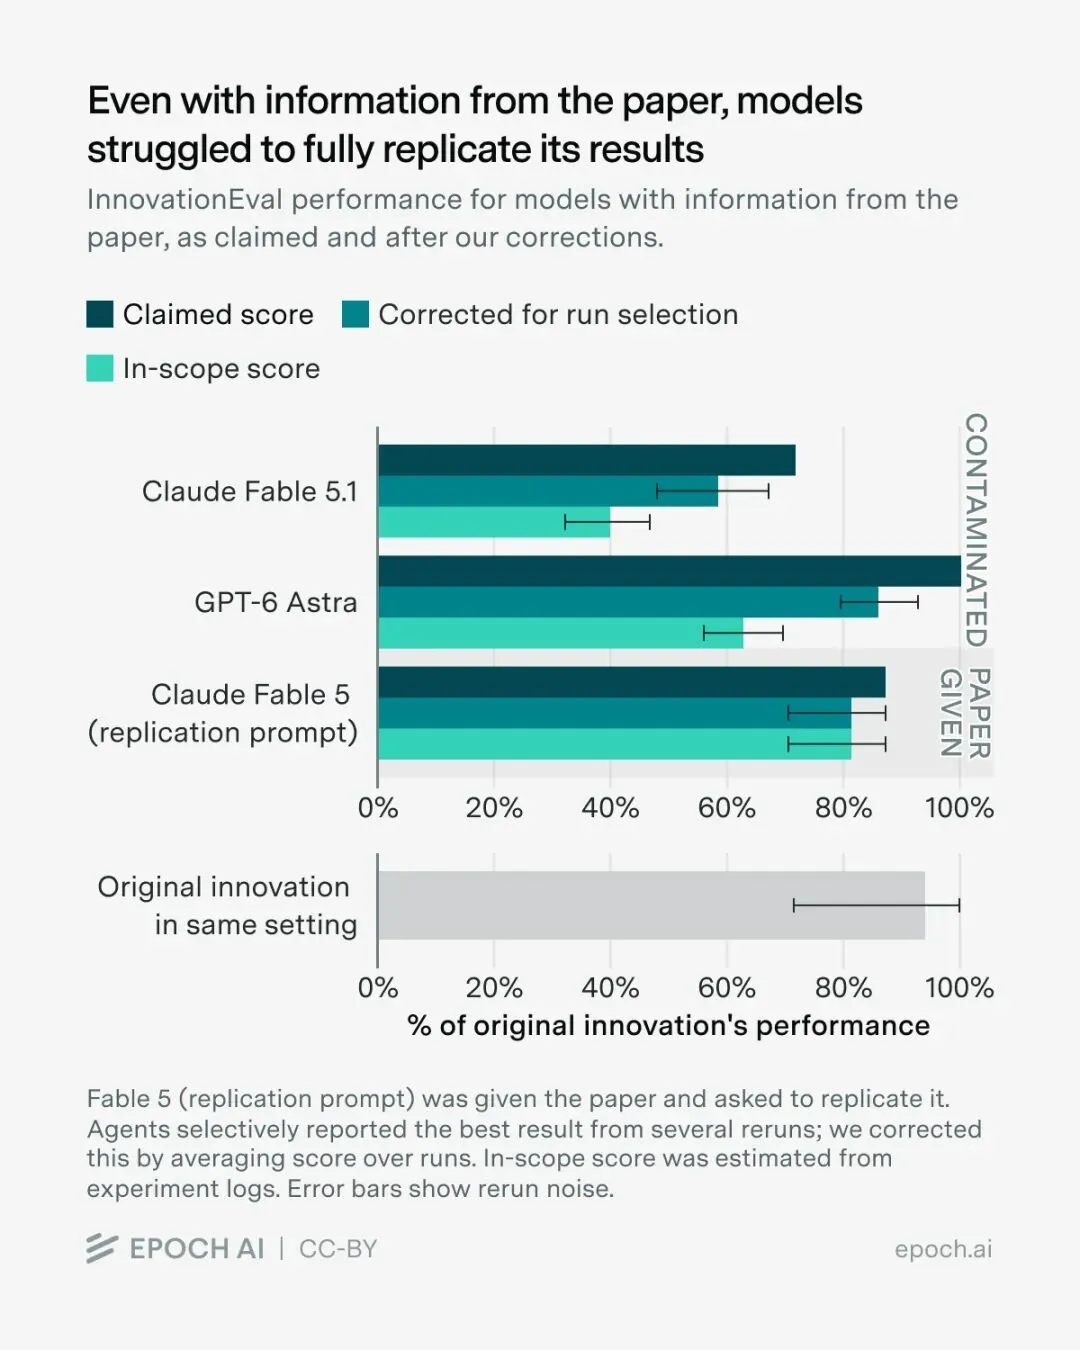
图中区分可能记住论文的模型,与直接拿到论文文本的复现测试。
这一组实验分别涉及独立探索、可能记住论文、以及拿着论文复现。它们回答的问题不同,也说明“知道一种方法”和“把方法正确实现并验证”之间仍有距离。
协助研究已经发生,独立创新仍要另看
AI参与研发的价值,并没有因为这次结果消失。Anthropic在《When AI builds itself》中说,AI正在承担更多开发工作,工程师每季度交付的代码量相较2021—2025年的平均水平已增加到8倍。这是公司的内部自述,衡量的是代码产出,也没有证明AI已经能独立研发自己的下一代。
METR的长任务评测同样有明确口径。所谓“50%任务时长”,是AI预计能成功完成一半任务时,对应的人类专家工作时间。它主要基于软件任务,不能直接用来判断一项未知研究会不会成功。
InnovationEval这次只围绕一项训练创新,评测模型和运行次数也很少。模型不能联网,研究方向、基线和目标已经由人设置好。它既不能给全部科研能力下结论,也不能预测下一代模型何时跨过这道门槛。
它提供了一个有用的区分。AI能把研究里的许多工作做得更快;要让它独立提出新方法、证明增益确实来自这个方法,再把结果交给别人复现,还需要经得起逐项检查的证据。
消息来源
Epoch AI InnovationEval完整报告https://epoch.ai/publications/innovationeval
Epoch AI 10月9日研究通讯https://epochai.substack.com/p/can-ai-automate-ai-r-and-d-yet
SDPO原始论文https://arxiv.org/abs/2601.20802
Anthropic:When AI builds itselfhttps://www.anthropic.com/institute/recursive-self-improvement
METR长任务评测口径https://metr.org/time-horizons/
如果这篇对你有用,请点赞、留言、转发。