ARTICLE · 1153264
AI数字人口播:拍 10 秒视频、录一段声音,你的"数字分身"就上岗了,口播视频批量生成
AI数字人口播:拍 10 秒视频、录一段声音,你的"数字分身"就上岗了,口播视频批量生成
做口播视频的人,十有八九卡在同一个地方:不敢出镜,或者没时间出镜。
想日更,就得天天化妆、打光、对着镜头说几十遍; 想矩阵铺量,更不可能一个人分身十几个号。
现在这个问题有解了:克隆一个你。
形象是你,声音也是你,但拍摄、录音、出镜这些活,从此跟你没关系——文字喂进去,视频吐出来。
今天这篇,把 AI 数字人克隆的完整流程讲清楚。
一、它是怎么工作的?三步理解
整个逻辑非常简单:
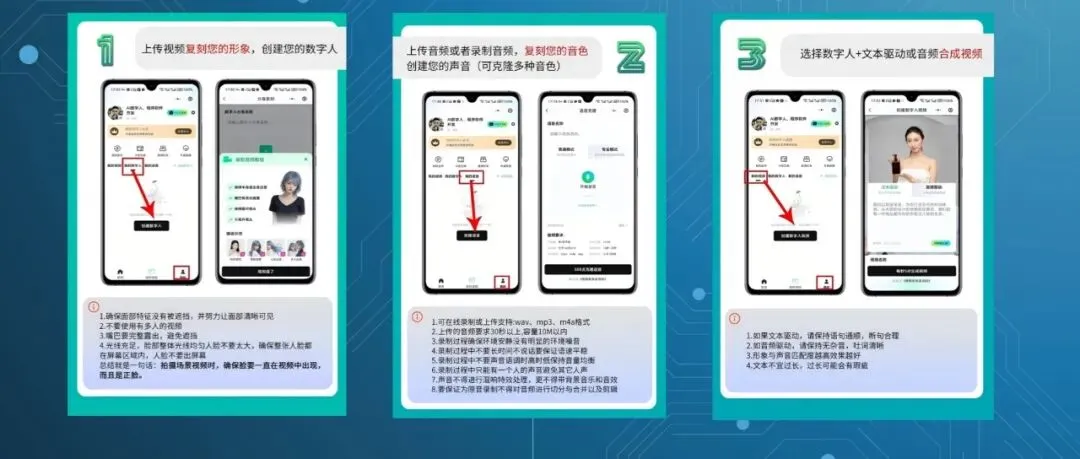
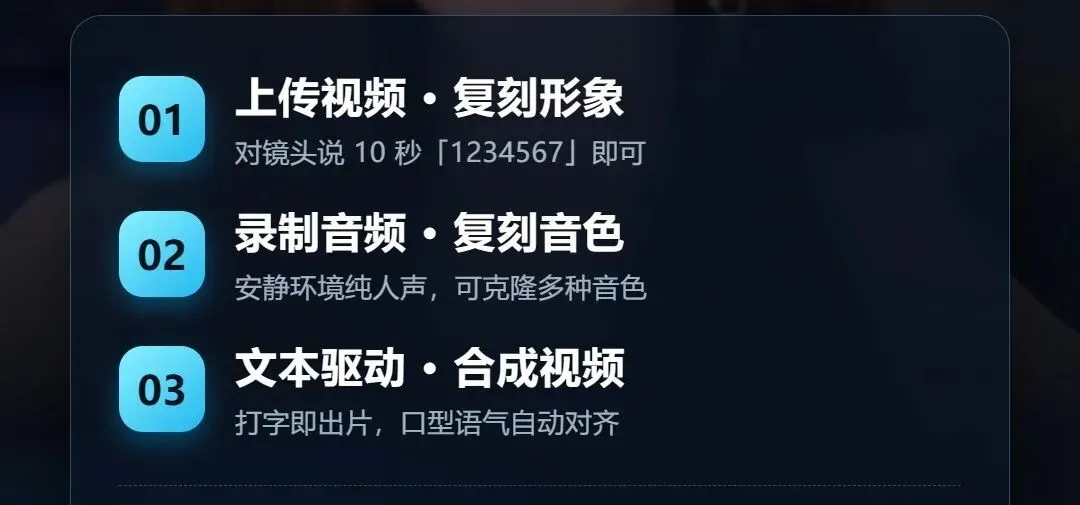
- 上传一段视频 → 复刻你的形象,创建数字人
- 上传或录制一段音频 → 复刻你的音色,创建声音(可克隆多种音色)
- 选择数字人 + 文本驱动或音频驱动 → 合成视频
之后你想发多少条口播,只需要打字。数字人替你说,口型、表情、语气全给你对上。
二、克隆教程:跟着做就行(重点收藏)
第 1 步:克隆形象
拍摄要求很简单:对着镜头说"1234567"就行,可以边玩边说、边化妆边说、边展示产品边说,只要不挡脸,说 10 来秒,多重复几次。
几个关键注意事项:
面部特征不能被遮挡,脸要清晰可见
- 不要用有多人的视频
嘴巴完整露出,避免遮挡
光线充足,整张脸都在画面框内
小程序网页版:克隆视频最好 30 秒以上
第 2 步:克隆声音
音频可以在线录制,也可以上传(支持 wav / mp3 / m4a,10M 以内)。想要克隆得像,记住这几条:
安静环境、空旷房间,纯清晰人声,旁边不能有杂音和别人说话声
选情绪激动的音频,符合实际语意的重音、低音尾音,语气抑扬顿挫
有口音、方言尾音都没关系,照样能学
不要混响特效,不要背景音乐和音效
原音录制,不能对音频切分、合并、剪辑
- 多次生成,取最好的一版
第 3 步:合成视频
- 文本驱动:打字输入文案,保持语句通顺、断句合理
- 音频驱动:直接上传配音
形象与声音匹配度越高,效果越好
文本不宜过长,过长可能会截断;生成视频最好 10~20 秒以上,不然容易创作失败
三、算一笔账:一条视频成本不到 3 块钱
直接看价格:
项目 | 内容 |
充值方案 | 580 元 = 3 万积分 |
计费方式 | 10 秒视频 = 1 积分 |
可产出 | 约 200~300 条视频 |
单条成本 | 约 2~3 元 |
对比一下:请人出镜拍口播,一条少说几百;自己拍,时间成本另算。
数字人的账,怎么算都划算——尤其考虑到它还能 24 小时不休息地量产。
四、适合谁用?
- 不敢/不想露脸的带货博主:数字人替你出镜,产品讲解照说不误
- 口播 IP 矩阵玩家:一个形象 + 多种音色,多账号批量铺内容
- 本地生活/探店商家:每天高频更新,不用老板本人天天拍
- 知识付费讲师:把课程文案喂进去,批量出切片
- 实体店老板:不会拍视频没关系,会打字就会做视频
一句话:凡是要"露脸说话"的视频,它都能替你出镜。
五、新手怎么上手?
网页版/微信小程序直接可用,也有安卓 APP(底部「AI 创作」→「视频数字人」→ 克隆视频)
有完整视频教程
零基础的小白,也可以约 2 小时 1 对 1 教学,把整个赛道系统过一遍
门槛已经低到:会打字,就会做视频。
六、写在最后
AI 数字人这件事,正在把"出镜"从视频创作的必需项,变成可选项。
当别人还在纠结今天化不化妆、开不开摄像头的时候,先用数字分身的人,已经日更十条了。
👉 关注我,下期演示:同一个数字分身,怎么一键换装、换音色,铺满整个账号矩阵。
有问题评论区见,看到都会回。