ARTICLE · 1153270
AI知识小课堂开课啦!!!
老婆有个群,看到群里人谈论起AI如数家珍,于是便和跟我控诉:你身为业内人士,自己进步也不带上老婆,太过分了!
儿子也在一旁狐假虎威的帮腔,就是就是,太过分了!
所以,为了全家共同进步,当时抽时间给他们两个做了两次基础知识的普及,例如大模型、Agent、Token、各大模型公司的介绍等等。
但是当时只是信马由缰,想到哪儿说到哪儿,遗漏很多,同时一些内容说的也不太对。
本着严谨的态度,再加上最近在搞Agent评测相关的事情,所以准备做一系列的课程文章,专门梳理一下这部分的知识体系以及……和家人一起进步。
emm……没错!
这个系列我准备分以下9个模块来进行,既兼顾了基础知识的普及,也为自己工作打个基础。但不保证这些内容不变,随着课程的展开可能会微调一下具体内容。
课程名称 | 核心概念 |
|---|---|
Token与上下文 | 词元、上下文窗口 |
Prompt工程 | 角色设定、少样本、结构化输出 |
模型原理速览 | 预测下一个词、对齐、幻觉 |
检索增强RAG | 向量化、切片、召回与重排 |
工具调用 | JSON Schema、参数校验 |
Agent循环 | ReAct:思考-行动-观察 |
记忆与状态 | 短期摘要、会话存储、长期记忆 |
多Agent编排 | 路由、分工、图执行 |
评测与安全 | 测试集、提示注入、最小权限 |
接下来,就开始今天的第一课!
先来看一个例子:
假如我对一个任意的大模型的对话框里输入“你好”。
模型并不能直接“读”这两个字,因为模型是纯数学函数,只能接受数字,不能直接读文字。
而要想将文字转换成数字,就需要先把一句话中的所有文字先一个个的“切开”,这个最小不可再分的单位就是词元(token)。
每个词元对应一个数字编号,也就是“词表里的序号”。
这样,大模型就能“看到”我说的这句话了,实际上也是一个数字结构的序列,比如(示例)[123][456]这种,或被切成“你”和“好”两个数字编号。
模型读的就是这些编号,不是文字本身。
关于文字的切分,也并不是简单的按照单个字或单个单词来分的。
比如“我爱北京”,分出来的结果可能是“我”,“爱”,“北”,“京”,也可能是“我”,“爱”,“北京”;
而一个单词“playing”则可能会被切成“play”和“ing”。
注意我这里用的词是“可能”,因为Token的切分有不同的算法,并且不同的大模型公司也都各不相同,所以这里我就不展开了,感兴趣并且可以访问的可以在这个地址中的工具感受一下👉https://platform.openai.com/tokenizer
在了解了Token的概念后,那么关于上下文就容易理解了。
还是先举个🌰:
假如你和大模型在同一个对话框中聊了很久,在第40轮时,你问大模型:刚才第一个问题中,我提到的那本书,你能大概介绍一下吗?
结果很有可能你会得到一个模糊、甚至是错误的答案。
是大模型“忘了”吗?这么说并不准确,应该说是:你在前面提到的内容,已经不在当前这一步它能看到的内容范围内了。
假如大模型是一个书架,最多只能放10本书,随着你在这个书架的一头不断的放入新的书(和大模型聊天),书架也会越来越满直到放满10本书。之后你要再想继续放书,那么久只能把前面的书拿走。
这个书架十本书的容量,就相当于大模型的上下文窗口(Content window)。
一句话定义一下:上下文窗口,是模型一次计算能够处理的词元(Token)总数上限,通常指输入词元与本次生成输出词元的合计。
注意,上下文窗口都是按"输入 + 输出词元"的合计上限来描述,并且目前大模型的计费方式也都是按照输入token、输出token分别来计算的。
这里大概列一些目前主流大模型的一些上下文大小以及价格(来自于Openrouter):
名称 | 上下文长度 | 输入价格 | 输出价格 |
|---|---|---|---|
Claude Opus 5 | 1M context | $5/M | $25/M |
GPT-6.1sol | 1.05M context | $1/M | $5/M |
GLM 5.3 | 1M context | $2.8/M | $8.8/M |
DeepSeek V4 Pro | 1.95M context | $0.3/M | $5/M |
Kimi-k3 | 1.05M context | $0.7/M | $15/M |
这里的单位用的都是“M”,也就是“百万”。可以看到各家主流的旗舰模型基本都达到了1百万上下文的长度,折合汉字大概相当于60~70万汉字(大概估算),已经可以读完一整本书了。
好了,现在把前面的内容一起串起来看一下:
和大模型聊天,大模型会把你的话切和一个个的词元,然后去计算答案中词元的概率(下一节课讲)生成一条完整的答案。
并且多轮对话中的每一轮循环,都会把当前窗口下的所有内容都重新计算一遍(先简单这么理解),这个容纳所有内容的池子的大小,就是上下文窗口。
看到这里,聪明的你肯定要问,为啥不把这个池子做的更大呢?甚至做成“无限窗口”?
大模型每一步生成时,模型要把当前位置与序列里每一个已有位置做一次"关系计算",才能判断哪些前文对下一步最重要。这套机制叫注意力(attention)。
而这套以注意力为核心的 Transformer 结构,就是当今主流语言模型的基础。
既然要把当前位置与每一个已有位置都算一遍,那么就会导致:
序列长度翻倍,需要计算的位置配对大约是原来的 4 倍(配对数是"长度 × 长度",也就是随长度平方增长);
同时,参与比较的各位置信息都要保存在内存里,所需空间也随长度增长。
嘶~~要长脑子了,快停下来!!!
简单来说呢,就是这个池子(序列)的长度必须有一个上限,否则内存和算力都会扛不住。上下文窗口就是从这一套机制里得到的一个必须要有的约束。
那么超出后发生了什么呢?不同的模型可能会有区别,常见的做法包括:
丢掉最早的那部分内容(对话太长时丢弃最前面的几轮);
把较早的内容压缩成一段摘要,当前的Agent都提供了自动或手动compact的操作,也就是压缩;
把长文档切块,只挑与当前问题相关的块送进来(这种做法通常叫检索增强生成,retrieval-augmented generation)。
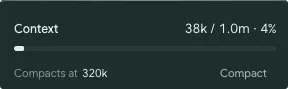
现在回过头来看看前面的那个问题,答案是不是就呼之欲出了?
大模型之所以会给一个模糊或者错误的答案,根本原因就是内容已经超出了它的上下文长度,已经不在它的计算范围之内了。
好了,今天的课就先讲到这儿吧!最后给大家留几道题吧,答案可以写在评论区。要好好做,老师下节课要检查哦(敲黑板)~
问题一(判断题):
模型直接阅读原始文字,不需要先经过 token 转换。
问题二(判断题):
上下文窗口的大小,是由厂商为了区分不同价位的产品而随意设定的。
问题三(判断题):
所有的模型的Token切分方式都使用的是同一种逻辑,了解了一种就相当于了解了所有。
问题四(选择题):
一场长对话聊到后面,模型答错了你在开头说过的内容。最贴近机制的解释是:
A. 模型把那条信息从长期记忆里删掉了
B. 模型认为那条信息不重要,主动忽略了
C. 那条信息所在的词元已不在这一步的计算范围内
D. 模型每次回答都会重置,无法读到你写的内容
OK,下课~