ARTICLE · 1161317
AI快速发展下,音视频从业者还要沉下心来钻技术吗?
这两年,一个很现实的问题开始摆在音视频从业者面前:以前需要工程师花几天研究的FFmpeg命令、播放器Demo、协议接入和线程代码,现在借助AI很快就能生成;过去需要翻RFC、查源码、反复调试的问题,大模型也可以迅速给出分析思路。于是一个问题越来越频繁地被提出:AI这么强了,音视频从业者还有没有必要继续沉下心研究编解码、协议、时钟、缓存、弱网、硬件加速和跨平台这些“老技术”?
我的判断是:不仅需要,而且真正有深度的技术积累正在变得比过去更有价值。 AI降低的是进入音视频开发的门槛,却没有消除高质量实时媒体系统的工程门槛。当越来越多人都能迅速做出Demo,真正拉开产品差距的,反而会更加集中在低延迟、稳定性、设备兼容、异常恢复、性能、跨平台和长期运行这些深水区。
站在大牛直播SDK(SmartMediaKit)这样一个长期从事实时音视频研发团队的视角来看,行业真正发生的变化不是“音视频技术还值不值得做”,而是什么样的音视频技术,未来才真正有价值。
一、AI降低了编码门槛,却没有降低音视频工程的门槛
过去音视频开发门槛很高,一个工程师需要理解H.264/H.265、SPS/PPS、GOP、PTS/DTS、RTP/RTCP、RTSP、RTMP、AAC、YUV、硬件解码以及多线程,才能比较完整地搭建一条媒体链路。今天AI已经可以帮助完成大量基础代码,包括协议解析、数据结构、Demo程序、测试代码甚至局部重构,这实际上是一件好事,因为工程师可以把越来越多时间从重复编码中释放出来。
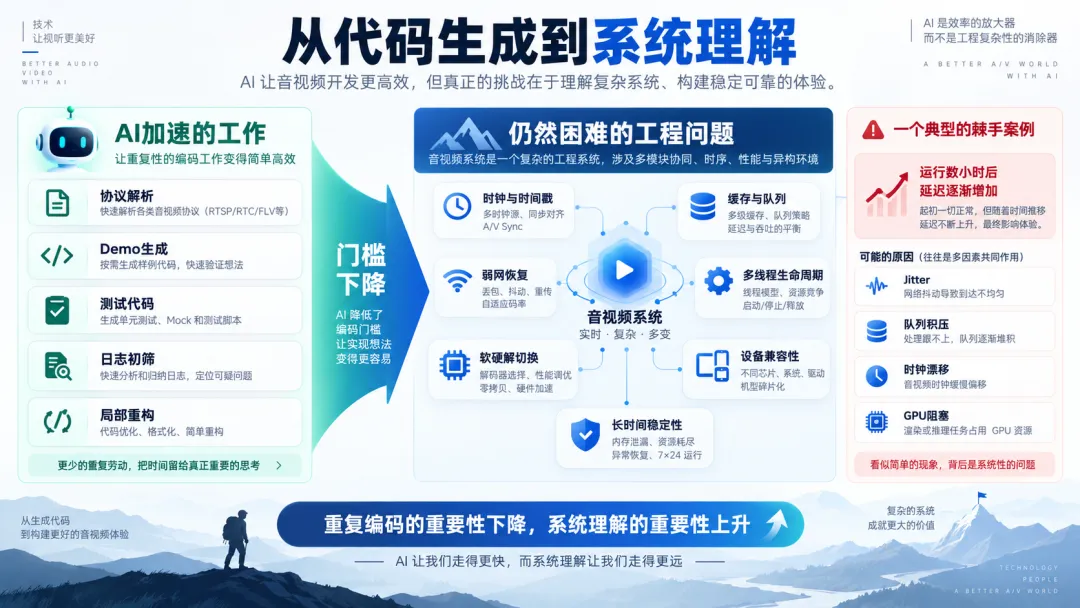
问题在于,音视频系统最困难的部分从来不只是“代码怎么写”。比如断流重连以后旧数据是否会污染新会话,多实例运行时CPU、GPU和内存如何管理,网络抖动以后为什么延迟持续积累,不同厂家的H.264/H.265码流为什么表现不同,一个系统连续运行数天之后生命周期是否仍然正确。这类问题往往代码量并不大,真正困难的是理解系统行为。
例如“播放器运行几个小时以后延迟逐渐增加”,背后可能是Jitter Buffer、生产消费速度差异、音频时钟漂移、解码排队、GPU阻塞、线程调度或者时间戳处理问题。AI可以帮助阅读代码、分析日志和缩小范围,但如果工程师不知道一个正确的实时系统应该具备什么样的状态,很难真正完成判断。
所以AI时代非常重要的变化并不是“工程师不需要懂底层了”,而是:重复编码的重要性下降,系统理解的重要性上升;会不会写代码的差距缩小,能不能把复杂系统做正确的差距反而扩大。
二、基础功能会越来越容易实现,竞争焦点会从“有没有”转向“做得怎么样”
今天实现一个RTSP播放器Demo并不困难,实现一个RTMP推流程序也越来越容易。但Demo和商业产品之间,从来不是有没有一个play()或者startPush()接口的差别。
真正进入项目以后,问题会迅速复杂起来:不同摄像机输出的码流是不是都能正确解析,TCP和UDP切换是否稳定,编码参数发生变化怎样处理,软硬解码怎样选择,多实例怎样控制资源,网络恢复以后延迟能不能重新回到正常水平,录像过程中发生断流怎么办,程序退出时线程、Socket、解码器和GPU资源能不能全部正确释放。
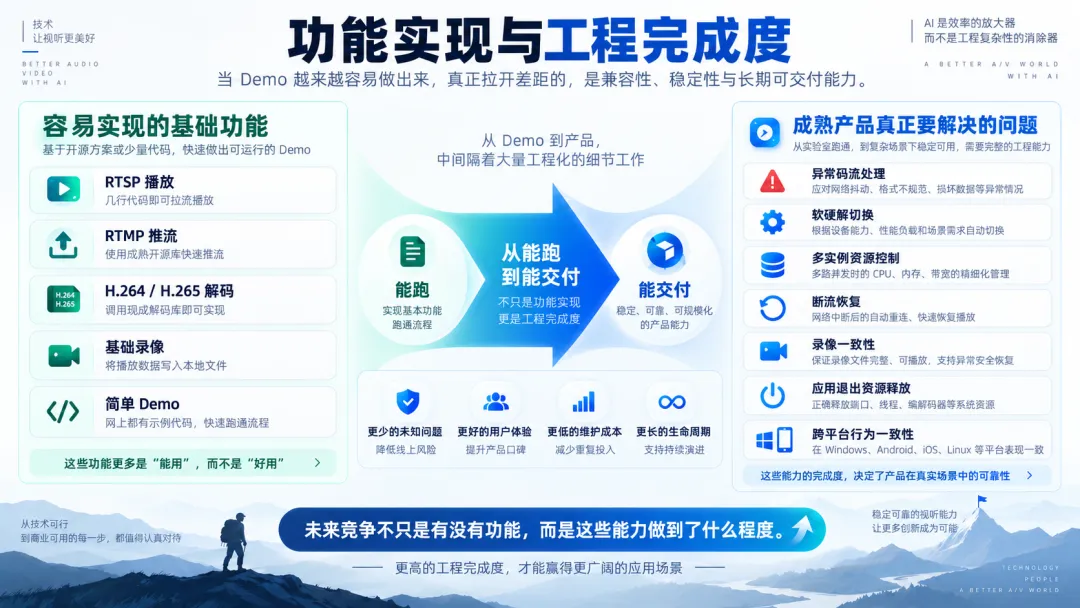
因此未来音视频产品的竞争,不会简单停留在“支持RTSP”“支持H.265”“支持WebRTC”这样的功能表,而会越来越关注完成度。同一个协议,有人做到“Demo能运行”,有人做到弱网、断流、异常码流和长时间运行仍然可靠,两者在功能列表上可能完全一样,但实际工程价值完全不同。
这也是AI带来的一个有意思的变化:功能实现越来越透明以后,行业反而更容易认识到功能和产品之间的差距。未来真正形成壁垒的,不是一个协议是否能够接通,而是大量真实设备、真实网络和异常状态最终沉淀出来的兼容性、稳定性和可维护性。
三、AI越深入实时业务,时钟、缓存、网络这些“老技术”反而越重要
过去音视频系统主要服务于人,画面晚200ms,很多时候只是体验上的区别;但当实时视频开始进入机器人、无人机、工业视觉和多模态AI系统以后,同样的200ms可能意味着完全不同的问题。
例如机器人根据摄像头画面做动作,如果视频经过采集、处理、网络、解码和模型推理以后已经延迟500ms,那么AI即使判断完全正确,分析的也可能是半秒以前的世界。无人机远程巡检也是一样,4K并不能代替低延迟——操作人员真正需要的是当前现场的清晰画面,而不是几秒以前的高清画面。
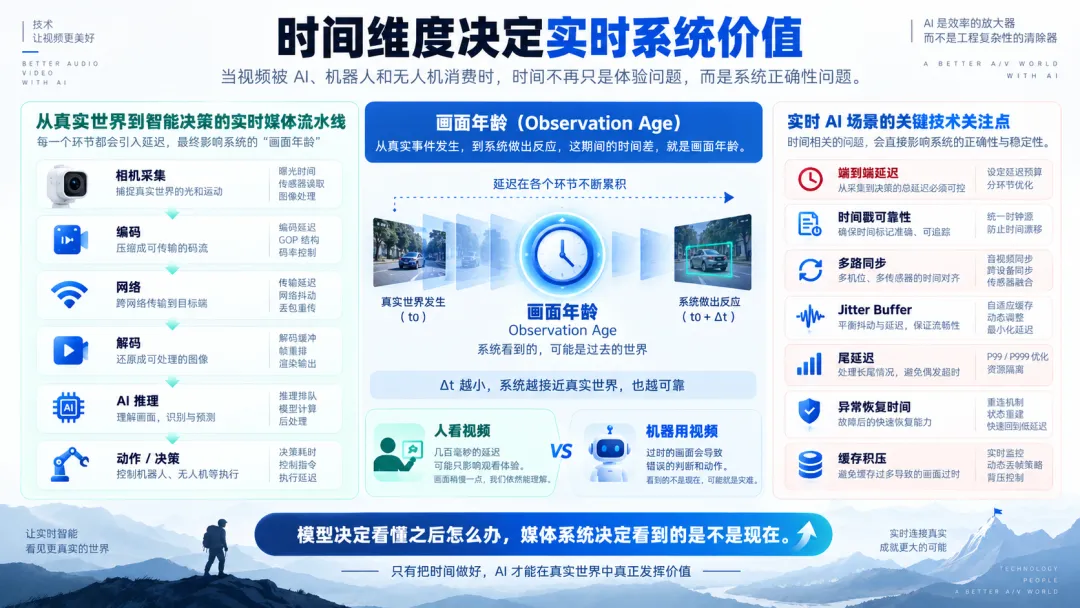
这使音视频系统开始关注更多“时间维度”的指标:端到端延迟、画面年龄、PTS与实际采集时间的关系、跨设备时间同步、多传感器时间轴、P95/P99尾延迟、网络恢复时间以及缓存是否持续积压。
于是RTP时间戳、Jitter Buffer、音视频同步、GOP恢复、队列长度、生产消费模型这些看起来很传统的技术,并没有因为AI出现而失去意义。恰恰相反,当媒体数据直接参与机器判断和动作以后,它们从“播放体验问题”逐渐变成了“系统正确性问题”。
模型决定看懂之后怎么办,实时媒体系统决定模型看到的究竟是不是现在。
这会成为未来AI与音视频结合中非常重要的一条技术分界线。
四、音视频正在从“内容技术”走向“现实世界的数据基础设施”
过去谈音视频行业,人们通常想到直播、短视频、视频会议和安防监控。这些市场仍然重要,但新的增长空间正在出现:摄像头越来越不只是给人看的设备,而正在成为机器感知物理世界的重要传感器。
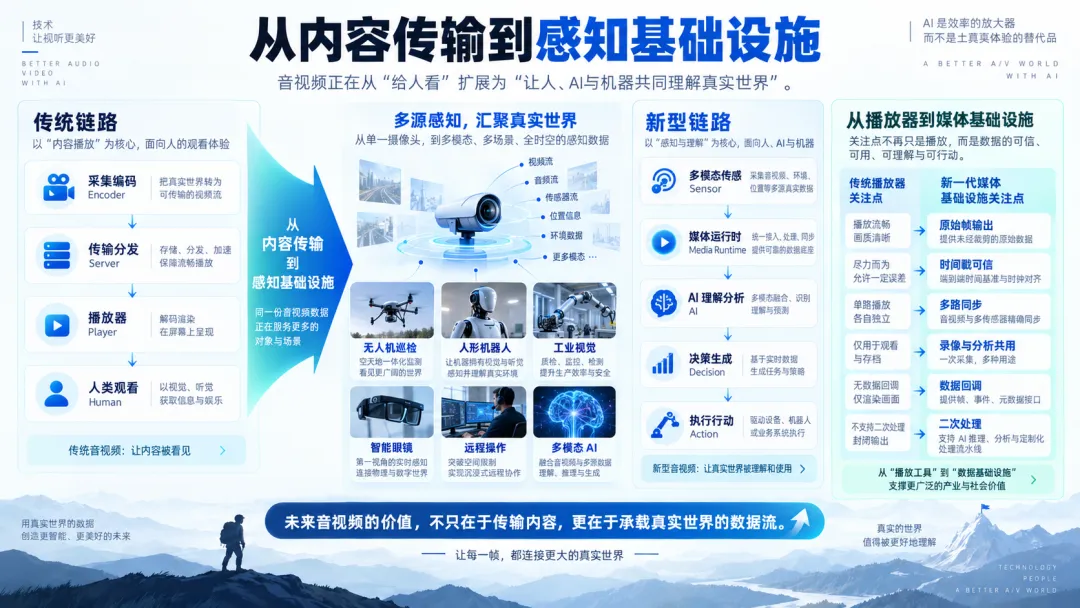
无人机利用视频巡检电力线路,人形机器人依靠多路视觉理解环境,工业系统通过视频检测产品缺陷,智能眼镜把第一视角交给多模态模型,远程机器人同时需要实时视频和人工接管。过去典型的视频链路:
Encoder → Server → Player → Human
正在逐渐扩展成:
Sensor → Media Runtime → AI → Decision → Action
视频的消费者也由“人”扩展成人、CV算法、多模态模型、VLA、机器人和自动化系统。这会改变未来音视频基础能力的设计:播放器不再只关心画面能不能显示,还要关心原始帧能不能稳定输出,时间戳是否可信,多路相机能否同步,AI处理结果能不能重新进入媒体Pipeline,录像能否关联任务状态和算法结果,同一份媒体数据能不能同时服务观看、分析和留存。
这意味着音视频工程师的角色也会逐渐发生变化。未来一部分优秀从业者可能不再只是传统意义上的Streaming Engineer,而会越来越接近:
Real-Time Media & Sensor Infrastructure Engineer。
音视频没有离AI越来越远,反而正在成为AI进入真实世界的重要入口之一。
五、AI会重构开发方式:工程师的价值从“写得快”转向“定义得对”
AI真正会深刻改变的,是音视频工程师的工作方式。协议代码、测试代码、平台适配、Crash日志分析和局部重构,都可以越来越多地由AI协助完成,因此高级工程师未来可能不再把大部分精力花在敲代码上,而是更多用于定义系统边界。
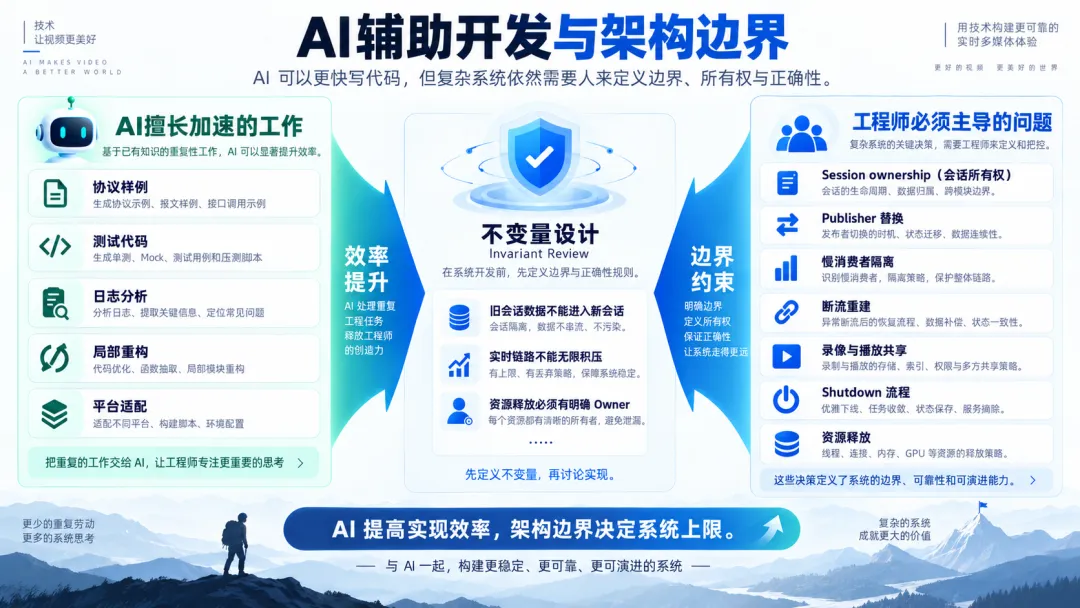
比如一个媒体Source究竟由谁拥有,Publisher发生替换以后旧连接什么时候失去资格,慢消费者能否影响其他消费者,断流以后谁负责重新建立Source,录像与播放之间如何共享数据,Shutdown到底由谁发起、谁等待、谁最终释放资源。
这些问题如果设计错误,AI写代码越快,反而可能越快把错误扩散到整个系统。
因此未来很重要的一项工程能力,是从传统Code Review进一步走向Invariant Review——先定义系统中哪些条件绝不能被破坏。例如旧会话的数据不能进入新会话,慢消费者不能无限拖慢整个媒体源,实时链路不能无限积压,生命周期必须存在清晰Owner,然后再让AI协助完成实现和测试。
所以AI时代真正稀缺的不会是“最会敲代码的人”,而是:
能够把复杂问题定义清楚,并且知道什么才算正确的人。
这一变化对于长期积累大型代码库、测试体系和实际产品经验的团队,反而是明显利好。AI不是替代这些积累,而是提高它们的迭代效率。
六、真正的技术壁垒,会逐渐从正常场景迁移到极限条件
随着普通功能越来越容易实现,真正体现专业技术能力的问题会更多集中在极限条件。正常网络下一路视频播放并不难,真正困难的是弱网、丢包和抖动下还能不能维持可控延迟;标准H.264码流大家都能处理,真正困难的是各种异常SPS/PPS、参数变化、时间戳跳变以及厂商非标准行为。
一路硬件解码不难,几十路同时运行以后才真正涉及GPU上下文、显存、线程和资源调度;Demo运行半小时很容易,7×24小时连续运行一个月以后,内存泄漏、Socket生命周期、线程退出和错误恢复才开始真正暴露。
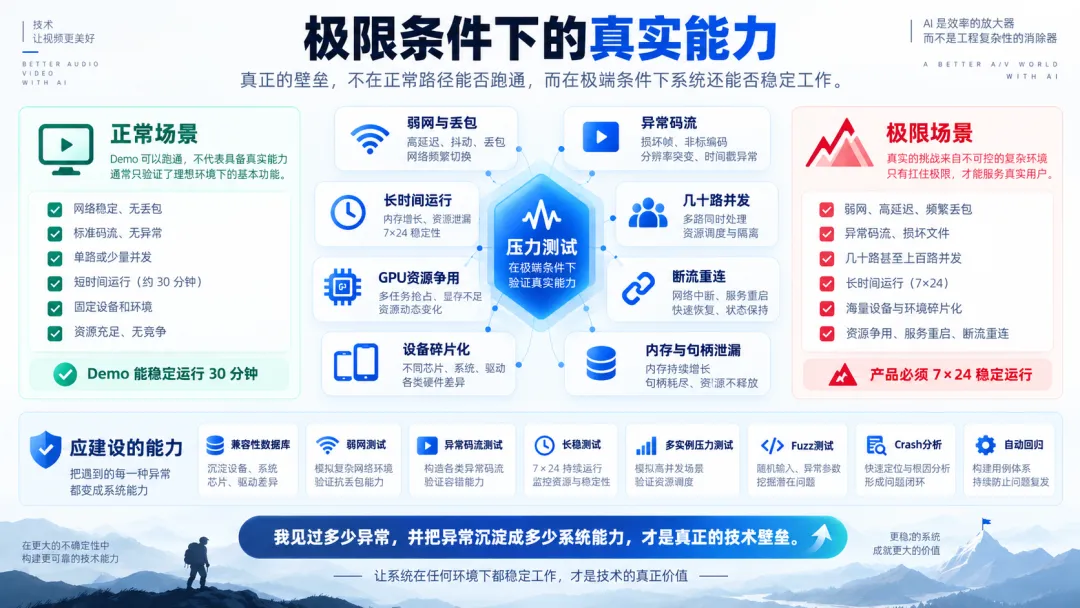
所以未来音视频技术资产中很重要的一部分,并不是代码本身,而是多年形成的边界条件知识:哪些设备会产生特殊码流,哪些网络状态容易造成延迟累积,哪些硬件解码器存在平台差异,哪种恢复策略在实际系统里更可靠。
这意味着真正值得长期投入的技术建设,包括设备兼容数据库、弱网测试、异常码流测试、长稳测试、性能基线、多实例压力测试、Fuzz测试、Crash分析和自动回归。
AI可以帮助完成这些工作,却无法凭空创造多年真实环境中形成的数据和经验。未来专业技术壁垒,很大一部分恰恰会从“我会不会实现”迁移到:
“我见过多少异常,并且有没有把这些异常变成系统能力。”
七、AI时代,专业音视频能力的价值会越来越体现为“缩短产业化路径”
AI可以让一个团队很快做出播放器、推流器甚至WebRTC Demo,但企业真正要交付机器人、无人机、工业视觉、安防设备或者远程协作产品时,核心竞争力通常并不是重新实现一套媒体协议。
机器人团队更应该把精力放在运动控制和智能模型,无人机团队应该关注飞控、航线和任务系统,工业视觉企业应该持续提升算法和行业Know-how。对于这些企业而言,成熟音视频能力的价值就在于:把复杂但非自身核心竞争力的媒体问题,转化成稳定、可复用的基础能力。
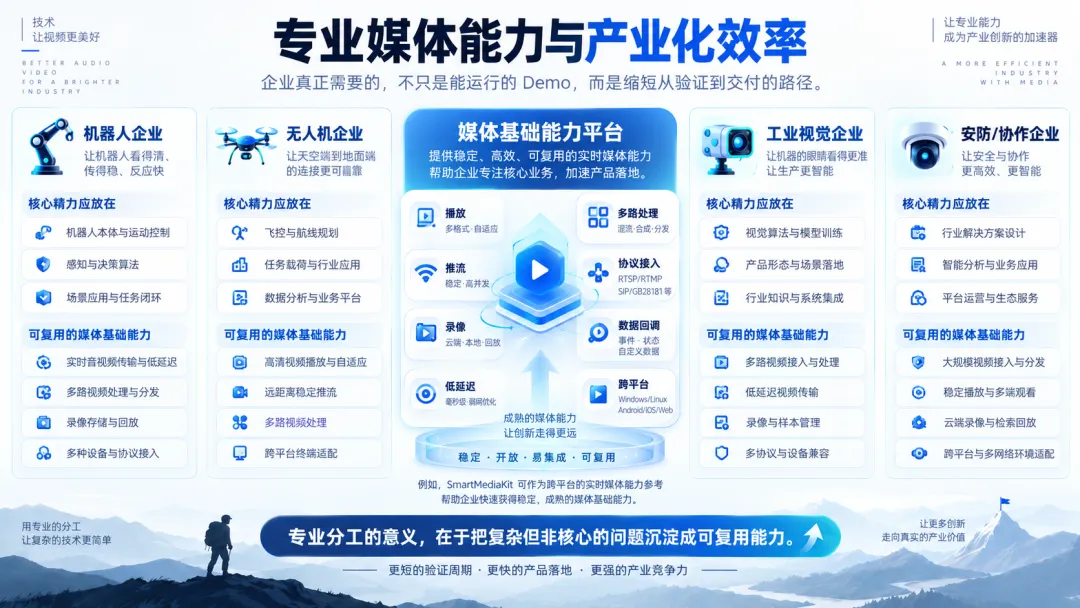
这也是包括SmartMediaKit在内的专业音视频SDK长期存在的价值。十余年积累的跨平台播放、推流、录像、GB28181、轻量RTSP服务、多路媒体处理以及低延迟能力,本质上是在帮助客户减少媒体底层的重复研发,把更多工程资源放到自己的核心业务。
AI时代,这种专业分工不会消失,反而可能更加清晰。因为客户越来越容易验证一个功能“能不能做”,也就更容易把注意力转向另一个真正影响产品落地的问题:
自己有没有必要重新把它做十年。
专业SDK未来真正提供的,不只是API,而是研发周期、兼容经验、稳定性和持续维护能力。这种价值不会因为AI能够生成Demo而消失,反而会随着产品开发速度加快变得更加突出。
八、AI时代,还要不要沉下心钻音视频技术?
答案是:要,而且需要钻得更深,但不应该再按照过去的方式钻。
如果所谓技术深度只是背API、记FFmpeg命令、熟悉几个库的调用方法,那么这部分价值一定会下降。真正值得长期投入的,首先仍然是媒体基本功,包括编码、GOP、颜色空间、PTS/DTS、RTP/RTCP、WebRTC、音视频同步;其次是系统工程,包括线程、生命周期、锁、内存、异步架构、零拷贝和硬件加速;再往上则是网络与实时性、AI与媒体融合、测试与可观测性,以及越来越重要的行业理解。
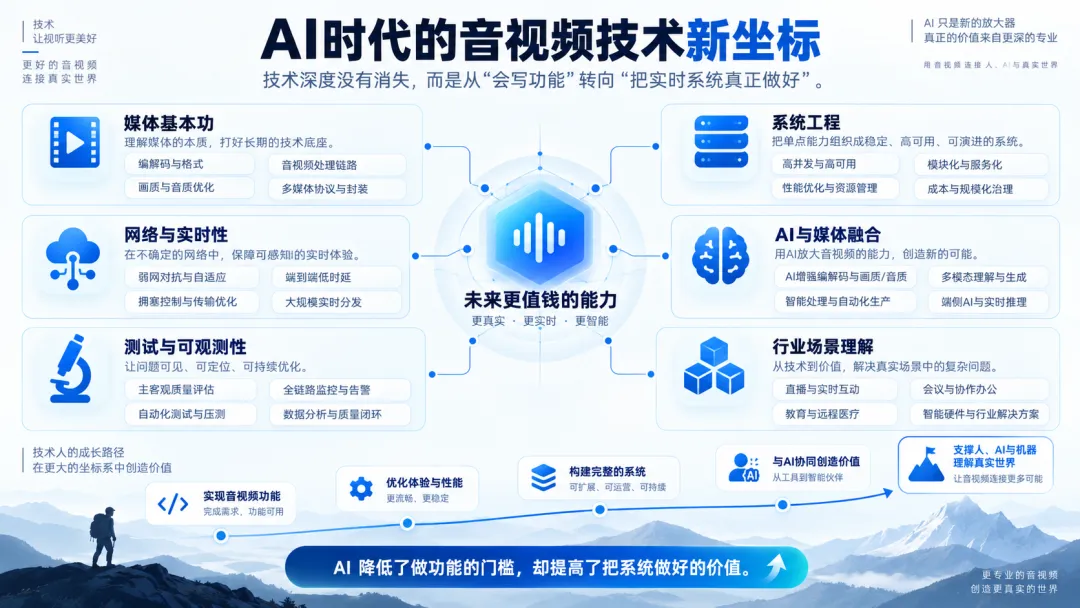
未来优秀的音视频工程师不能只知道“怎样降低100ms延迟”,还需要理解为什么机器人不能看到旧帧,为什么无人机弱网时不能无限缓存,为什么工业视觉需要保留真实原始数据,为什么AI分析需要可靠时间戳。
这其实是一场非常明显的职业升级。过去我们解决的是:
视频怎样采、编、传、播。
未来进一步要解决的是:
怎样让真实世界稳定、及时、可信地进入人、AI和机器。
所以音视频行业确实会“大变天”,但变化并不等于行业失去价值。大量浅层和重复开发会被AI显著加速,普通功能的实现门槛会不断下降;与此同时,实时媒体正在进入机器人、具身智能、无人机、工业视觉、智能眼镜和多模态AI等新的领域,行业的边界反而在扩大。
真正值得坚持的,不是和AI比赛谁写代码更快,而是利用AI把工程能力做得更深。因为未来最稀缺的,可能不再是一个能快速写出播放器的人,而是能够解释:
为什么这个实时系统在弱网、异常设备、高并发、长期运行和复杂业务条件下,仍然能够正确工作。
AI降低了“做出音视频功能”的门槛,却提高了“把实时音视频真正做好”的价值。
这或许才是AI快速发展以后,音视频从业者更应该沉下心钻技术的真正原因。