ARTICLE · 1161315
multica 源码 16:标签是怎么挂到 issue 上的——Label 数据模型与跨资源设计
一张目录表,一条五层链路,把多租户 SaaS 的设计考点串了一遍
Multica 的数据库里有张表在撒谎。它叫 issue_label,按名字只装 issue 的标签,实际上 agent 和 skill 的标签也存在里面。
同一个「bug」,issue 一个、agent 一个、skill 一个,三行,互不相干。
我在拆这个开源 AI Agent 平台的源码,这是系列第 16 篇。这次看全系统最不起眼的功能:标签。
结论先放这:功能小,课文大。从你点下标签,到所有客户端同步更新,中间是一条设计相当讲究的链路。
先看表:一张目录表,三个命名空间
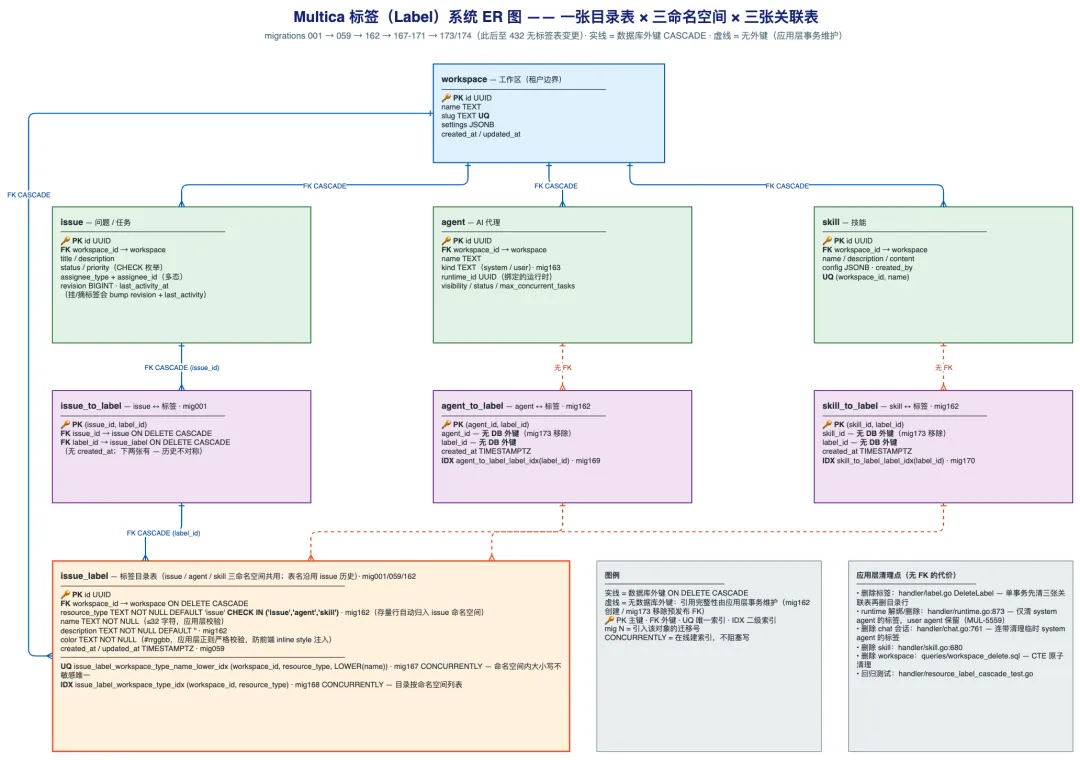
标签体系一共四张表:一张目录表 issue_label,三张关联表 issue_to_label、agent_to_label、skill_to_label。
目录表管「有哪些标签」,关联表管「谁挂了它」,每组关系就是一行(资源 id,标签 id)。
多对多不新鲜。值得看的是目录表用一列 resource_type 把三个命名空间装进同一张表,CHECK 约束限定只能取 issue、agent、skill 三个值。
直接收益:一套 CRUD 服务三个命名空间,列表、计数、挂载全部复用,比每种资源各建一张目录表少两次 JOIN。代价是表名从此名不副实,这个后面再说。
目录表上有个值得逐字读的唯一索引:
(workspace_id, resource_type, LOWER(name))
三段各有分工。
workspace_id 管租户隔离,各 workspace 的标签词汇表彼此独立。
resource_type 管命名空间隔离:issue 的「bug」和 agent 的「bug」是两个标签。
LOWER(name) 管大小写,表达式索引让数据库替应用做归一,防住 Bug/bug 两种写法把选择器搞混。
一个索引,把多租户、多态、归一三件事全办了。
挂标签:一个动作,过三道关卡
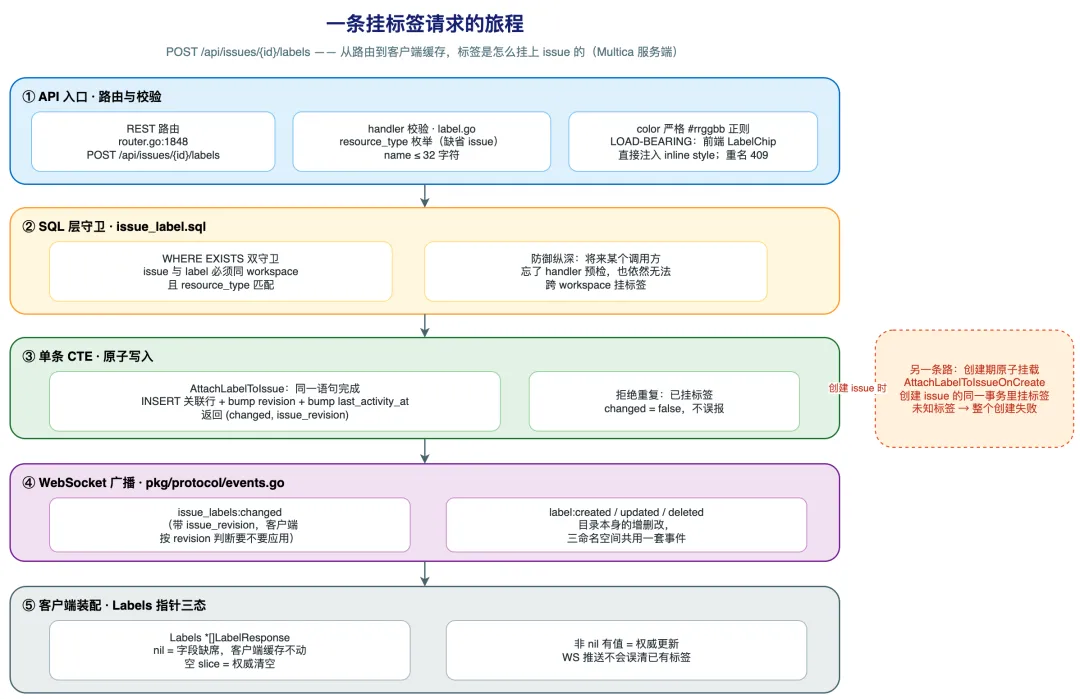
回答标题的问题:标签是怎么挂到 issue 上的。
第一道关卡在路由和 handler。POST /api/issues/{id}/labels 进来,label.go 先做校验。
resource_type 只认三个枚举值,name 限 32 字符,color 必须严格匹配 #rrggbb 正则。
color 正则旁边标着 LOAD-BEARING,承重墙。前端 LabelChip 组件拿到颜色直接塞进 inline style,正则一旦放宽,就是一个样式注入面。
一个正则同时管两件事:数据格式,安全边界。
第二道关卡在 SQL。挂标签的语句带 WHERE EXISTS 守卫:issue 和 label 必须存在于同一个 workspace,且 resource_type 匹配。
查询文件的注释写得很直白:将来某个调用方忘了 handler 层的预检,也依然无法跨 workspace 挂标签。
这是我读这份代码最认同的一处。「handler 会检查」和「数据库再兜一道底」,他们选了两个都要。
这种防御纵深在开源项目里不算标配,我读过的多数实现只有前一层。
过了两道关卡,写入是一条 CTE 搞定:插关联行、bump revision、bump last_activity_at,一个语句原子完成。
返回值有讲究:changed 和 issue_revision。已挂过的标签再挂一次,changed 是 false,不误报。
创建 issue 时挂标签走另一条路:AttachLabelToIssueOnCreate 在创建 issue 的同一个事务里挂标签。
传了不存在的 label_id,整个创建直接失败,不留半成品。
挂完之后:一次广播,三种状态
写入成功,事情没完。服务端往 WebSocket 发 issue_labels:changed,带上 issue_revision,开了页面的客户端都收到这份广播。
客户端这边有个我在 WS 同步实现里少见的设计:响应里的 Labels 字段是指针,三种状态三种语义。
nil 表示字段缺席,这条更新没动标签,客户端缓存原样不动。
空 slice 是权威清空,服务端明确说标签全摘了。
非 nil 有值是权威更新,照单全收。
没有这个区分,任何一条不带标签字段的更新,都可能把客户端已有的标签误清掉。指针加 omitempty,Go 的一个常规操作,钉死了同步语义。
批量装配也顺手看了:issue 列表页一次拉几十条 issue,标签怎么装?labelsByIssue 用 ANY(uuid[]) 一次数据库往返全装完,不产生 N+1。
表格视图还把标签做成了过滤器:filters.label_ids 翻译成 EXISTS 子查询,facets 按 label_id 分组计数,驱动筛选 UI 上的数字。
这套表不是一天长成的
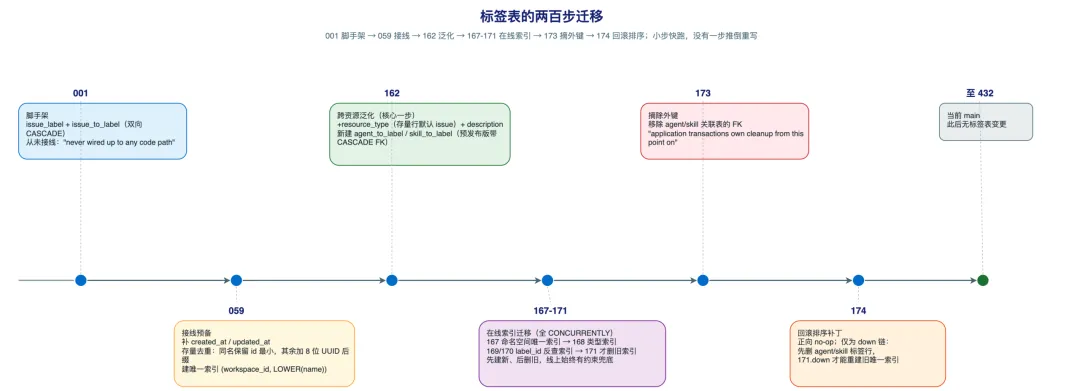
把 001 到 174 的迁移链读完,能看到每一步只做一件事。
001 建表,纯脚手架。059 的注释说它「never wired up to any code path」,一行业务代码都没接过。
059 接线前先干了件脏活:存量去重。同名标签保留 id 最小的,其余改名追加 8 位 UUID 后缀。
为什么必须先去重?唯一索引会被任何一行重复数据整体搞失败。先修数据,再上约束。
162 是核心一步:加 resource_type 和 description,存量行靠 DEFAULT 'issue' 无感归位,同时新建 agent、skill 两张关联表。
167 到 171 是一组在线索引迁移,全部 CONCURRENTLY 执行,顺序讲究:先建新的命名空间唯一索引,再建类型索引和反查索引,最后才删旧索引。
任何时刻,线上都有完整约束兜底。
173 把 agent、skill 关联表的外键摘了,清理职责移交应用事务。注释原话:「application transactions own cleanup from this point on」。
这个取舍值得单独展开,先记住结论:数据库级联表达不了「删一半、留一半」的细粒度策略。
174 最有意思:正向是 no-op,存在的意义仅为回滚排序——down 链自高向低执行时,得先删掉 agent/skill 的标签行,171 的 down 才能重建旧索引。
读完的感受:没有一步推倒重写。为一个回滚顺序专门补一个空迁移,这种洁癖,多数团队做不到。
边界:抄之前先对表
第一,issue_to_label 至今保留双向 CASCADE 外键。同一套系统两种范式并存,谁也没被当成教条。
第二,应用层清理靠纪律维持。没有 CASCADE 兜底,每新增一条删除路径都得记得清标签,漏一处就是孤儿行。好在有专门的回归测试钉死这些语义。
第三,表名在撒谎。issue_label 里装着 agent 的标签,读代码的人第一眼会困惑,他们选择写注释解释,而不是改名。
第四,CLI 还没暴露 resource_type 参数,命令行实际只能管 issue 命名空间。API 三命名空间全覆盖,CLI 未跟进,是个现状缺口。
另外有个同名陷阱:autopilot_trigger 表也有个 label 列,那是触发器的显示名,跟标签实体无关。搜代码时别被带偏,我自己就被带偏过一次。
最小功能的完整考点
标签是 Multica 里最小的功能之一。但把「挂一个标签」拆到语句级,一节一个考点。
多租户隔离在索引里,防御纵深在 SQL 里,在线演进在迁移链里,同步语义在一个指针上。
这也是我把走读做成系列的原因。大架构几篇就讲完了,真正长功力的,是这些小地方的设计决定。
你见过的多租户数据隔离,是靠外键、靠应用层事务,还是靠数据库行级安全?留言聊聊你的取舍。