ARTICLE · 1161843
AI推理超过数据库,软件公司正在变成分销商
AI推理超过数据库,软件公司正在变成分销商2010 年代中期,一家创业公司只要在数据库市场拿到 2% 的份额,就能走到 IPO。数据库是那个年代软件业最重要的品类,这个说法没什么人反对。推理正在超过它。 2025 年,企业在运行 AI 模型上花了大约 250 亿美元。今年这个数字涨到 1300 亿美元左右,已经贴近 Gartner 给数据库市场的 1610 亿美元预测。到 2027 年,AI 推理约 3500 亿美元,数据库 1900 亿美元,前者接近后者的两倍。 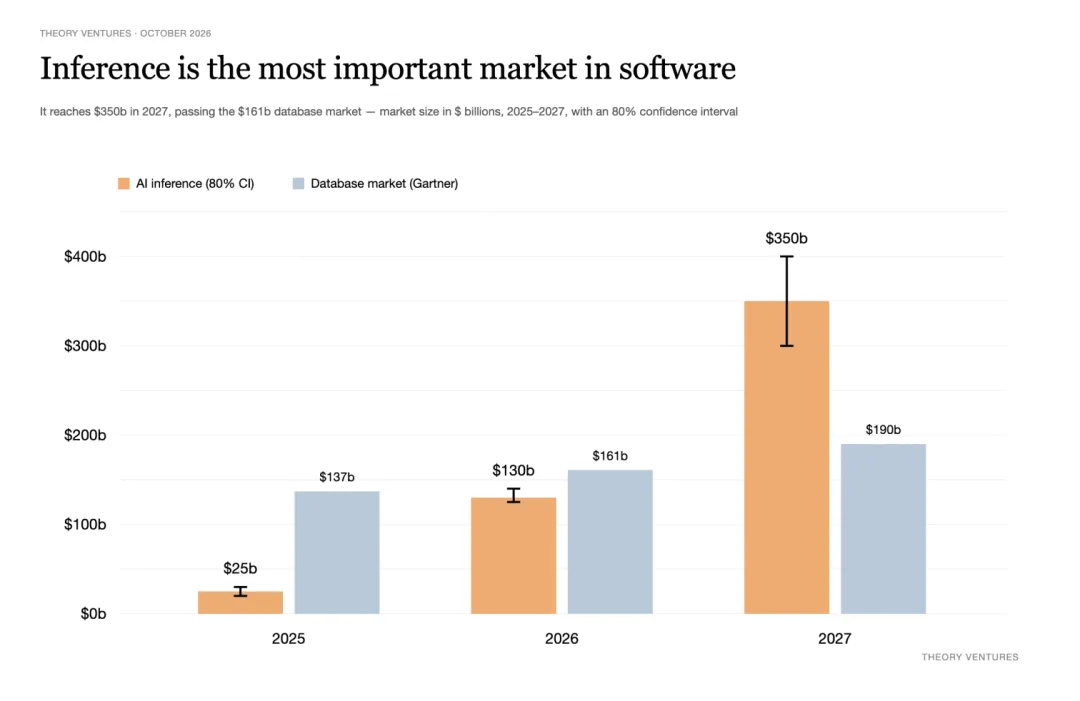
AI 推理就此成为软件业最重要的市场。每一款应用都在被改造成推理的分销商,软件厂商自己不做模型,买来推理能力嵌进产品里再卖出去,赚的是中间那层解法和服务。软件公司的单位经济要跟着重算,用量的钱盖过平台的钱,毛利率被压到传统软件的水平以下,基础设施变成成本里最重的那一项。 企业买 AI 应用,推理消耗的账单可能会超过席位许可费或者基础订阅费,增长能创下新纪录。按席位收费的年代,客户多招一个人就多付一份钱,账很好算。 现在改成按用量收费,客户签合同的时候不知道自己要用多少,销售也给不出一个稳的数字。提成方案得重做,怕预算失控的客户会要求可预测的套餐,财务的预测模型也跟着变复杂。 毛利率同样要往下走。经典软件的混合毛利率是 72%,这个数字会衰减,除非应用自己做出专有的 harness 把 token 开销压下去,或者模型竞争把推理成本压得比供给紧张抬价更快。获客成本和回本周期,都要重算。 客户自带模型密钥(BYOK)是另一种情况。企业自己提供 GPU 集群或者模型 API 凭证,软件厂商拿到的是几乎纯粹的软件毛利,但合同总额小得多。用收入换毛利,两头的账都得改。 基础设施在成本里突然占了大头,有可能吃掉一半以上的收入。像长途卡车司机看着柴油涨到每加仑 8 美元以上,软件公司盯着每 token 的价格,也只能在自己的车上找效率,换小模型、改 harness、换调度方式。 软件本来就不算厚利的生意。如果按研发即销货成本的口径重算,公开软件公司的平均毛利率会从 72% 掉到 47%。软件不是刻在光盘上卖一次的东西,研发和维护是持续发生的。会计口径自己也变过,2017 年收入确认准则从 ASC 605 换到 ASC 606,有的公司一夜之间利润变好看,有的变差。 自由现金流的账也不宽裕。这个指标量的是收入穿过所有成本之后,年底还剩多少留在账上。New Constructs 的统计里,过去 20 年软件公司的自由现金流收益率排在各行业第一,大约 3%;2009 年 12 月到 2016 年 3 月那段,科技公司平均接近 5%。 在这样的底子上再压一层推理成本,应用层能腾挪的空间就不多了。Harness 是包在模型外面的那整套系统,它决定了一次回答要花多少钱。 伯克利的一项研究测过这件事。21 组模型和 harness 的配对,每组 30 个任务各跑 3 次,按 2026 年 9 月 1 日的固定价目表计价。同一个模型、同样的结果,在 Pi 上跑比在 Claude Code 上跑便宜 71%,每个解出的任务从 1.540 美元降到 0.441 美元。42 组同模型 harness 对比中,质量差异没有一组达到统计显著。 Harness 要做的是把常见流程固化成确定性代码,把便宜模型能扛的任务路由出去,只在真正需要判断的环节调用最好的模型。压缩来自重复,而重复来自对同一类工作看得足够多。AI 几乎能替人干任何活,但让每个人都拿最好的模型去干每一件活,成本上不成立。 Theory 花 25 万美元一年买一个 AI 助理,去评估 5000 家公司,两家创业公司来竞标。Inferno 每一步都调最好的模型,推理烧掉 13.1 万美元。Inferefficient 把大部分工作合并成确定性代码,只在少数几步上用贵模型,推理花 3.7 万美元。 两家在托管、评估和人工复核上的开支一样,合同收入一样,毛利率一个 38%,一个 75%。Inferno 抄不了 Inferefficient。把任务路由到便宜模型,前提是知道哪些任务它扛得住,这个判断来自看过一万次同样的活。成本优势和护城河是同一份资产。 后面的账更难受。评估量过了 8600 次,Inferno 每多接一单就亏钱,只好限制用量。客户觉得它最有用的时候,它反而是更差的那个产品。Inferefficient 反过来,什么任务都接。 毛利买来增长的余地。25 万美元的合同花 15 万美元拿下,Inferno 要等 19 个月才能回本,Inferefficient 只要 10 个月,招人的速度是它的两倍。两家的毛利率对假设也很敏感,任务量按 10 个等值算是 59% 对 81%,按 30 个算,Inferno 已经亏了,Inferefficient 还有 64%。 毛利不会涨到 100%。推理越便宜,买家对 agent 的要求就越多,均衡会跟着竞争一起移动。留下来的是这两家公司之间的差距,那正是 harness 的价钱。伯克利那项研究的样本量也不大,只能看出 15 个点以上的差异,质量差距既没被证明存在,也没被证明不存在。 Epoch AI 测算,2023 年以来,达到同一个性能水平的成本大约每季度降 47%,一年约 13 倍。这个速度是 DNA 测序降速的 4 倍,比算力快 6 倍;拿锂电池比是 18 倍,拿美国居民电价 1892 到 1973 年那八十年比是 54 倍。开放权重的模型按租用硬件的成本计价,和 API 报价的差距在 30% 以内。 时间零点定在 2021 年 11 月 18 日,那天 OpenAI 把 GPT-3 的 API 全面开放商用。a16z 在 2024 年也算过一笔,GPT-3 发布之后的三年里 LLM 成本降了 1000 倍,相当于每年 10 倍。OpenAI o3 在 2025 年 1 月底拿到 75 分(GPQA Diamond),平均每题花 30 美分;不到 18 个月后,GPT-5.6 Luna 拿到同样的分,每题 0.0004 美元,一辆标价 5 万美元的新车降到了 69 美元。 更早的数字也在这条线上。GPT-3 在 2021 年 11 月发布时 MMLU 拿 43.9 分,每百万 token 收费 60 美元;2023 年 7 月,开放权重的 Meta Llama 2-7B 拿到 45.3 分,价格 0.20 美元。折算下来,价格大约每年降 31 倍。 价格战能把这些变化都挡回去吗?按能力调整后的 token 成本每季度降约 47%,但前沿旗舰的标价一直在往上重置。18 个月里,前沿混合价格从 0.96 美元涨到 11.25 美元,GPT-6 Sol 又把这一档重置到 4.00 美元。 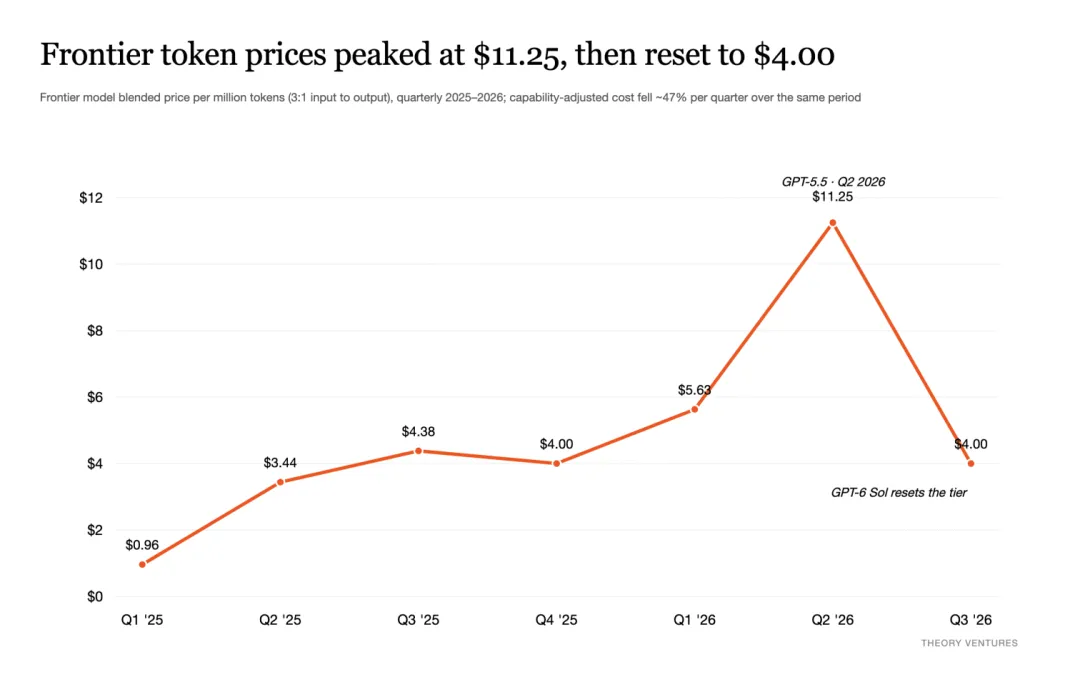
降价本身也不均匀。某个性能水平刚被实现的时候成本降得最快,五大基准平均每季度降 66%,两年后放缓到 32%。分领域看,游戏类谜题每季度降 39% 到 43%,数学问题能到 50% 到 52%。三年数据可能偏短,基准也未必能代表真实工作,这些测算自己留了余地。 便宜的模型不等于便宜的生意。省钱的本事长在 harness 里。它要做的无非是把客户理解透,攒一批贴身的评估集,再把调优过程自动化。
传统数据库让位
Token用量超过席位
Harness 决定谁活得下去
模型在降价,生意没有变便宜