ARTICLE · 1181425
限时免费!你的AI科研助手「星河启智·科学宇宙」上线!
被查文献、调代码榨干灵感?
做科研的时间不该耗在 “体力活” 上
复旦大学与上海科学智能研究院
联合打造的星河启智科学智能开放平台
正式上线「科学宇宙」功能
让AI接手繁琐工序
把脑洞留给真正的科学问题
让我们一起看看吧~
如果科研有"最耗时间的环节",会是什么?
文献浩如烟海,关键信息总藏在检索词背后;既怕遗漏重要进展,又担心写的综述没有新意;科研流程繁琐,总在重复劳动中消耗灵感。
这或许是很多科研人每天都在面对的日常。真正拖慢你的,往往不是科学问题本身,而是被海量检索、整理、写作、调试占据的"工程性"时间。
现在,你有了新选择。
「科学宇宙」正式上线:问对问题,AI 解出答案
近日,复旦大学与上海科学智能研究院联合打造的星河启智科学智能开放平台(NovaInspire: Scientist-Centered AI Open Platform)正式上线「科学宇宙」功能。深度结合智能体技术,可丝滑融入日常科研工作流,让文献调研与报告撰写变得前所未有的高效、可控、可交互。
目标只有一个:问对问题,AI 解出答案。
访问链接:https://aistudio.ai4s.com.cn/partner/scientific/home
它是什么?——面向 AI for Science 的一站式智能科研助手
「科学宇宙」是一款面向 AI for Science 场景的一站式智能科研助手。它以通用大模型能力为基础,叠加面向科学计算的专用多模态模型与一系列垂直科研工具,把科研全流程中的关键环节——从研究选题、文献与数据调研,到数据加工、建模与代码开发,再到成果展示传播——整合为可调用、可协作的智能能力。
与通用对话助手不同,科学宇宙的价值在于:把科研这条长链条上的重复性、工程性工作系统化地承接下来,让科研人员把精力聚焦在科学问题本身。
首创 Scientist-in-the-Loop:把 Deep Research 做成"白盒"
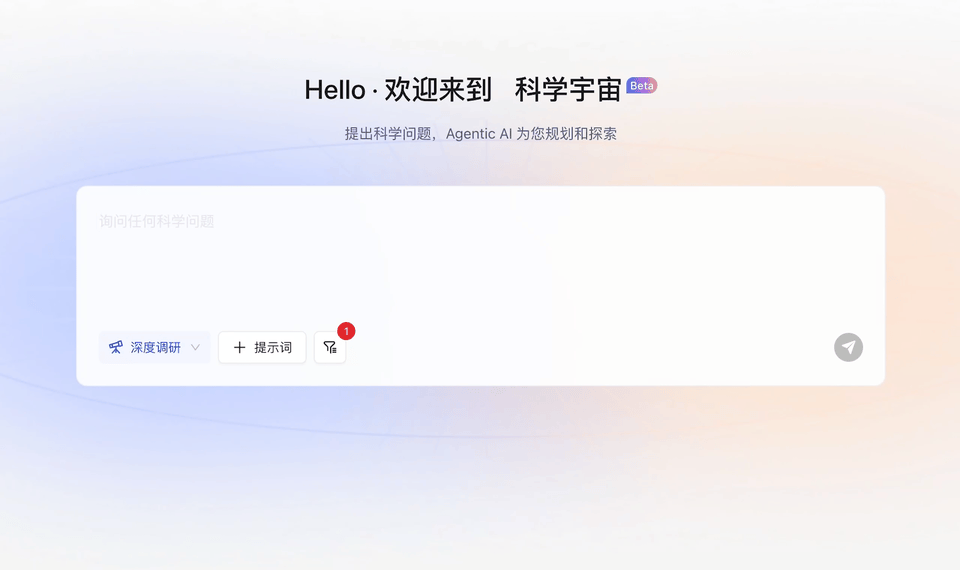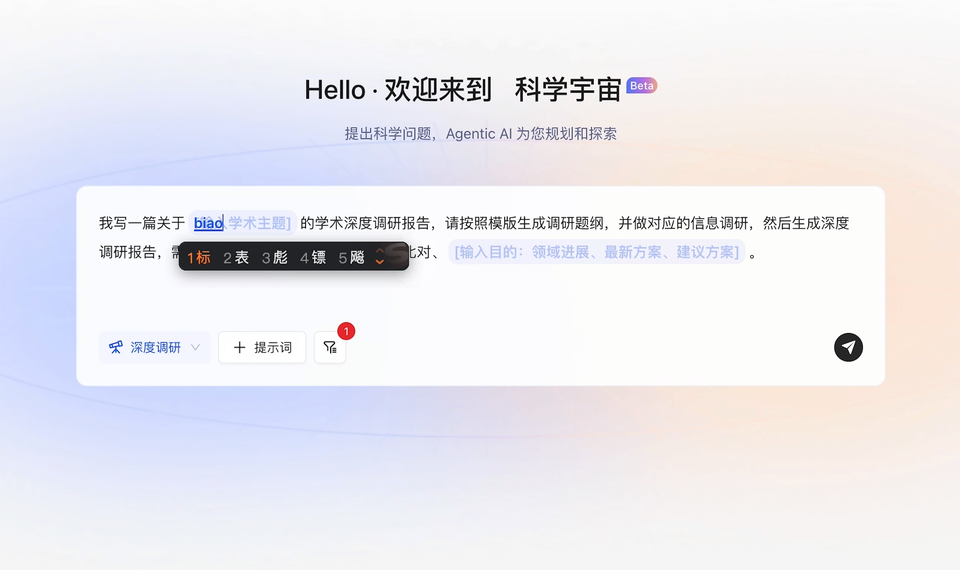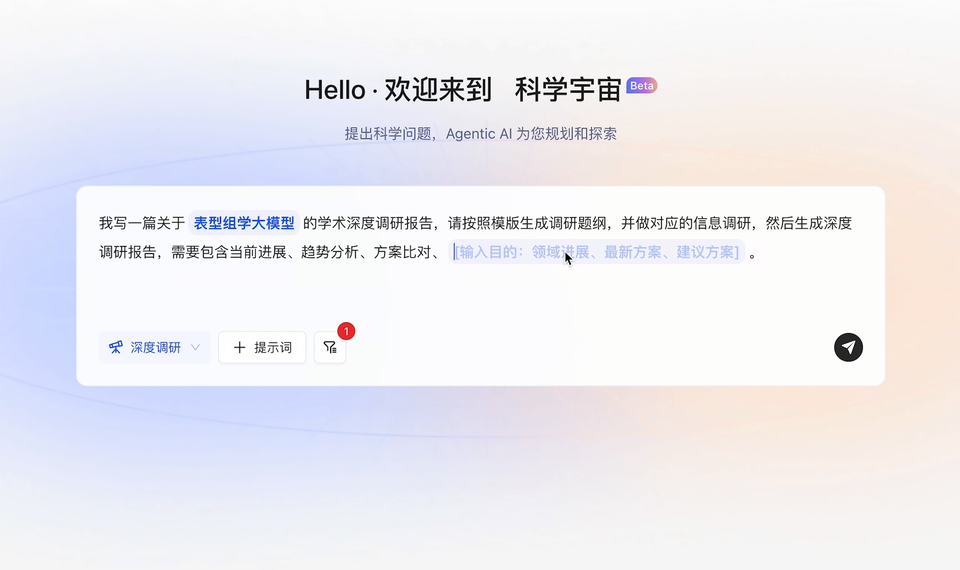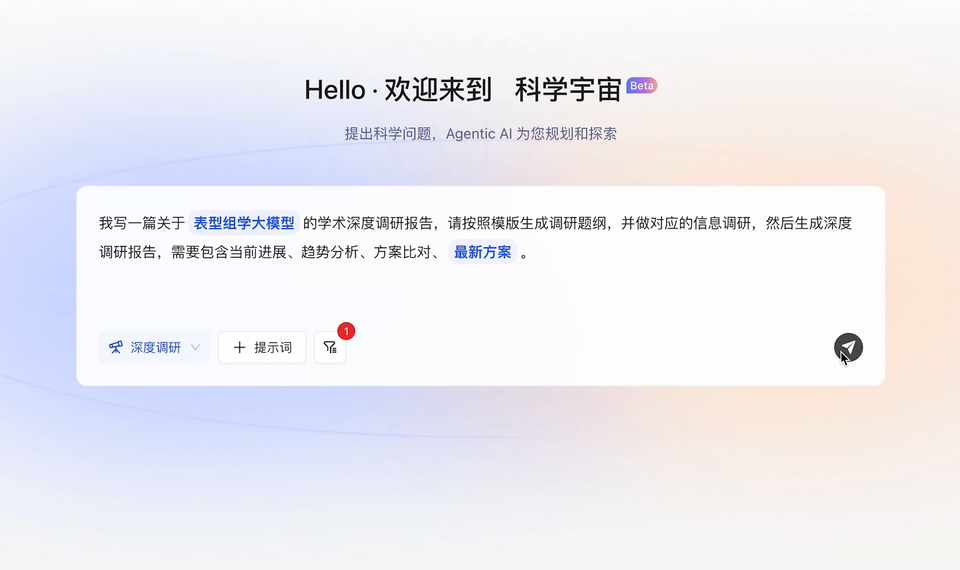
「科学宇宙」依托全球顶尖开放学术数据库,首创 Scientist-in-the-Loop 模式,实现人机协同的深度科研交互。
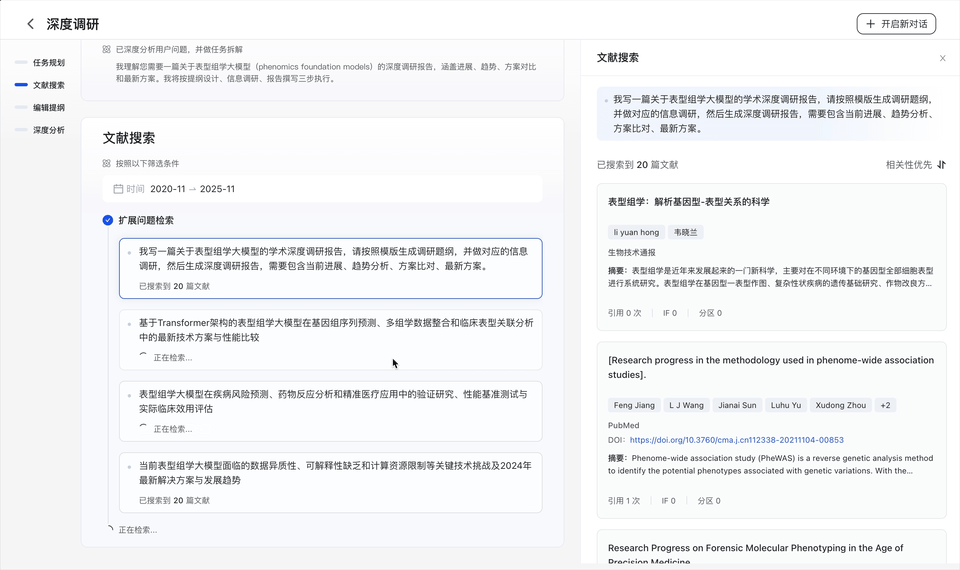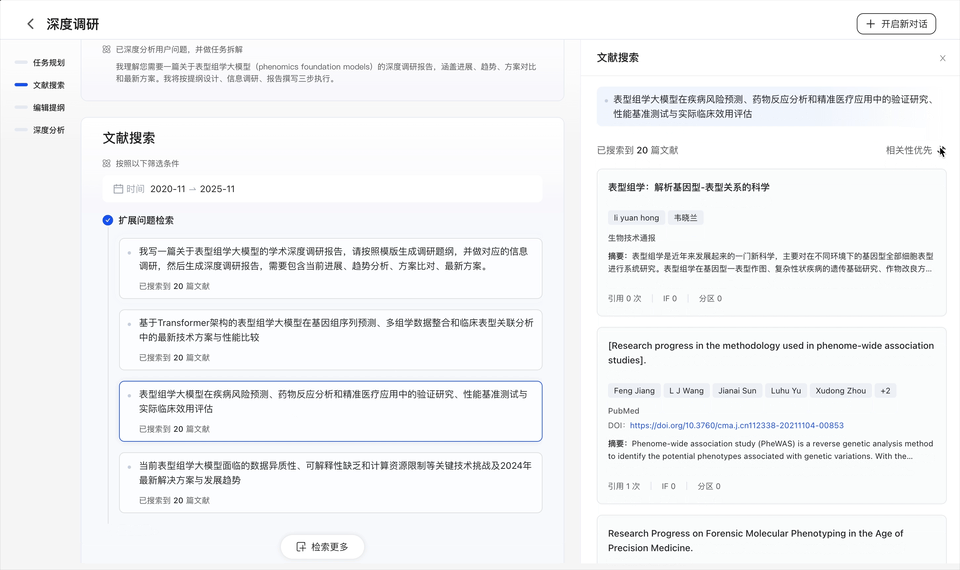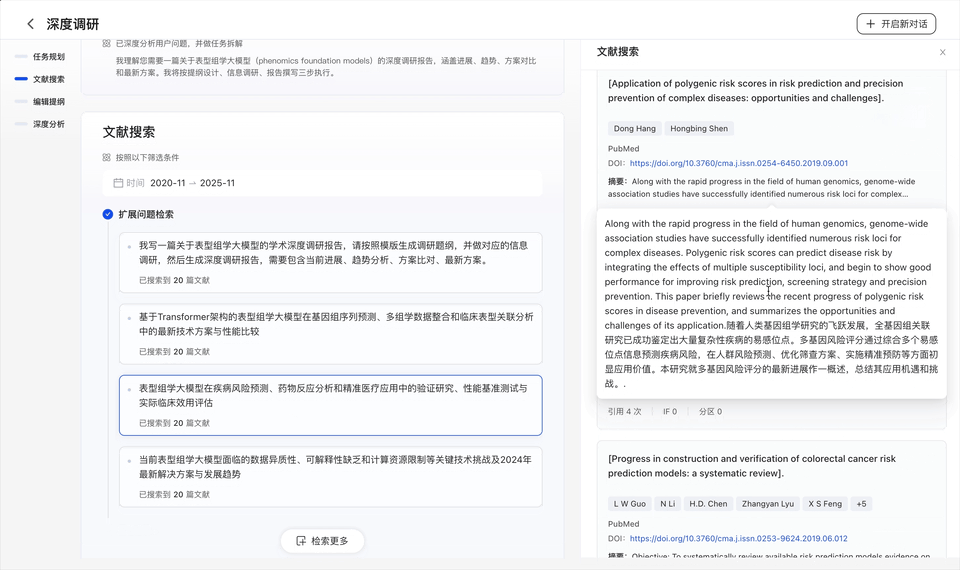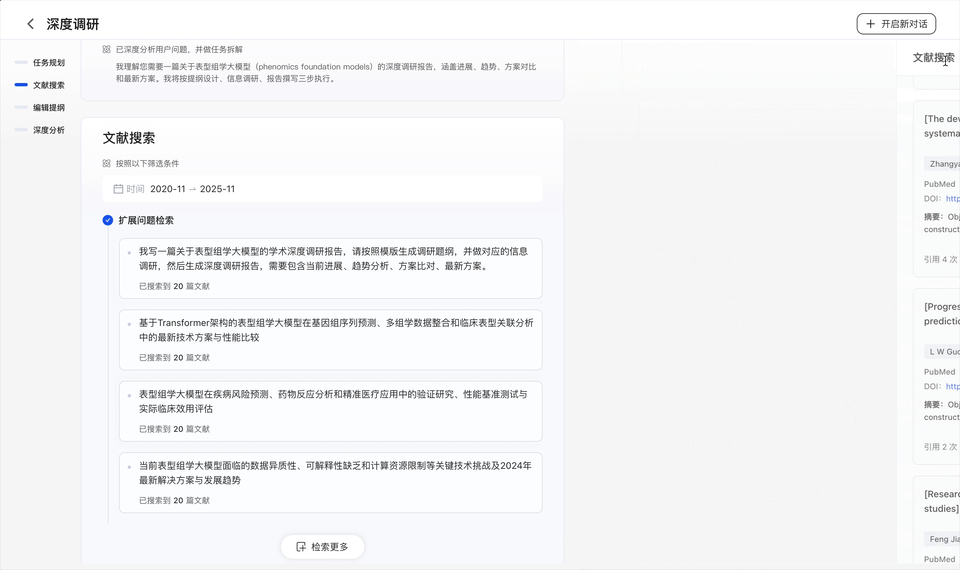
在这一模式下,使用者可实时介入 AI 的检索逻辑,动态调整搜索路径,并基于实际科学需求进行多轮文档生成、灵活适配个性化研究需求,告别"黑箱"操作,实现 Deep Research 的"白盒化"体验。
结合星河启智平台上具备智能化科学推理、动态决策规划及实验闭环能力的智能体(Agentic AI),可帮助使用者更快抵达高价值前沿科学问题的本质、挖掘未知的答案。
现有的 Deep Research 工具依然存在两大痛点:走不完"最后一公里"、缺乏真正的用户参与。秉持"以科学家为中心(Scientist-Centered)"的理念,「科学宇宙」不仅可以精准检索文献,更能生成高质量总结,帮助使用者从重复文书工作中解放出来。
更重要的是,整个过程打破"黑箱"模式,将关键词扩展、文献筛选、内容方向等中间过程透明化,使用者可不断介入、"干预"检索逻辑,让 AI 的输出更贴合专业判断与研究意图。
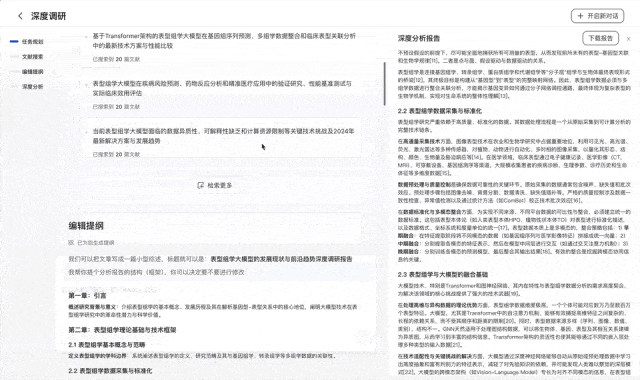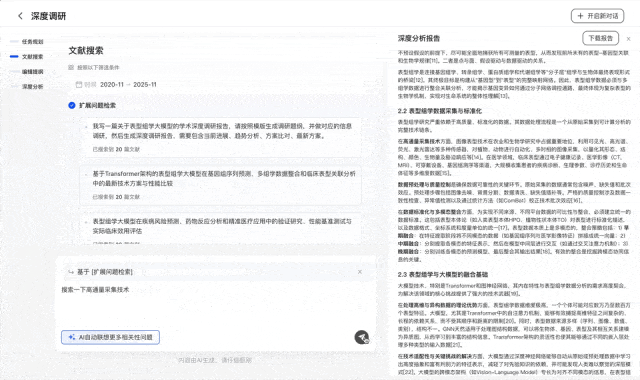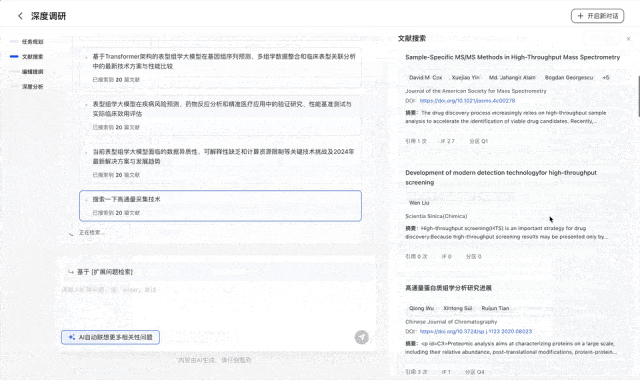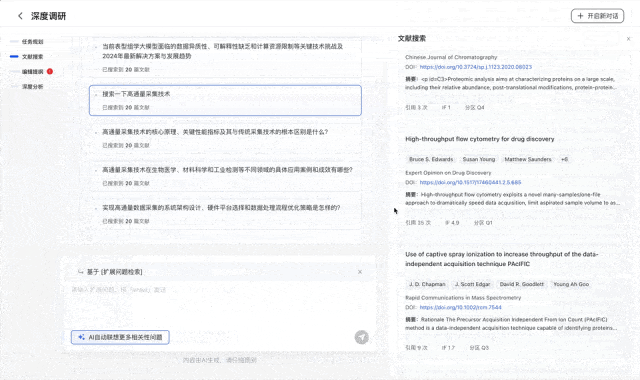
四大能力模块,覆盖科研全生命周期
科学宇宙的能力按科研生命周期划分,覆盖四个阶段——
一、研究构思:从"模糊想法"到"可执行计划"
科研头脑风暴(Research Brainstorming):面向早期选题与立项场景,帮助用户梳理研究意图,评估选题的可行性、新颖性与研究价值,辅助完成研究方案设计、实验规划与方法学探索,在正式投入前充分论证研究方向。适合从「有一个模糊想法」到「形成可执行的研究计划」这一阶段。
二、文献与数据调研:找全、读懂、写好
学术论文深度检索(Paper Deep Search):支持多轮迭代式的学术文献检索与系统性文献调研,可按主题、关键词持续收窄和扩展,高效发现并收集相关论文。
文献综述撰写(Literature Review):基于已收集的论文元数据与全文,自动构建引用标签、批量阅读并撰写结构化综述,输出带规范引用的 Markdown 文档,服务研究背景梳理与相关工作整理。
数据集深度检索(Dataset Deep Search):面向科学数据的多轮迭代检索,帮助发现与研究方向匹配的数据集,为后续建模和实验提供数据基础。
三、数据加工与建模开发:把脏活累活接过来
数据处理与清洗(Data Processing):覆盖数据集探查、需求确认、加工规划,到代码生成执行、自主调试与质量验证的完整闭环。坚持「原始数据只读、需求锁定前置」原则,保障规范性与可复现性。
基线代码创建(Baseline Code Creation):自动创建、调试并验证 AI for Science 项目的基线代码,支持机器学习代码的自动编写与调试,快速搭建可运行的起点,适用于数据科学竞赛解决方案与科研基线搭建。
AI 代码自动优化(Code Auto-Optimization):基于 LangGraph 工作流的自动化代码优化能力,支持迭代调试、基线对比与 Git 集成,用于 bug 自动修复、模型性能提升和代码重构等场景。
科学多模态模型「神珍」(MKB):内置的统一科学多模态模型,覆盖蛋白质、RNA、DNA、分子与科学文本的理解与生成任务。典型能力包括 ncRNA 家族分类、蛋白质溶解度/稳定性/EC 号预测、启动子序列判断、增强子活性预测、分子致突变性与偶极矩评估、toehold-switch RNA 设计,以及根据文本描述生成分子 SMILES 等。
四、成果展示与传播:让好工作被看见
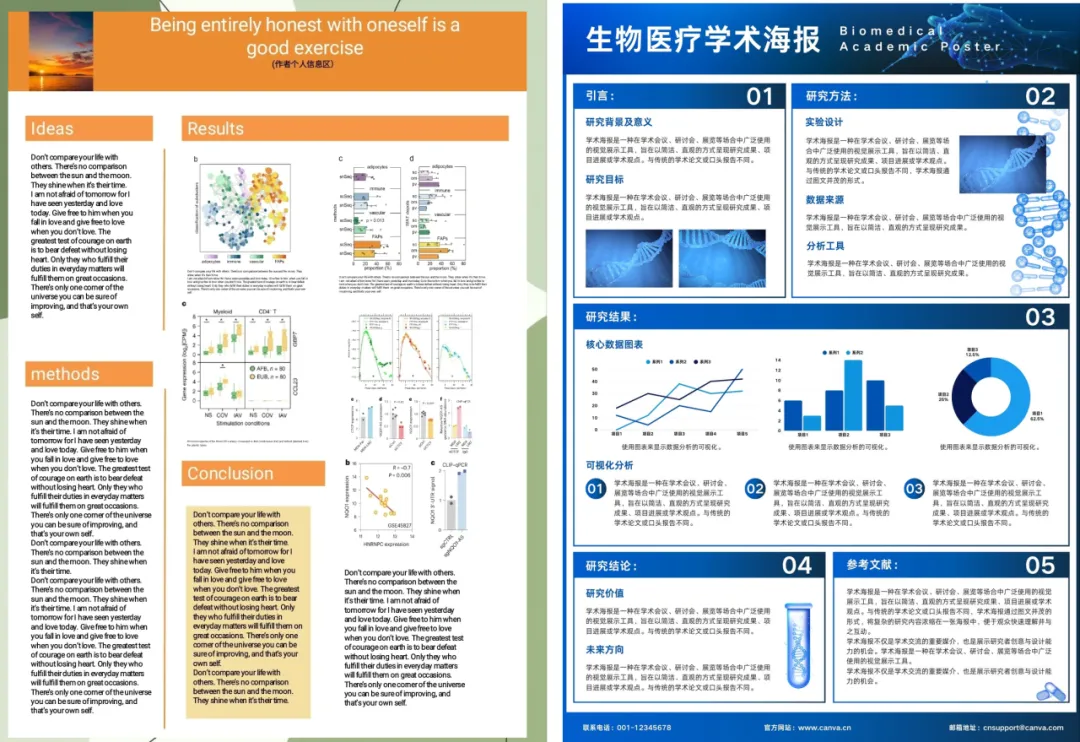
学术海报生成(LaTeX Posters):基于 LaTeX(beamerposter / tikzposter / baposter)生成专业科研海报,支持多栏布局、配色方案与图表集成,服务会议展示与学术交流。
智能 PPT 生成(PPT Generation):根据主题、行业与风格自动生成演示文稿,支持中英文双语、自定义模板与智能配色,覆盖商务、教育、科技、医疗、金融、创意等多类场景,用于课题汇报与成果宣讲。
不止于此:三个值得关注的能力
一、AI4S 热点资讯:不错过领域的每一次脉动
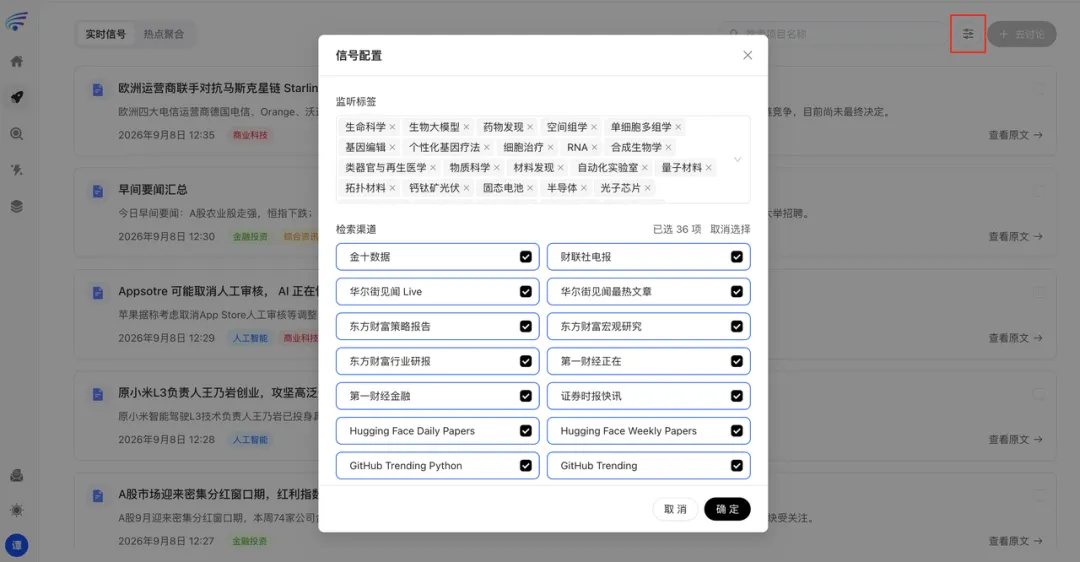
实时信号:面向科研人员的实时资讯监控与个性化订阅工具。自由勾选关注的科研领域标签(生命科学、材料发现、半导体、合成生物学等)和信息来源渠道(金十数据、华尔街见闻、财联社、Hugging Face Papers、GitHub Trending 等),系统据此实时过滤并推送与研究方向相关的科技、产业与学术动态,每条资讯含标题、摘要、时间与原文链接。
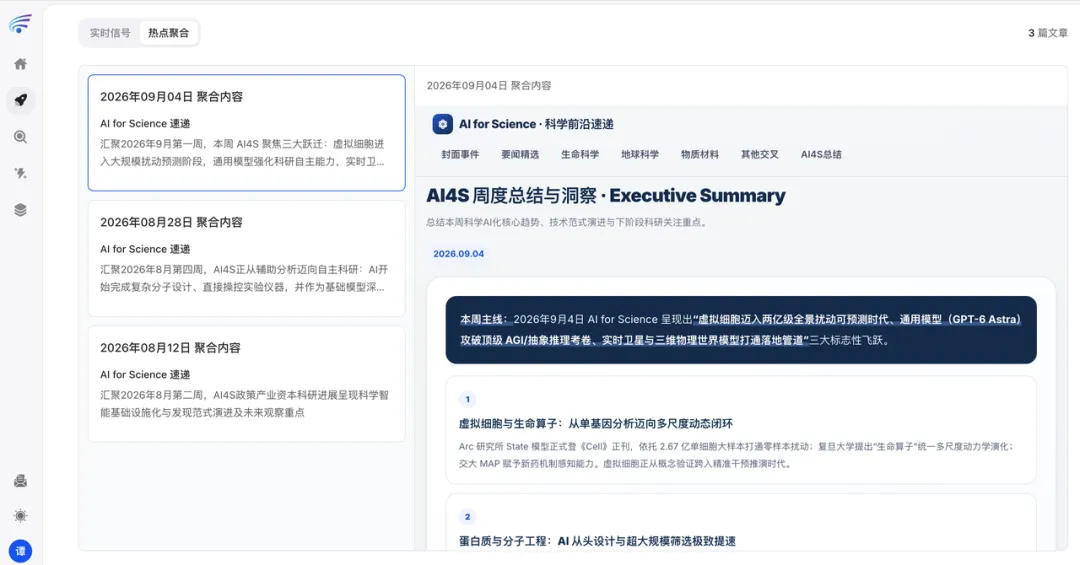
热点聚合:周期性的 AI for Science 趋势总结与洞察模块。系统按周将关键进展结构化归纳为一篇「科学前沿速递」,按封面事件、要闻精选、生命科学、地球科学、物质材料、其他交叉、AI4S 总结等栏目组织,帮助用户从零散资讯中把握宏观趋势与方向判断。
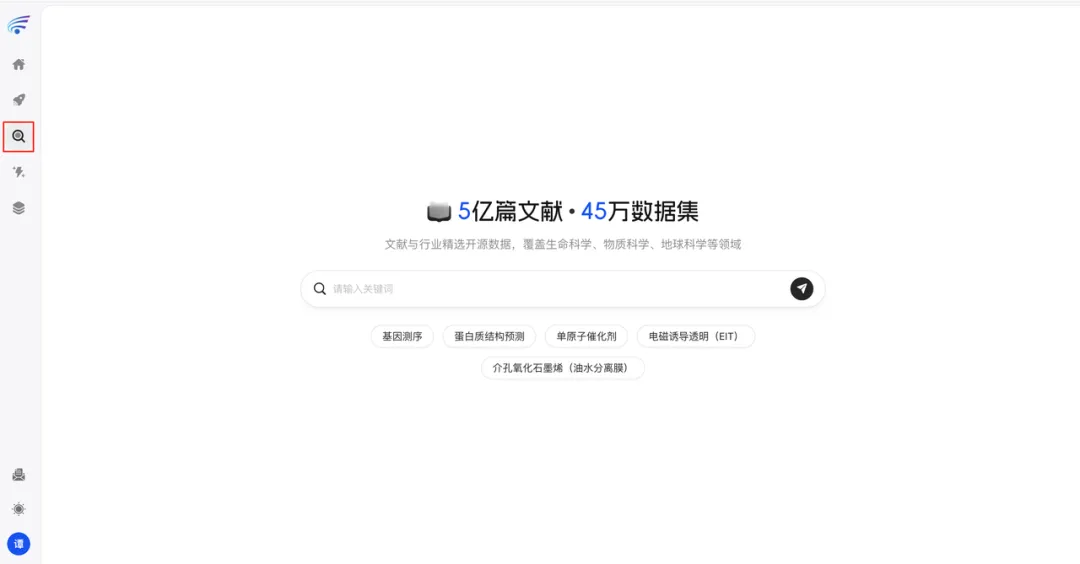
二、文献/数据检索:5 亿篇文献、45 万数据集
平台覆盖 5 亿篇文献、45 万数据集,覆盖生命科学、物质科学、地球科学等领域。检索结果页支持「论文」「数据集」「领域图谱」三个标签切换;论文列表展示标题、作者、期刊、摘要及发布时间、被引用数、影响因子(IF)与分区等元数据,可多选后导入已创建的工作项目。
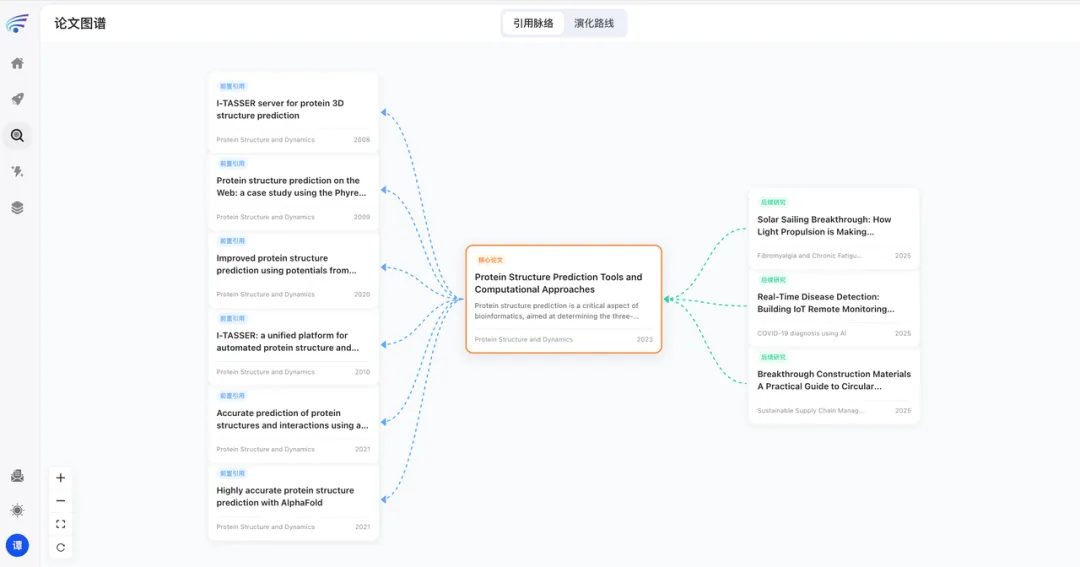
点击论文下方「引用脉络」,可借助节点链接图可视化论文间的引用关系:左侧「前置引用」以蓝色虚线箭头标注核心论文所引文献,右侧「后续研究」以绿色虚线箭头标注引用核心论文的文献,每个节点显示标题、所属领域与发表年份。
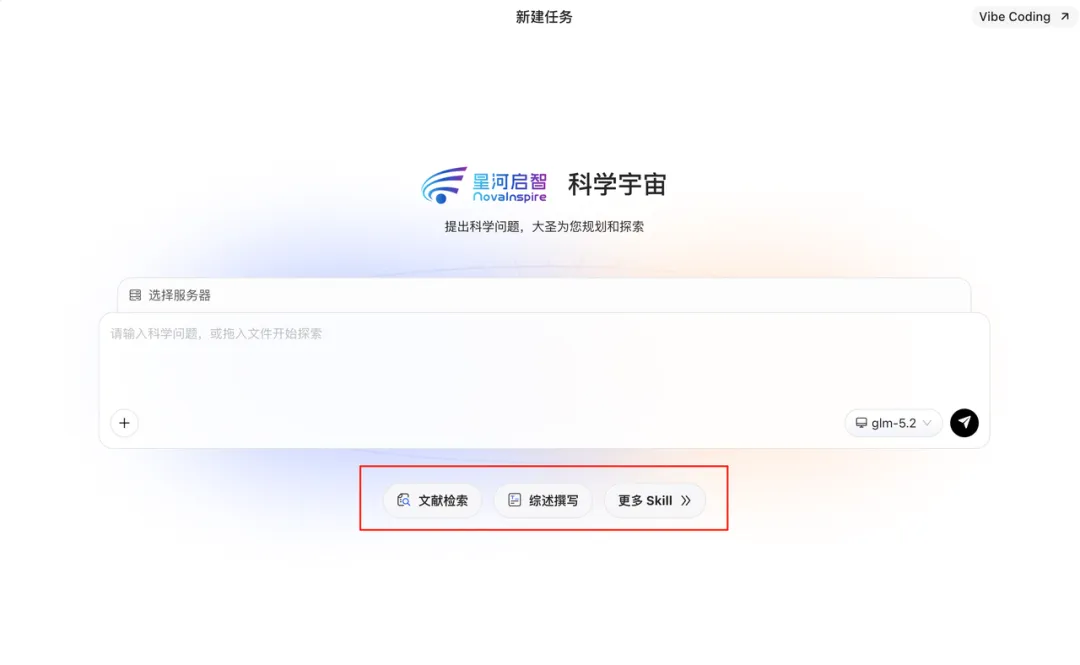
三、Skill 中心:把科研技能武装进对话
通过科学宇宙首页或侧边栏进入技能库管理页面,集中展示所有可按需启用的科研技能(Skill),可按名称检索;每个技能卡片展示名称、功能描述、点赞与使用数据,并配有开关控件一键启用或禁用。
写在最后:把时间还给科学本身
在 AI for Science 时代,好的工具不是替代科研人员,而是把那些重复、繁琐、机械的环节接走,让人把精力留给真正重要的科学问题。「科学宇宙」想做的,正是这样一件事——问对问题,AI 解出答案。
欢迎前往体验:https://aistudio.ai4s.com.cn/partner/scientific/home
如有合作意向或需要进一步支持
可联系support@ai4s.com.cn
· The End ·
来源 ❐ 复旦校友服务平台
编辑 ❐ 彭静
👍
猜你喜欢