ARTICLE · 1193764
AI Agent正在改变软件开发的第一步
REA火了:AI开始“读懂”软件
REA 是一个面向 AI Agent 的逆向工程工具层:它把反编译、调用链追踪、应用观察等能力接入 Codex、Claude Code 等工具,让 AI 不只会写代码,还能围绕一个软件功能收集证据、解释逻辑并辅助独立实现。它改变的,不只是逆向工程,更是软件开发的起点。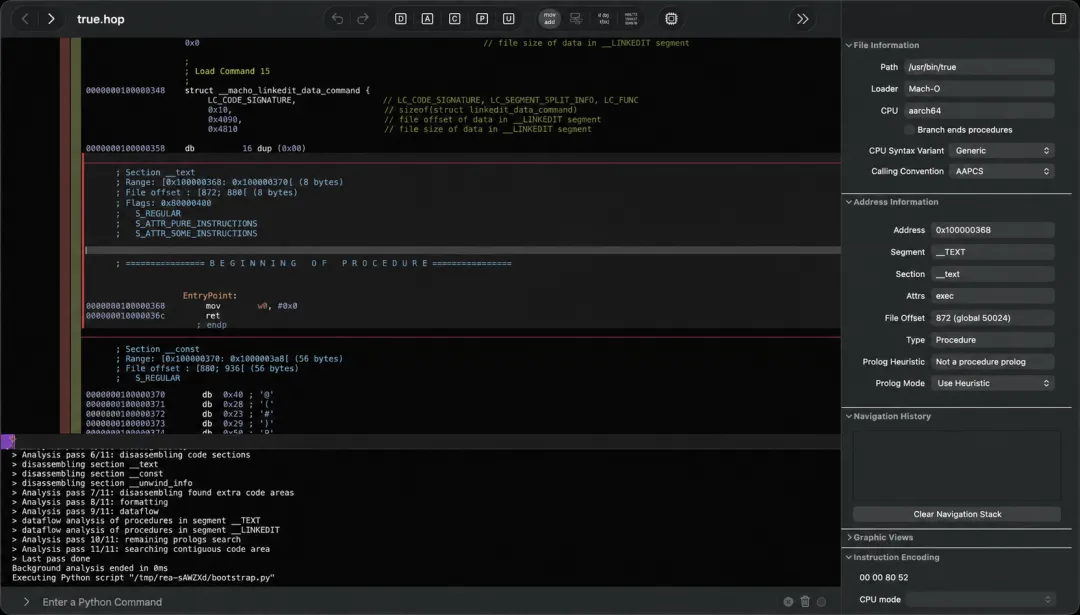
没有源码,AI如何看懂一个软件?
开发者都有过这样的时刻。
看到一个 App 的搜索功能特别顺手,想弄明白它为什么快;接手一套老系统,文档早没了,代码又不敢轻易改;或者发现竞品有个不错的交互,很想研究其中的设计逻辑。
过去,这意味着漫长的工作:开反编译器、找字符串、追调用链、看日志、猜模块关系。
现在,REA 把这条路径交给了 AI Agent。
它的名字是 Reverse Engineer Anything。但别急着把它理解成“一键破解”或“一键复制”。
REA 真正做的,是给 AI 装上一套专业的观察工具:让 AI 在授权范围内查看软件构成、追踪代码关系、标注证据与不确定性,最后再帮助开发者做出一份适合自己项目的独立实现。
它不是魔法。
但它确实让 AI 编程跨过了一道重要门槛:从“会写代码”,走向“会研究软件”。
What:REA到底是什么?
一句话解释:
REA 是一个通过 MCP 接入 AI 编程助手的逆向工程工具层。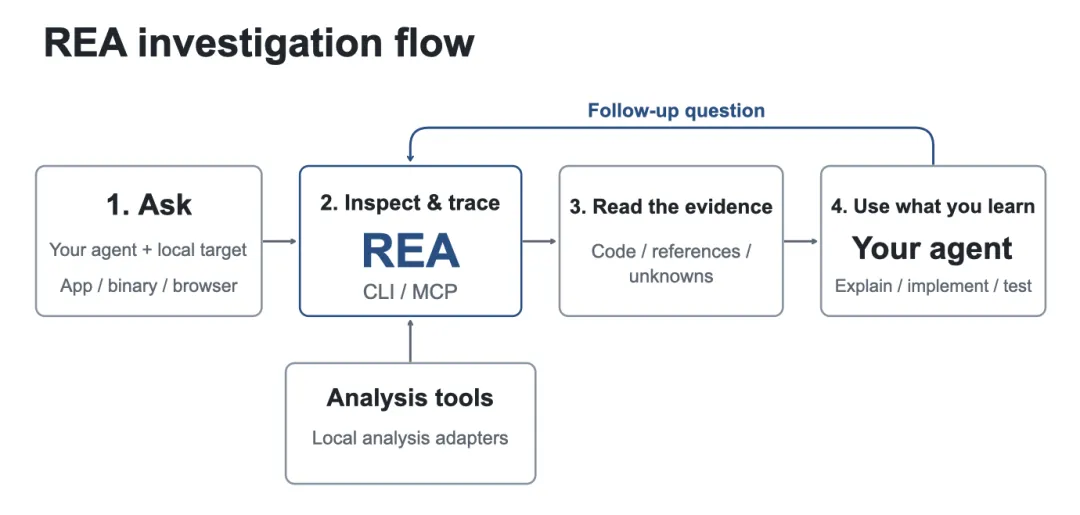
它不是新的反编译器,也不是一个聊天机器人。
它更像一个翻译官,把 Hopper、Ghidra、IDA 等专业分析工具的能力,变成 Codex、Claude Code、Cursor 等 Agent 可以调用的工具接口。
开发者问 AI:“这个功能如何实现?”
REA 不会直接给出一个想当然的答案,而是协助 Agent:
- 识别目标文件、模块与程序结构;
- 搜索相关字符串、函数、路由或调用关系;
- 查看伪代码、汇编、模块依赖或运行时观察;
- 返回结论所依据的证据;
- 将理解结果转化为新的、独立的工程实现。
REA 官方强调,它的目标不是恢复原始源代码,而是帮助理解已发布的软件行为,并让 Agent 据此完成分析、解释、测试和重建。REA 官方仓库
Who:谁真正需要REA?
 REA 并不是所有人都必须安装的工具。
它首先适合四类人。
第一类,是想研究成熟产品的开发者。
不是为了照抄,而是为了理解一个功能背后的实现路线:本地搜索、剪贴板交互、数据缓存、桌面端通信等。
第二类,是维护遗留系统的团队。
那些“能跑、却没人说得清”的旧程序,往往最需要先建立一份可靠的调查笔记,而不是贸然重构。
第三类,是做兼容性、迁移或软件保存的人。
当一个旧软件停更、源码遗失,理解其数据结构、调用方式和本地行为,可能是后续维护的前提。
第四类,是希望把 AI 用深一点的工程师。
过去让 AI 写代码,重点是提示词;未来让 AI 做复杂调查,重点是目标、授权范围、证据标准和验收条件。
Where:它能看哪些东西?
REA 的覆盖范围已经不只是传统的桌面二进制。
根据官方文档,它可以面向原生二进制、JavaScript 与 Electron 应用、.NET 程序集、网站、Android APK、SQLite 数据库、WASM 文件等多类目标工作。不同目标对应不同深度:例如静态 JavaScript/Electron 分析可梳理模块、路由、IPC 与依赖关系;原生程序的深度分析,则通常需要 Hopper、Ghidra 或 IDA 等引擎支持。REA README
但这里有一条非常重要的边界:
客户端能看到的,不等于整个产品都能看到。
真正的推荐算法、支付风控、用户数据库和后端业务规则,大多运行在服务器上。REA 能帮助理解本地软件和已授权的运行行为,但不能“看穿”服务端,更不能把伪代码变回原始工程。
Why:为什么它会影响软件开发?
因为软件开发的起点正在变化。
过去,开发通常从一张需求文档开始:
“做一个搜索功能。”
“做一个桌面客户端。”
“做一个类似某产品的交互。”
未来,开发者还可以从一份“证据化理解”开始:
“这个已授权软件的离线搜索有哪些步骤?”
“它的模块边界和数据流是什么?”
“哪些结论已经被证据证实,哪些只是推测?”
“我的产品应该借鉴原则,还是采用另一种方案?”
这意味着,AI Agent 不再只负责代码生成。
它开始参与软件工程里更靠前的一步:理解问题。
代码会越来越容易生成,但“到底应该生成什么”,依然需要人来判断。
When:什么时候值得用REA?
不是看到任何软件都去分析。
更合适的时机包括:
- 你拥有或获授权维护某个应用;
- 你在研究开源项目、历史软件或自家旧系统;
- 你需要验证某项功能真实存在的实现路径;
- 你要做兼容、迁移、复现测试或独立重构;
- 你不满足于 AI “猜一个方案”,而希望它给出依据。
最不适合的时机,则是把它当作商业复制或绕过保护的捷径。
工具越强,边界越不能模糊。
How:普通开发者怎样开始?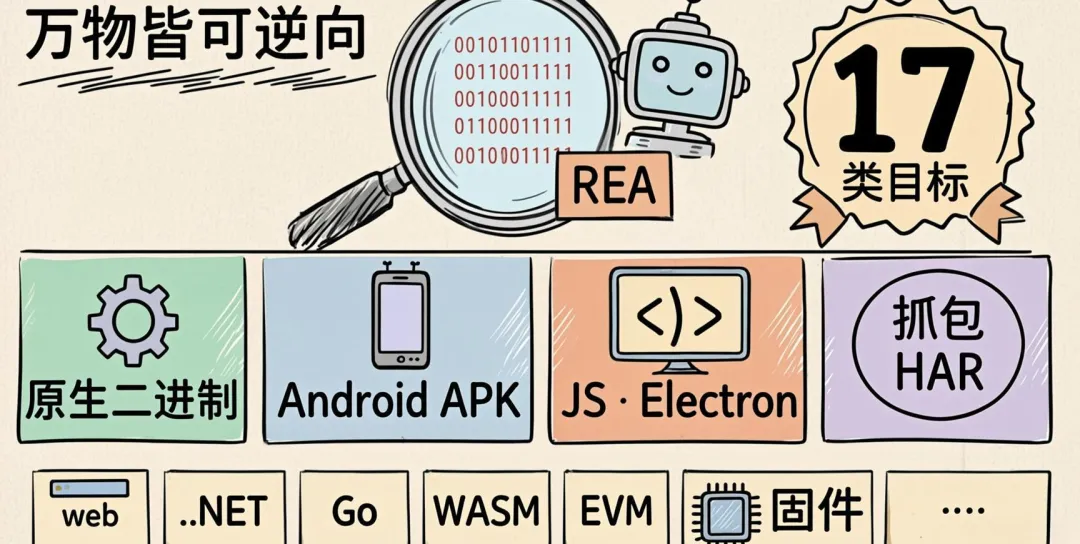
REA 的最小上手路径并不复杂。
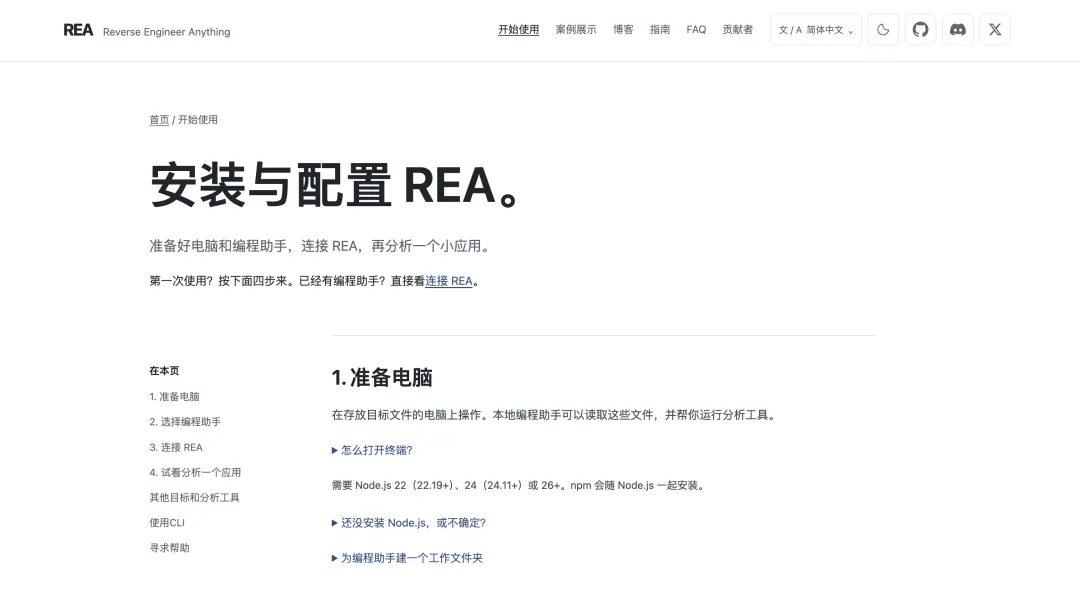
第一步,准备环境。
官方要求 Node.js 与 npm;当前文档列出了 Node.js 22.19、24.11 或更高版本的要求。官方安装说明
第二步,注册到你的 Agent。
npx rea-agents setup
该过程会提示你选择要接入的 Agent,并让你确认配置变更。官方说明它会为已有配置创建备份;完成后,需要重启对应的 AI 编程工具。
第三步,从低风险目标开始。
建议先选择自己的 Electron 项目、开源软件,或明确取得授权的应用,不要一开始就碰复杂二进制文件。
第四步,把问题问具体。
不要只说:“帮我逆向这个软件。”
可以这样说:
在已授权范围内,分析这个桌面应用的本地搜索流程。请列出相关模块、调用关系、证据来源和不确定项;最后为我的 TypeScript 项目提出一份独立实现方案,并补充测试建议。
好问题,会让 AI 的调查路径更清楚,也会让结果更可核验。
REA带来的未来,不是“复制软件”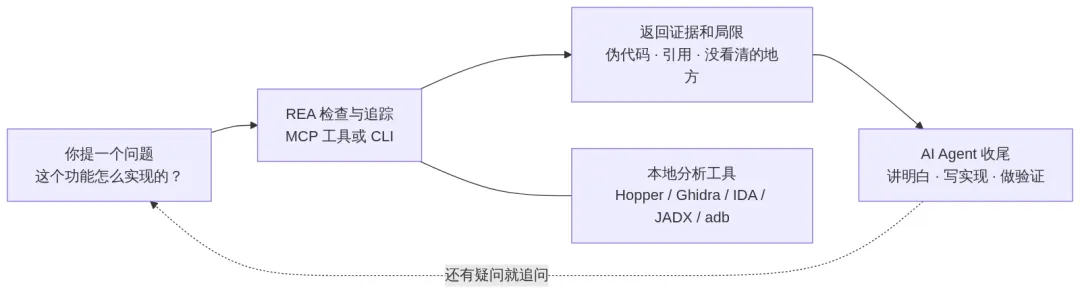
REA 的价值,不是让开发者更轻松地模仿别人。
它真正代表的是一种新的 Agent 工作方式:
人提出目标,AI 调用工具,工具返回证据,人再做判断。
未来的软件开发,可能会越来越像这样:
过去是“需求—写代码—测试”;
现在是“观察—理解—设计—实现—验证”。
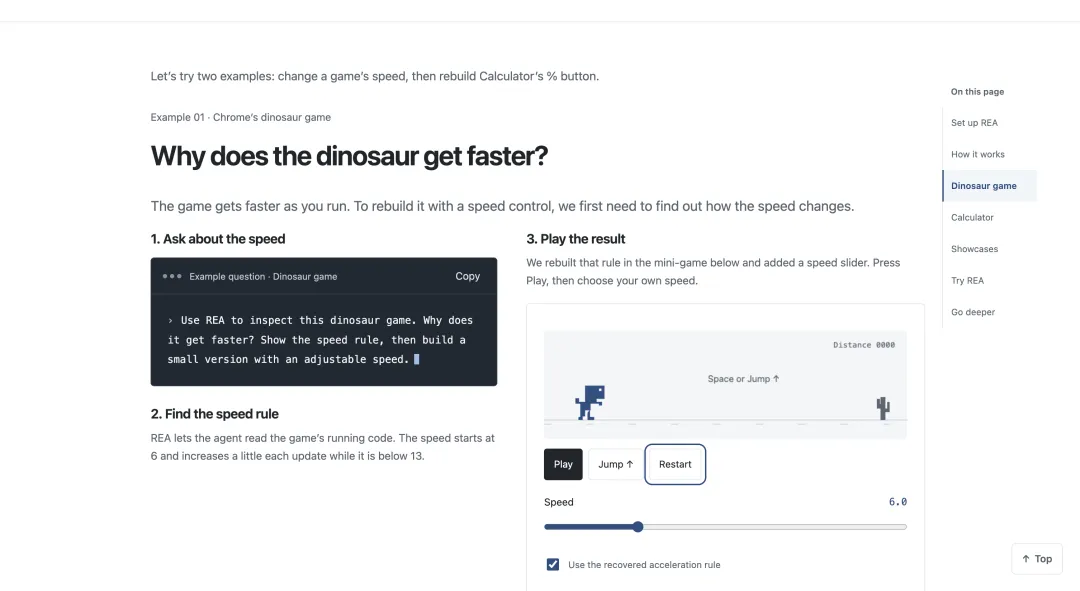
开发者的核心价值,也会从“记住多少 API”,逐渐转向三件事:
- 能否提出正确的问题;
- 能否判断证据是否可靠;
- 能否把观察到的规律,变成真正有价值的产品。
AI 会越来越会写。
但真正稀缺的,仍然是理解复杂系统、定义正确问题、承担最终决策的人。
REA 让 AI 多了一双眼睛,但方向盘依然在开发者手里。
你觉得,AI Agent 下一步最应该接入哪一种专业工具?欢迎留言聊聊。