ARTICLE · 1199871
二维表给人看,一维表给机器算:Excel底表规范化的关键一步
二维表给人看,一维表给机器算:Excel底表规范化的关键一步二十张校区报名表刚用 Power Query 合到一起,玲宝宝还没来得及松口气,宏财那边发来的集团招生汇总表又把她难住了。 她想顺手算一件最普通的事:华东区一共招了多少人,三季度比二季度涨了多少。可把字段拖进透视表,她愣住了——宏财发来的这张表,第一列是校区,后面横着排着“1月、2月……12月”十二列,每个格子里是一个数字。 没有“月份”这一列,也没有“人数”这一列。她想按月汇总,月份却躺在表头里;想筛选华东,校区又和大区是两回事。上周刚学的 SUMIFS,此刻竟然一个都用不上。 玲宝宝没有去硬凑公式。她盯着这张表看了一会儿,慢慢意识到:这回卡她的不是哪个函数,而是表本身的形状。 她决定先停下来,把“一张表到底该长什么样”这件事弄清楚。 她在纸上画了两张小表,一下子看出了分别。 这是宏财发来的那张表(二维表 / 交叉表): 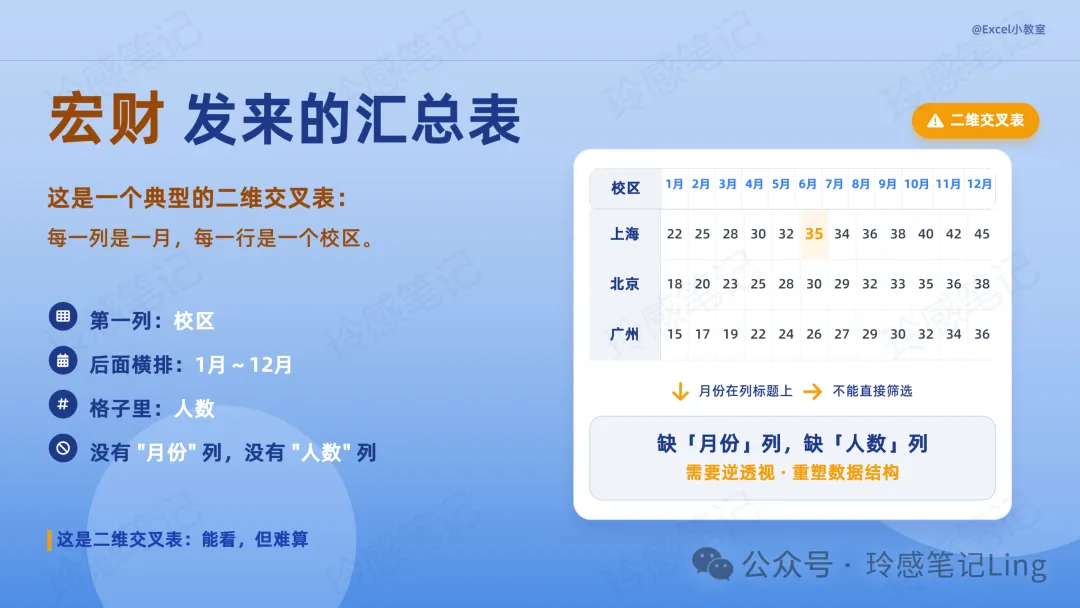
行是一类分类(校区),列又是另一类分类(月份),格子里塞着数值。它紧凑、好看,人一眼就能扫到“上海3月135”。 这是函数和透视表真正爱吃的表(一维表 / 流水表): 
每一列只代表一个独立的字段,每一行只记一条完整的记录。 区别的本质,玲宝宝用一句话概括: 二维表本身没有错——年终汇报里就该是这样。错的是把二维表当成了录入和统计的底表。原料一旦是交叉形状,后面所有的筛选、求和、透视都得绕着它走,这正是她现在卡住的根源。 
把这个判断带回工作,玲宝宝发现身边的表常常病得更具体。她记下两类最典型的。 结构病一:一个格子里塞了好几件事 她在一份年假统计表里看到这样的“请假日期”: 日期、天数、时段,全揉进了一个单元格。对人来说这行字能读,可对 Excel 来说,这只是一串无法计算的文本。 电脑既不知道请了几天,也没法用 SUMIFS 去统计,每核对一次,都得靠人眼读、计算器加。 这违背了最基本的一条——数据原子化: 正确的做法,是把这几天的请假明细拆成四行记录: 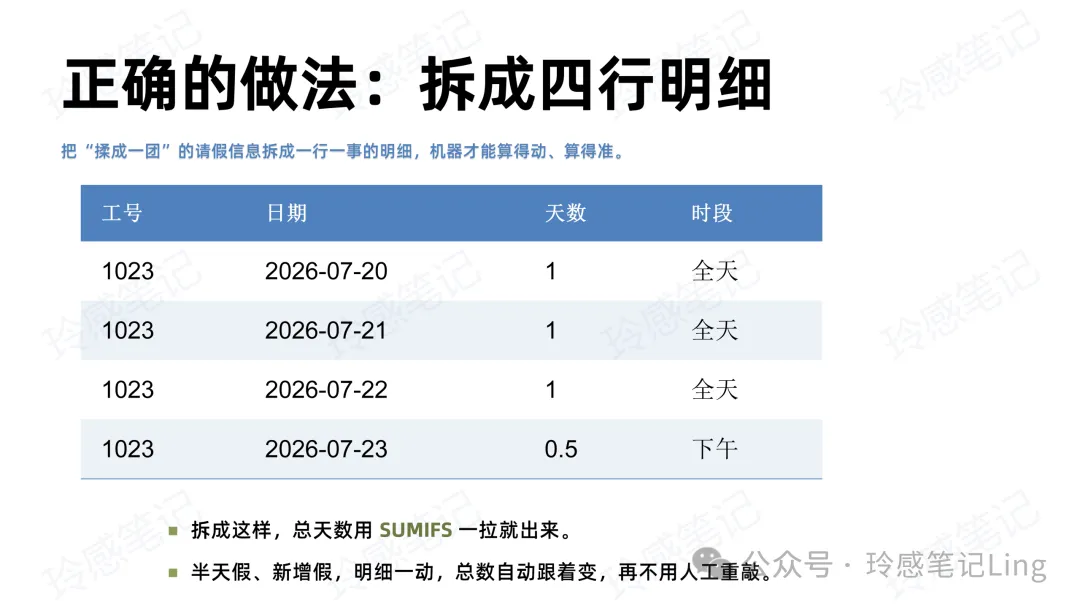
拆成这样,总天数用 SUMIFS 一拉就出来;半天假、新增假,明细一动,总数自动跟着变,再不用人工重敲。 结构病二:缺一个“唯一标识” 还是那张年假表,为了脱敏只留了姓氏,结果表里出现好几位“黄某”、两位“梁某”。一旦重名,系统根本分不清这条请假记录算给谁。 玲宝宝由此得到一条底表铁律:底表里必须有唯一标识,对员工是工号,对学员是学号,对订单是订单号。姓名可以重复、可以改,唯一标识不会。它是每条记录在数据世界里的“身份证”。 回头看,这两个病和交叉表是同一类病根——制表人只想着“我怎么记最省事、怎么摆最丰满”,却没去想“机器要怎么算、以后要怎么用”。 认清楚了,动手其实很快。玲宝宝要做的,是把那张“校区×月份”的二维表转回一维。 二维 → 一维:用 Power Query 逆透视。 整个过程是可逆的、可刷新的——校区表下次更新,右键刷新即可,不用重做。 一维 → 二维:用数据透视表。 想要那张给人看的交叉汇总,把一维表丢进透视表:校区拖到行、月份拖到列、人数拖到值,几秒钟就出。也就是说,二维报表不该靠手堆,而该从一维底表自动生成。 至于开头想算的“华东区”,光立起月份还不够——表里只有校区、没有大区。她另外整理了一张“校区—大区”对照表,用 VLOOKUP 按校区匹配出大区,再按大区筛选、求和,华东的总数这才真正算得出来。 把表转对之后,玲宝宝没有停在操作上。她想起之前看到的一个说法:新手做表第一步是打开软件画格子,真正会做表的人,第一步是停下来想清楚三件事。 她对照着理了一遍。 第一,这张表给谁看? 同一份数据,受众不同,表就该是不同的样子。 第二,对方最关心哪个数字? 人扫一张表,头半秒只做两件事——找到自己的名字、找到自己的数字。把那个关键数字突出(比如剩余天数标绿加粗),其余的退后,这是功能性的设计,不是为了好看。 第三,这数据是一次性的,还是要长期用? 只打印签个字存档,怎么方便都行;要每月更新、长期追查、发给别人,就必须按“可计算、可追溯、可复用”来建。 她很喜欢其中一个朴素的逻辑,叫“存折逻辑”:资源输入 → 资源消耗 → 资源剩余,视线从左到右扫一遍,不用任何人解释,就知道数字怎么来的。判断一张表合不合格,也有个简单的“三秒测试”: 三个都过,才是一张真正“不迷糊”的表。 
下班前,玲宝宝把逆透视后的一维表、匹配好的校区大区对照、和一张自动生成的校区汇总看板一起交了上去。这一次,不管宏财再怎么换月份、调整大区口径,她都能在几秒内把数拎出来。 她在笔记上写下今天最要紧的一句话: 一维表有几个更“硬核”的名字。在数据库领域,这种一条条的明细记录接近事实表(Fact Table):格子里的数值是“度量”,工号、学号这类标识是用来关联的维度键;而真正的维度表,是另外存放员工、学员、校区、日期这些描述信息、再靠维度键与它对应起来的表。你在 Excel 里练的一维流水结构,本质上就是在搭一张小型数据库的表——这也是为什么规范的一维表能直接喂给 Power Query、透视表,甚至以后对接系统。 二级考试一般不会直接让你“区分一维二维”,但它反复在考这件事的结果:数据透视表能不能正常拖、SUMIFS 能不能正确求和、合并计算能不能识别区域。很多真题表面是在考函数,底层考的却是“你的数据结构规不规范”。把一维表、原子化、唯一标识这几条立住,操作题会顺手很多。 数据结构理顺了,宏财又提新要求:把满意度分数自动分成“满意、一般、不满意”三档,几百条记录总不能一条条手动判。下期讲一个最会“做判断”的函数——IF 嵌套,一层搞定自动分级。 这里是玲感笔记,记录一个叫玲宝宝的实习生,怎么把每件事慢慢做专业和靠谱。我们下期见。
第05期|一个格子里塞三个月,你的表当然算不对
《玲宝宝职场实习记》· Excel卷 第5期
先分清:一维表给机器算,二维表给人看
一维表是“原料”,每列一个字段,专门给电脑统计;二维表是“报表”,行列都是分类,专门给人阅读。
两个最常见的“结构病”,比交叉表更隐蔽
20-22号 3,23号下午 0.5
一个格子只存一个值,一行只记一件事,一列只表一个含义。
怎么转:二维逆透视成一维,一维透视成二维
选中数据区域,点「数据」选项卡 →「从表格/区域」(高版本 Excel),进入 Power Query 编辑器; 选中需要保留的列——这里点一下「校区」列; 「转换」选项卡 →「逆透视列」→「逆透视其他列」; 原本横着的 1月~12月,瞬间收成两列:属性(月份)和 值(人数); 把两列重命名为「月份」「人数」,月份若是数字文本,再改一下数据类型; 「关闭并上载」,一张标准一维表就回到了工作表。
一句话记住操作方向:录入存一维,展示用二维;二维靠逆透视还原,靠透视表生成。
更深一层:做表之前,先问“给谁看、用多久”
给员工看:只要结果,列越少越好,把“还剩几天”放到最大; 给领导看:要趋势、要异常,需要汇总; 给自己当底表:要全字段、一维、可计算。
三秒能不能找到自己的名字; 三秒能不能找到关键数字; 三秒能不能看懂这个数字是怎么算出来的。
今天怎么存,决定了明天怎么算。把底表做“瘦”、做规范,报表才又快又稳;表不是塞得越满越能干,而是结构越清越值钱。
📌 冷知识
🎓 二级考点关联
🔜 下期预告
📌 记不住公式?我把计算机二级最高频的 50 个函数做成了一个随身速查小程序。语法、参数、真题易错点都整理在里面。随手收藏,考前刷到哪查到哪,省去翻书时间。
👉 点下方卡片,直达该函数详情页(建议右上角「添加到我的小程序」,下次下拉微信就能找到)