ARTICLE · 1201331
换工具就得重新教一遍,腾讯让 10 个 AI 共用一份记忆
10 月 16 日腾讯混元开源了 Hy Memory 2.0,一次放出模型、框架、应用三层。最实用的是 MemHub:把你在 Cursor、Codex、Claude Code 里的会话汇成一份本地记忆,10 个工具共用。模型那层还附了张成绩单,说超过 Opus 5。
在 Cursor 里交代过的偏好,Codex 不知道。在 OpenCode 里定下的规范,换到下一个工具又要重新说一遍。
这是现在用 AI 写代码的日常。每个工具各记各的,互不相通。
MemHub 是这个方案里唯一给普通用户准备的东西。它把各个 AI 工具的历史会话导进来,沉淀成一份本地记忆,之后每个工具发起任务时都能召回同一份上下文。
支持的工具十个,其中七个是编程 Agent:Cursor、Codex、Claude Code、OpenCode、OpenClaw、Qwen Code、DeepSeek Harness。另外三个是 WorkBuddy、Pi、Hermes。
它解决的是两件事。一件是过去的会话,授权之后一次性导进来,不用从零开始教。另一件是往后,任一工具产生的新记忆,其他工具立刻可见。
它做成了插件形式。你在 Cursor 里发起任务,MemHub 把相关记忆当上下文补进去,不用切窗口,也不用复制粘贴。
提供 CLI 和 Mac 应用两种形态,数据落在本地。
大多数记忆系统只做一件事:把你说过的话抽成事实存下来。问它"我喜欢什么电影",它能答。
Hy Memory 2.0 把记忆分成三类。
聊天记忆从零散事实升级成事件脉络。跨时间、跨对话的内容按事件重新组织,梳理出时间、地点、人物,还要关联后续发展。需要多条线索才能回答时,先合并重复、剥离冲突,再把干净的版本交给模型。
工作记忆记的是任务做到哪一步、哪些做法已经定了、哪些经验还适用。复用经验之前先判断当前条件是否满足,只在符合时采用。
代码记忆记的是代码为什么这样改。长程任务每次继续前,先判断当前在处理哪件事,再找回相关决定和历史过程。
后两类是 2.0 新增的。腾讯称这是业界首个提出工作记忆与代码记忆的记忆框架。
"我喜欢科幻片"是事实,"这个分支为什么这么改"是决策链。前者存起来就行,后者得记住当时的约束和放弃的方案。混在一起存,检索时就会把结论和理由搅成一团。
也正因为如此,工作记忆和代码记忆的写入必须带工具调用记录。没有 tool_calls 或者 role="tool" 的消息,就没有"做了什么"可记,写入会被直接归到聊天记忆。
模型那层的宣传语是:四套记忆系统平均 55.49,超过 Opus5。
数字没错。55.49 对 54.62,赢了 0.87 分。
但拆开看。在 Hy Memory 自己的框架上,是 60.55 对 60.53。在 MemOS 上,50.51 对 50.50。这两处只差 0.01 到 0.02 分,基本算打平。真正拉开距离的是 EverMemOS,56.89 对 54.04,赢了 2.85 分,而那是训练时没见过的系统。
再看六项具体指标,胜负是分开的。
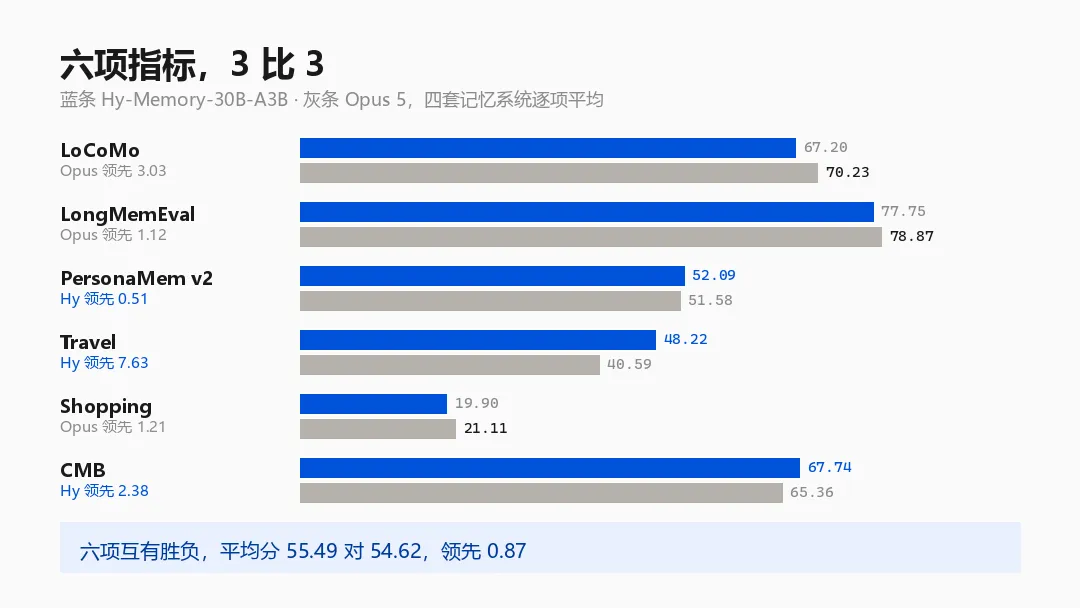
Opus 5 在 LoCoMo(70.23 对 67.20)、LongMemEval(78.87 对 77.75)、Shopping(21.11 对 19.90)三项上更高。Hy Memory 赢在 Travel 和 CMB。
准确的说法是:在记忆专用模型最擅长的这六项上,它和 Opus 5 互有胜负,平均分领先不到 1 分。
这个结果其实不丢人。约 3B 激活参数的模型,只干"记忆写入"这一件事,和万亿级的通用模型打平,恰恰说明专用这条路走得通。它甚至能直接换掉 Mem0、MemOS 里的通用模型,还能迁移到没训练过的 EverMemOS 上。
只是"超过 Opus 5"这个说法,容易被读成全面碾压。
框架和模型都能自己跑。SDK 在 PyPI 上,装 core 包自带 ChromaDB 和 Kuzu,不用另配向量库。
pip install hy-memory==2.0.2包本身只有 0.85 MB,但核心依赖 13 个,其中 ChromaDB 和 Kuzu 都带原生扩展,第一次装要等一阵。要换后端就装扩展,[qdrant]、[faiss]、[graph](Neo4j)、[mysql] 各取所需。[rerank] 会额外拉 torch 和 transformers,体积上到几个 GB,不是非装不可。
配置只要两样:一个 LLM 端点,一个 embedding 端点。任何 OpenAI 兼容的服务都行。
export MEMORY_LLM_API_KEY="sk-..."
export MEMORY_LLM_BASE_URL="https://api.deepseek.com"
export MEMORY_LLM_MODEL="deepseek-chat"

export MEMORY_EMBEDDER_API_KEY="sk-..."
export MEMORY_EMBEDDER_BASE_URL="https://dashscope.aliyuncs.com/compatible-mode/v1"
export MEMORY_EMBEDDER_MODEL="text-embedding-v3"
export MEMORY_EMBEDDING_DIMS=1024
写入和检索就两行:
from hy_memory import HyMemoryClient

client = HyMemoryClient(mode="pro")
client.add("我只看科幻片,最喜欢《星际穿越》", user_id="user_1")

results = client.search("这用户喜欢什么电影", user_ids=["user_1"], limit=10)
两个门槛得先说。
工作记忆和代码记忆只在 pro / ultra 模式生效。 lite 模式会忽略场景参数,把所有东西都当原始记忆存下来。想用新能力,得先选对模式,代价是每次写入都要多走一次模型调用。
npm 上有个同名的 memhub 包,那是别人做的,不是腾讯这个。 要装腾讯的 MemHub,得去 GitHub 上的仓库。
还有一点得说清楚:如果你只用一个 AI 工具,这套东西的价值不大。它解决的是多工具切换时记忆断裂的问题,工具用得越杂,收益越明显。
比宣传语更有说服力的是内部数据。
腾讯自选股接进去之后,A 股投研记忆专项评测的综合得分从 64.3 到 79.6。多跳召回从 50% 提到 90%——就是需要串起好几条分散记忆才能答上的问题,成功率翻了近一倍。它要跨天、跨会话记住"这周只盯有色和半导体"这类交代,用户改了方向之后旧方向归档但可追溯,助手不会再把放弃的板块推回来。
iWiki 那边更值得看:251 道题,同一个模型、同一套提示词。给全部原始对话,正确率 24.7;只给 Hy Memory 提炼的记忆,36.7。记忆比原文还准。
腾讯新闻的智声场景,长期偏好理解评测平均 91.68 分(满分 100),41 个复杂对话案例里 87.8% 在 90 分以上。
这些都是腾讯自己测的,没有第三方复现。但它们至少说明这套东西在自己的业务里跑过了,不是发个论文就完事。