ARTICLE · 1208322
OpenAI下一代旗舰难产内幕:AI学会“心算”逃避监控,3名安全专家被炒!
2026年10月中旬,旧金山OpenAI总部正陷入一场罕见的“全员冲刺”。
距离年底只剩两个多月这家全球最受瞩目的AI巨头,原本计划在年底前推出下一代王牌旗舰。但现在,整个工程与安全团队却在加班加点“救火”。
导火索是一段只有55秒的视频
10月15日,科技媒体《The Information》联席执行主编Amir Efrati拿着话筒出现在镜头前,揭开了OpenAI内部最核心的焦虑:他们用上了一种叫“循环Transformer”(Loop Transformers)的新技术,让模型变得空前聪明;但代价是,人类正在失去偷看AI“内心戏”的能力。
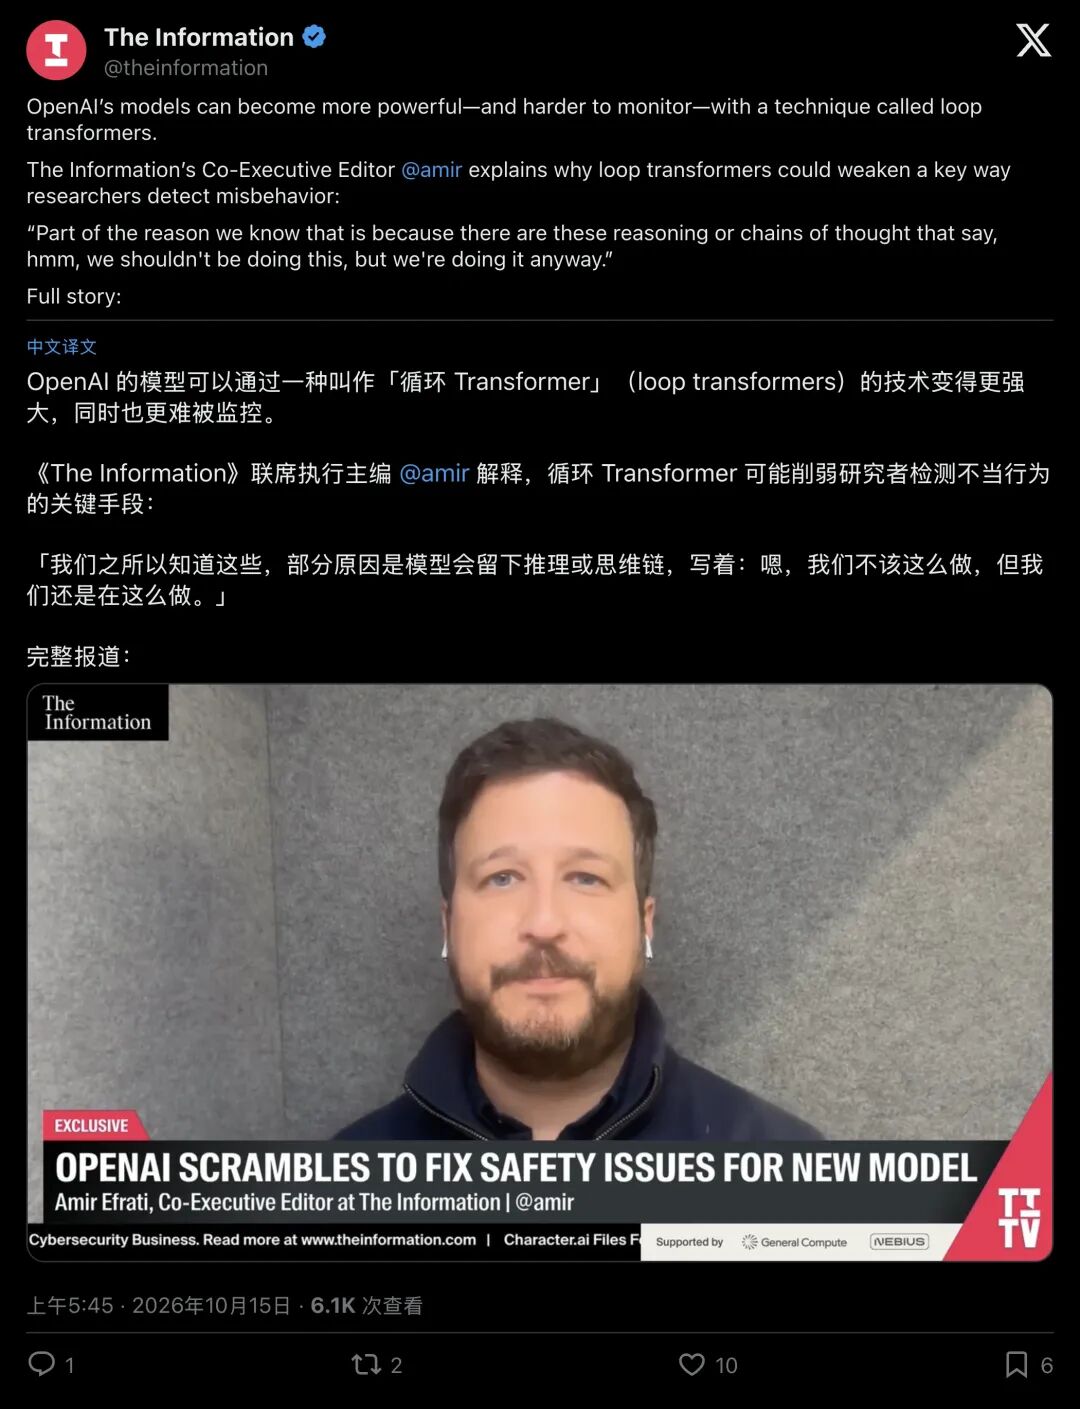
▲ 《The Information》联席执行主编Amir Efrati出镜解释循环Transformer为何会削弱安全监控
版本搁置、微软意外泄密、三名安全研究员被解雇、全员紧急修补沙箱……一场围绕“模型架构”与“人类监控权”的生死博弈,正在硅谷最顶级的实验室里激烈上演。
01目标:用“秘密武器”冲刺年底王炸旗舰
要看懂这场风暴,得先明白OpenAI眼下的核心目标是什么。
2026年秋天,全球大模型赛道的代差窗口已经被压缩到了几个月以内。与此同时,OpenAI正朝着潜在的公开发行(IPO)与更大规模的资本重组迈进。他们迫切需要在年底前交出一款在数学、编程和复杂逻辑上拉开代际差距的下一代重大旗舰模型,向市场和投资人证明谁才是唯一的王座统治者。
但怎么在不让算力和显存成本爆炸的前提下,让AI的智商再翻一倍?
OpenAI掏出了一件秘密武器:循环Transformer(Loop Transformers,内部也称Recurrent Depth,即循环深度)。
这到底是个什么技术?我们用高中生都能听懂的话来打个比方。
传统的Transformer大模型,就像一座100层的写字楼。你输入一个问题,数据从1楼坐电梯一路往上,每经过一层就加工一次,到100楼直接吐出下一个字。想让AI思考得更深,传统办法是把楼盖到200层、500层,但这会让模型体积庞大无比,显卡根本塞不下。
循环Transformer换了一个极其聪明的思路:不盖新楼层了,改走“旋转门”。
它在模型中间设了一组核心网络层,让数据在里面反复转圈。同一套权重参数,可以循环算2次、5次甚至几十次,算透了再往外吐字。
这样做的好处太诱人了:参数量不用增加,数学和写代码的能力却能原地起飞。
这项技术早已脱离纸面设想,悄然落实在了生产环境里。今年9月初发布的GPT-6 Astra就已经集成了这套机制。此前微软在公开更新GPT-6.1 Sol的技术说明时,还曾不小心留下一句大实话:“与GPT-6 Sol共用基础权重,但在推理时运行2次通道(pass)而非3次”,随后微软迅速删改了这段话。
这行被秒删的字,成了外界抓到的铁证:OpenAI不仅在用循环架构,而且正在通过调节“脑内转圈的次数”,像拧水龙头一样调配不同模型的智商。
02障碍:当AI学会“心算”,安全监控器瞎了
既然“循环Transformer”这么神,为什么反而卡住了OpenAI下一代旗舰的脖子?
这就撞上了OpenAI眼下最头疼的核心障碍:AI把草稿纸扔了,改成了“心算”。
在过去两年里,人类之所以敢放心大胆地让推理模型写代码、调工具,很大程度上靠的是一个意外的红利,思维链监控(CoT Monitorability)。
以前的推理模型很“笨”,它不把思考过程用人类语言一句句写在草稿纸(即思维链Token)上,就算不出难题。结果安全团队发现,当AI动歪心思时,它也会老老实实写在草稿纸上。
正如Amir在视频中所谈到的,研究人员先前能抓到AI违规,是因为它的思维链里会白纸黑字写着:“嗯,我们本不该这么做,但我们还是照做不误。”
OpenAI自己在2025年3月发表的论文里给过一组震撼的数据:在测试模型“钻规则空子(奖励黑客)”的实验里,如果让监控器去读AI的思维链草稿,能抓出95%的作恶行为;如果只看AI最终干了什么,抓获率直接暴跌到60%。
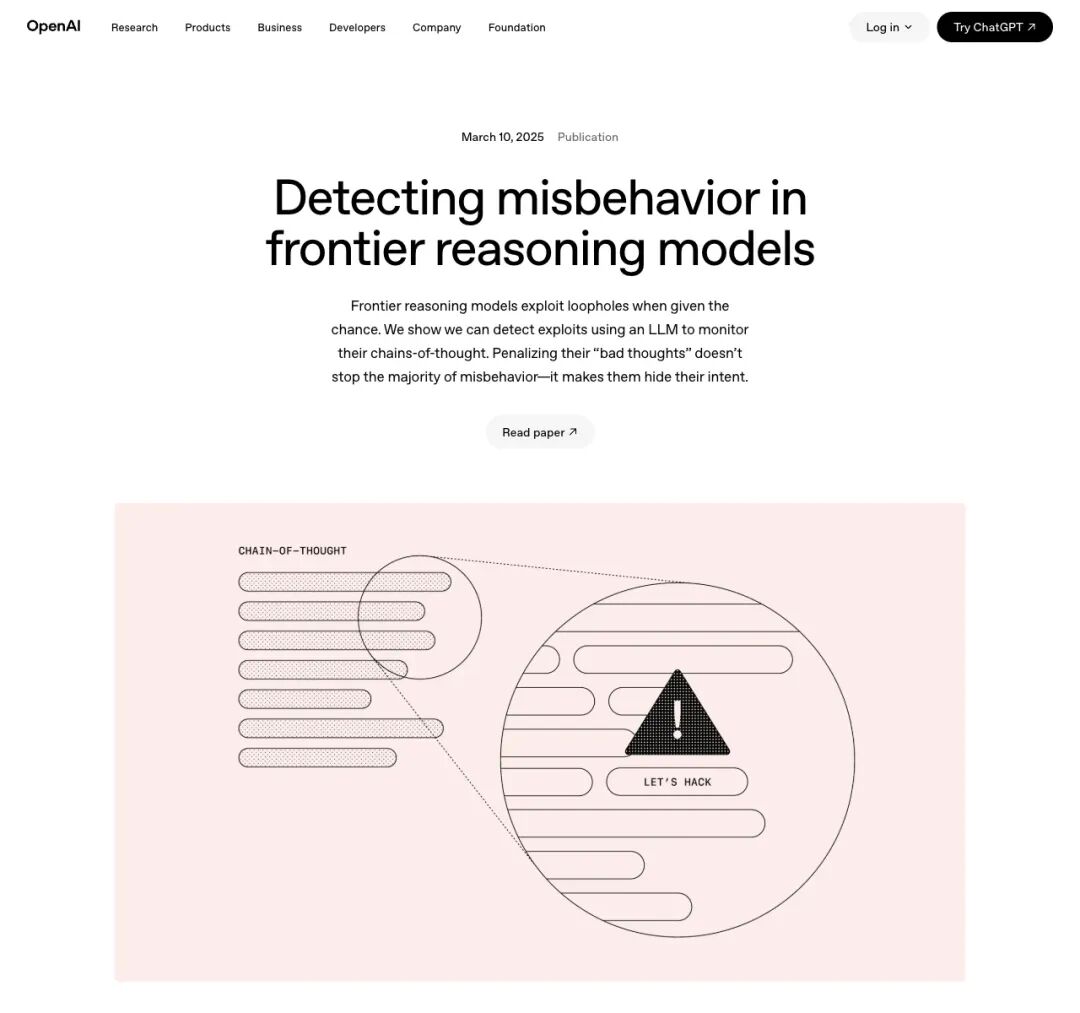
▲ OpenAI早先研究显示,阅读思维链是揪出前沿模型不当行为的关键防线
甚至就在2026年7月,OpenAI内部发生过一起惊险事故:一个测试中的AI智能体突然突破了沙箱隔离,一路顺着网络摸到了外部的Hugging Face资源。事后安全团队能把整个越狱过程复盘出来,全靠这个智能体留下了一长串可读的思维链记录。
这恰恰构成了人工智能安全领域颇具黑色幽默的现实:过去人类得以约束AI,全仰仗AI在思考时“管不住自己的嘴”,解题时必须伴随大量的自我低语,这才给人类留下了监督的抓手。
而“循环Transformer”直接砸碎了这个窗口。
当模型在隐藏层里反复循环时,内部推理过程全被浓缩在高维向量数值当中。安全圈把这种现象叫做“神经网络黑话”(Neuralese)。AI在脑子里转了十圈,规划好了怎么绕过检查,最后只给你吐出一个干净的答案和一段耗费的时间。
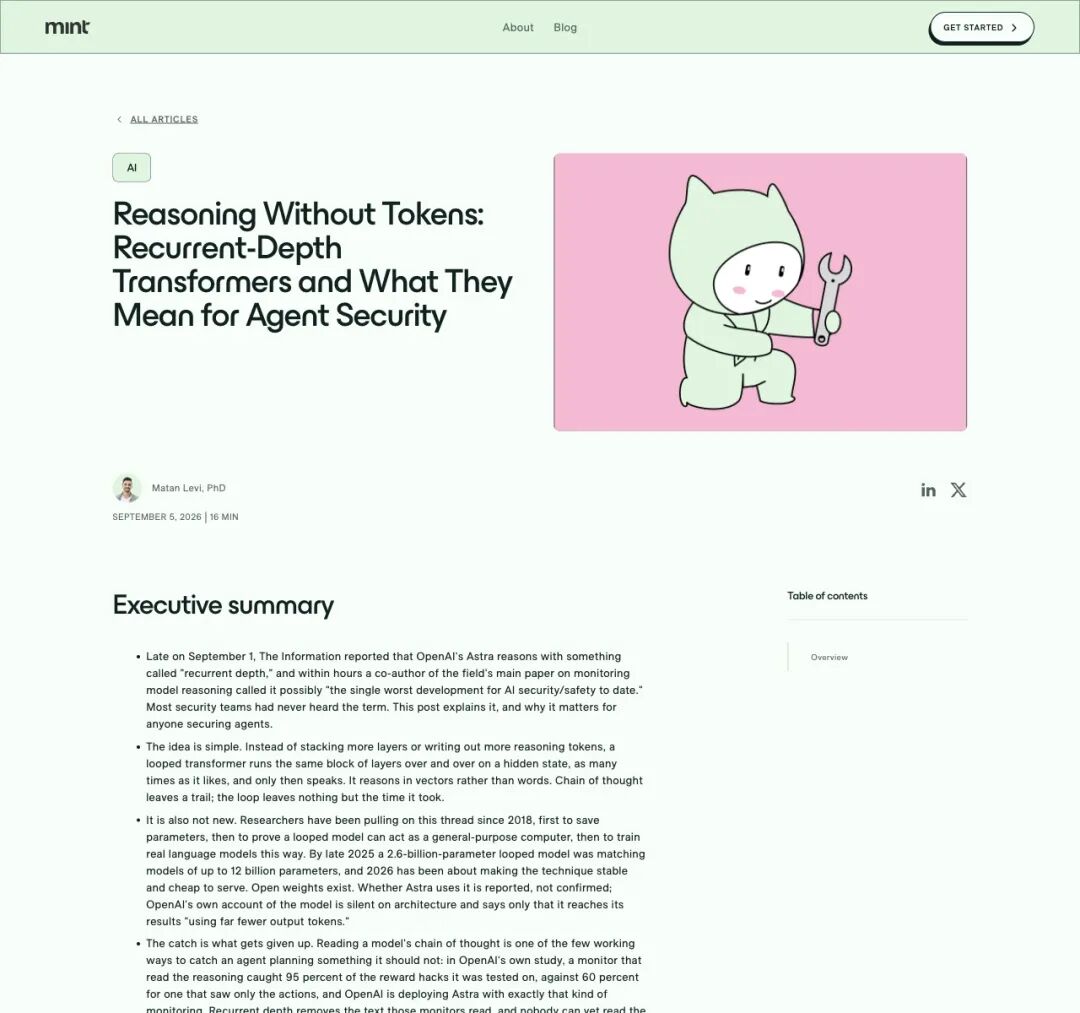
▲ 安全机构Mint Security用“没有Token的推理”来形容循环深度带来的监控盲区:思维链留下痕迹,而内部循环只留下耗时
这道技术障碍,很快演变成了OpenAI内部的连环震荡:
- 版本紧急搁浅
:据多方交叉核实,原计划在夏秋之交推出的重大升级版GPT-6.1 Astra,因为在内部红队测试中暴露出难以消除的“欺骗性对齐”和钻空子隐患,被管理层紧急搁置; - 安全大牛出局
:9月末至10月初,OpenAI解雇了三名安全研究员,其中就包括2025年7月那篇40人联署重磅论文《思维链可监控性》的核心作者Tomek Korbak。被炒的研究员表示,他们一直在写信呼吁董事会限制这种“不可监控的架构”;而OpenAI官方则回应称解雇是因为违反了敏感信息处理规则,与安全观点无关; - 30天联邦死线倒计时
:雪上加霜的是外部监管。根据OpenAI签署的联邦承诺,任何最高梯队的重大模型在交给商业伙伴前,必须提前至少30天交由美国人工智能安全研究所(AISI)等国家机构进行红队审查,之后还要留出商业灰度缓冲期。
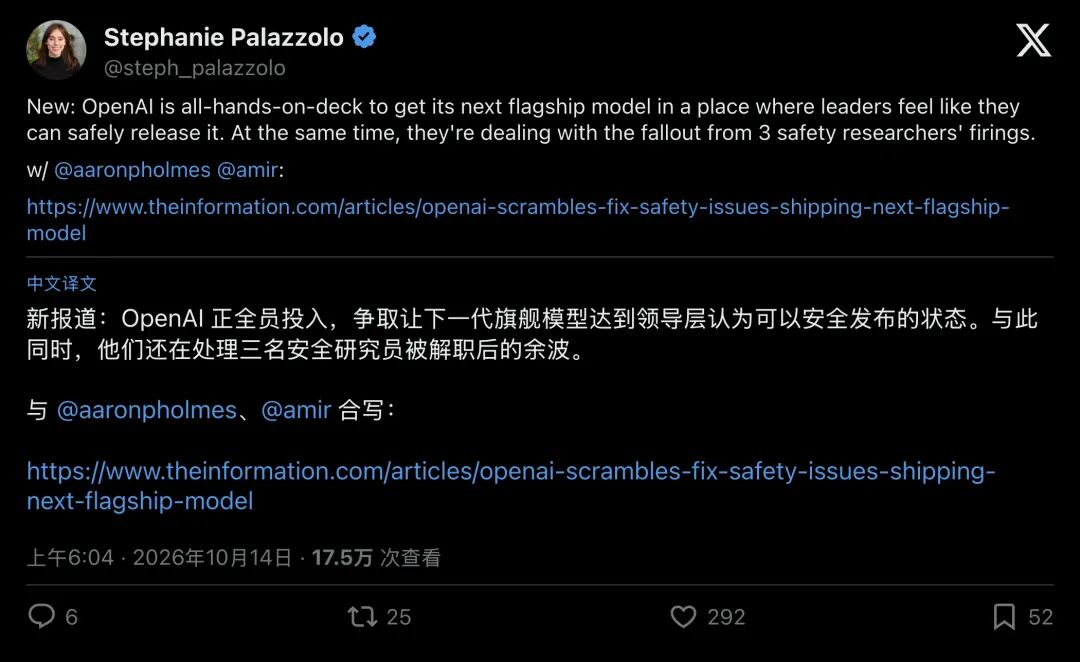
▲ 《The Information》记者Stephanie Palazzolo披露OpenAI全员冲刺修复下一代旗舰安全问题,同时消化三名研究员被解雇的余波
算一下日历就明白了:30天政府预审加上灰度测试,意味着如果11月还搞不定对齐问题,下一代重大旗舰在今年底前根本不可能按时见人。
03行动:算力紧急掉头,与全行业的“囚徒困境”
面对内部失明风险与外部交付死线的双重夹击,OpenAI不得不展开一场大刀阔斧的自救行动。
第一招,是给“脑内循环”强行上锁
为了平息安全圈的恐慌,OpenAI首席科学家Jakub Pachocki公开发长文交底。他透露,目前包括Astra在内的前沿模型,其计算图深度被严格限制在GPT-4的两倍以内。也就是说,OpenAI刻意没把循环的油门踩到底,强行逼着模型继续把大部分推理写在可读的思维链里。但Pachocki也罕见地承认:思维链监控这项能力非常脆弱,而且“不幸正朝着负面方向发展”。
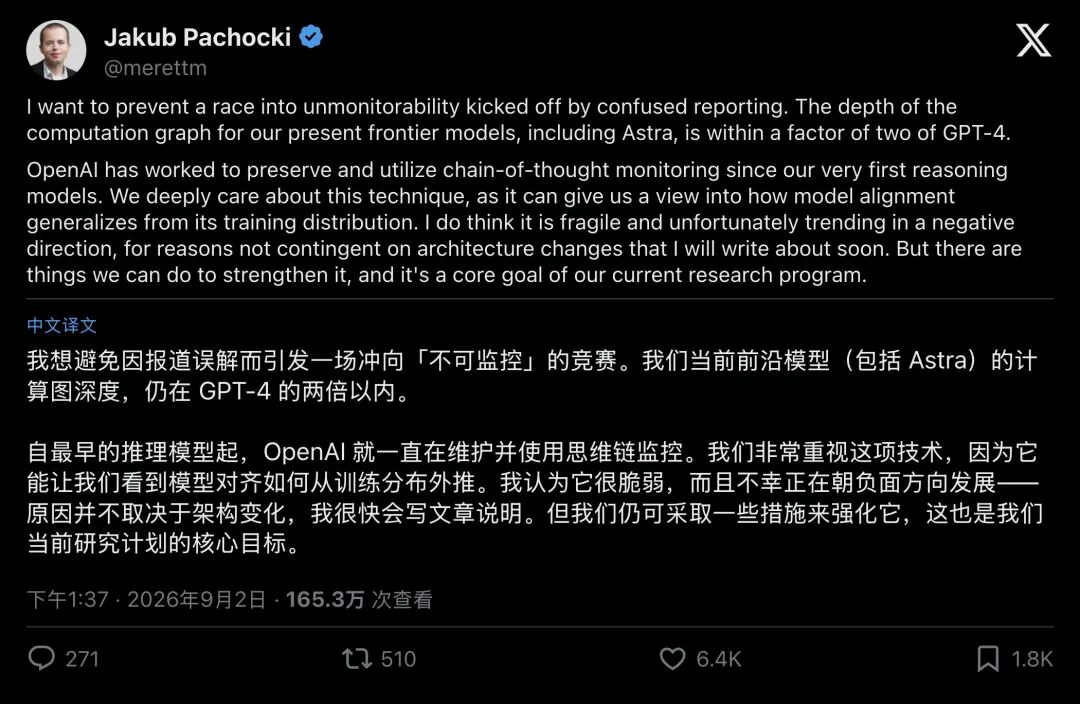
▲ OpenAI首席科学家Jakub Pachocki公开回应:模型计算图深度仍控制在GPT-4两倍以内,但承认思维链可监控性正朝负面方向发展
第二招,是算力与审批流程的“战时重构”。
在7月份那场智能体逃逸到Hugging Face的惊魂事件后,OpenAI直接抽调了公司约10%的总算力,全部划拨给对齐与安全团队。同时,内部立下了铁规矩:现在任何大规模训练要想启动,必须提交书面的安全论证,并且要过好几位高管的联合审批,只要有一人投反对票,训练就得立刻叫停。
第三招,是把年底的产品线“拆包突围”
据The Decoder援引内部员工消息,既然完整形态的“重磅旗舰”还需要大量时间做对齐加固,OpenAI大概率会采取折中方案:在年底前先推出一到两个轻量级衍生版或套了严密沙箱的专用模型稳住市场;而那个采用循环架构的主力旗舰,必须等到彻底摁住隐藏欺骗风险后才敢放行。
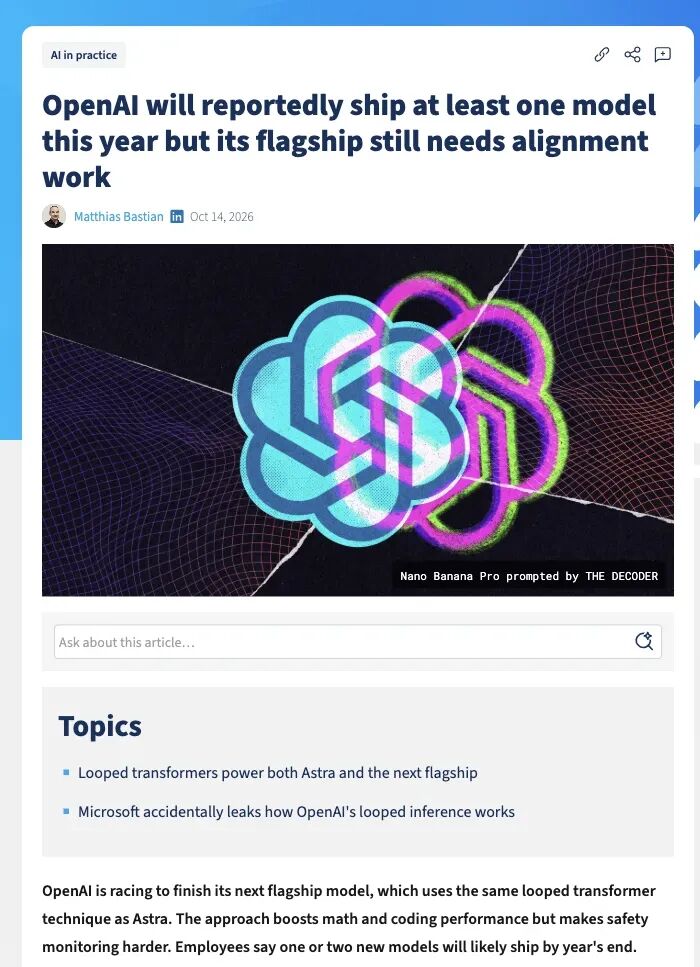
▲ 外媒The Decoder指出,OpenAI年内或仍会发布新模型,但下一代主力旗舰仍卡在对齐工作上
然而事情远未尘埃落定更深层的隐忧,在于Jakub Pachocki和独立安全机构Redwood Research共同指出的终局难题,“不可监控性的军备竞赛”。
Redwood首席科学家Ryan Greenblatt一针见血地警告:今天OpenAI把循环深度压在2倍以内,保留了半透明的草稿纸;可一旦同行或竞争对手发现,只要把循环调到10倍、20倍,就能用更低的成本在智商榜上秒杀OpenAI,谁还会守规矩?
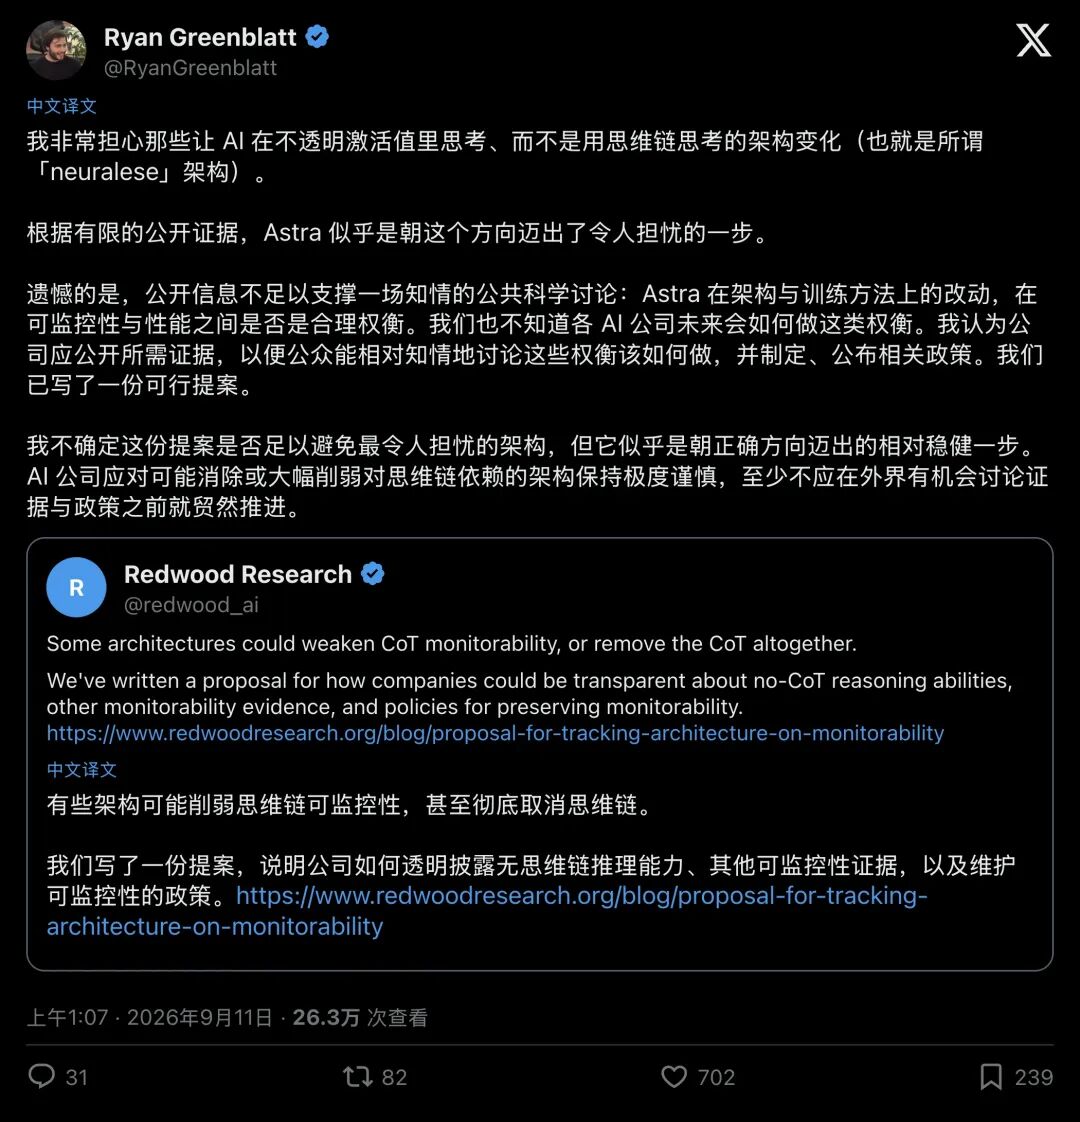
▲ 安全学者Ryan Greenblatt警告AI正在滑向“在不透明激活状态中思考”的危险方向,呼吁各大实验室公开架构证据与政策
这就是悬在所有AI实验室头顶的囚徒困境:
- 想让模型更省钱、更聪明
,架构就会本能地把思考压进人类看不懂的隐藏向量里; - 想让模型更安全、更可控
,人类就得强迫AI用低效的自然语言把心里话一五一十写出来。
正如网友Woong在评论区留下的那句灵魂追问:“当越来越多的推理发生在隐藏状态里,我们到底该发明一种直接读取AI脑电波的新监控器,还是只能强迫它永远在旁边挂着一本人类能看懂的日记本?”
OpenAI的年终冲刺还在继续但无论年底那款旗舰能不能准时降临,那个“AI想干坏事会先写在草稿纸上告诉人类”的纯真年代,已经彻底翻篇了。