ARTICLE · 1208313
4万篇AI垃圾冲垮arXiv!35年学术圣地紧急拉闸:每人每月限投2篇
作者 | 言序
编辑 | 疏桐
2026年10月1日,全球科学界最核心的“知识大动脉”,预印本平台 arXiv,被迫拉下了紧急制动闸。
生成式AI掀起的投稿海啸,正把它推向审核能力的极限。
就在刚刚过去的9月,arXiv单月收到了创纪录的 40,363篇 论文提交,几乎是两年前(20,569篇)的两倍、十年前(9,869篇)的四倍。后台同时炸出了近 9,000张 客服工单。在最疯狂的人工智能分类(cs.AI)下,投稿量两年暴涨了 6倍以上。
全平台近300名志愿审核员,每天像流水线工人一样合力审完约1,000篇稿件,却依然眼睁睁看着近 4,000篇 待发论文堵死在排队通道里。大量有价值的科研成果,因为少数高频、低质的“AI灌水稿(AI slop)”霸占审核通道,被硬生生拖延数天甚至数周。
忍无可忍之下,arXiv宣布废弃沿用多年的柔性调控,全站上线“硬核限流”新方案:每个账号每月最多只能提交2篇新论文。
▲ arXiv官方账号宣布更新全体提交者的速率限制政策,并附公告链接
消息一出,《自然》(Nature)杂志直接抛出灵魂拷问:“arXiv大战AI灌水:限制投稿数量管用吗?”而在评论区,一位网友用一句话刺穿了这场学术危机的本质:
“原来垃圾过滤器一直是‘写论文很烦’,直到它坏了大家才发现。”
01旧方案的崩塌:当“君子协定”撞上AI印钞机
要读懂这场风暴,得先明白arXiv究竟是个什么地方。
在传统学术界,一篇论文从投稿到正式发表在期刊上,往往要经历数月甚至数年的同行评审。为了抢占首发权、让同行第一时间看到成果,物理、数学、计算机等领域的科学家们从1991年起养成了一个默认习惯:先把写好的手稿挂到arXiv上公开。 这就叫“预印本(Preprint)”
arXiv作为预印本平台,不收版面费,也不做耗时数月的深度评审。在长达35年的时间里,它的旧治理方案本质上是一套建立在学者自觉之上的“君子协定”:
- 轻量级人工把关
:依靠几百名义务奉献的专家审核员,快速扫一眼稿件是否符合基本学术规范、有没有投错分类,合格即放行; - 模糊的“实务上限”
:2024年前后,平台虽设有“同一时间最多3篇稿件处于待审状态”的门槛,但对每月总投稿量只靠审核员酌情限流,因为默认常识是,一个正常人脑力有限,一个月根本写不出几篇严肃论文。
然而,大模型把这套维持了三十多年的旧方案撕得粉碎。
当“把实验数据扩写成一万字学术英语”的边际成本降为零,学术界的黑产流水线和投机者迅速摸透了套路。arXiv编辑顾问委员会主席、俄勒冈州立大学荣休教授 Thomas G. Dietterich 痛斥说,平台上居然有人每个月提交几十篇论文。
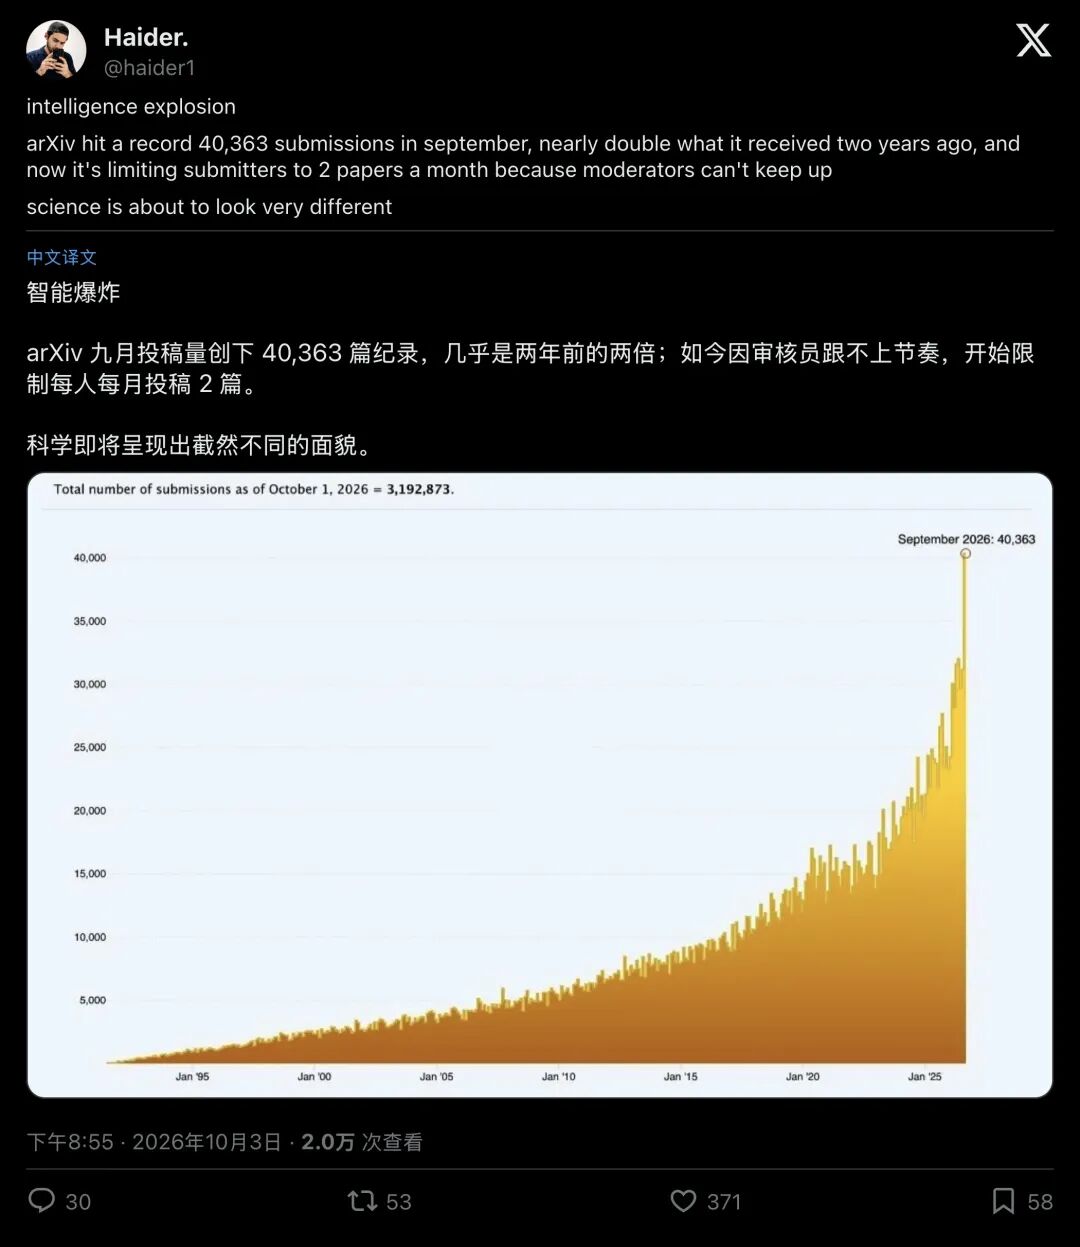
▲ 网友晒出arXiv单月提交量突破4万篇的陡峭增长曲线
这些塞满审核通道的“AI灌水稿”长什么样?其中常见高度工业化的“切香肠论文(Salami-slicing)”和“微结果(Micro-results)”:
本来一整套完整的研究,被作者硬生生拆成七八篇。今天把深度学习模型里的一个数学函数换一下,跑个分,让大模型套上宏大的引言和文献综述,凑成一篇;明天改两个微小的参数,换个数据集再水一篇。表面看结构工整、辞藻华丽,扒开内核,学术增量薄得像一层窗户纸。
量化研究也记录了AI辅助学术写作的扩张,但这些统计不能直接判定论文质量。
斯坦福大学 Weixin Liang 与 James Zou 团队曾对arXiv、bioRxiv及Nature旗下近 95万篇 论文做过全景测算(arXiv:2404.01268)。研究估计,计算机科学论文受大模型修改的比例增长最快,最高达 17.5%;在群体统计层面,第一作者投稿频率较高、研究方向更拥挤、篇幅较短的论文,与更高的AI修改比例相关。
德国图宾根大学 Dmitry Kobak 团队则在分析了1500万篇生物医学摘要后(arXiv:2406.07016),直接抓住了大模型的“词汇指纹”:像 delve(深入探讨)、showcase(展现)、pivotal(关键)、intricate(错综复杂) 这类词,在2022年底前极少出现,却在ChatGPT问世后走出了一条诡异的垂直飙升线。
为了堵漏,arXiv在过去一年里试过不少打补丁的过渡方案:2025年11月起,收紧计算机领域的综述与立场论文,要求必须先过同行评审;2026年5月,宣布对带有“AI幻觉假引用”的作者处以禁投一年的重罚。
▲ 科技媒体404 Media回顾arXiv与AI灌水长期拉锯的防线升级
但局部打补丁,根本挡不住全自动印钞机。当9月份单月4万篇洪峰砸下来时,旧方案彻底宣告破产。
02新方案亮剑:全站“一刀切”硬配额,连拒稿都扣次数
10月1日,arXiv社区参与经理 Kat Boboris 在官方博客正式祭出新治理方案,用冷酷的硬性配额,接管失灵的道德自觉。
对比过去依赖审核员个案判断的旧模式,这套新方案的刀法极其精准,甚至有些“不近人情”:
- 全站硬顶,每月2篇
:自10月1日起,每位提交者每个日历月最多只能提交 2篇 新稿件,叠加原有的“同时最多3篇活跃待审”限制。跨学科分类合并计算,换个马甲投别的学科也没用。 - 谁点按钮算谁的账
:限额绑定“实际点击提交按钮的账号”,共同作者的额度不受这次提交影响。 - 最狠的一条,被拒稿也扣额度
:如果你这个月投了2篇,哪怕全被审核员打回拒绝,你本月的额度也直接清零,必须等下个月才能再投。
为什么被拒稿还要扣次数?审核员的时间消耗在每一次提交上 只要你按下了提交键,审核员就得花时间去读、去甄别;既然消耗了公共审核资源,就必须买单。在稿件正式公布前主动删除提交,可以不占用额度。
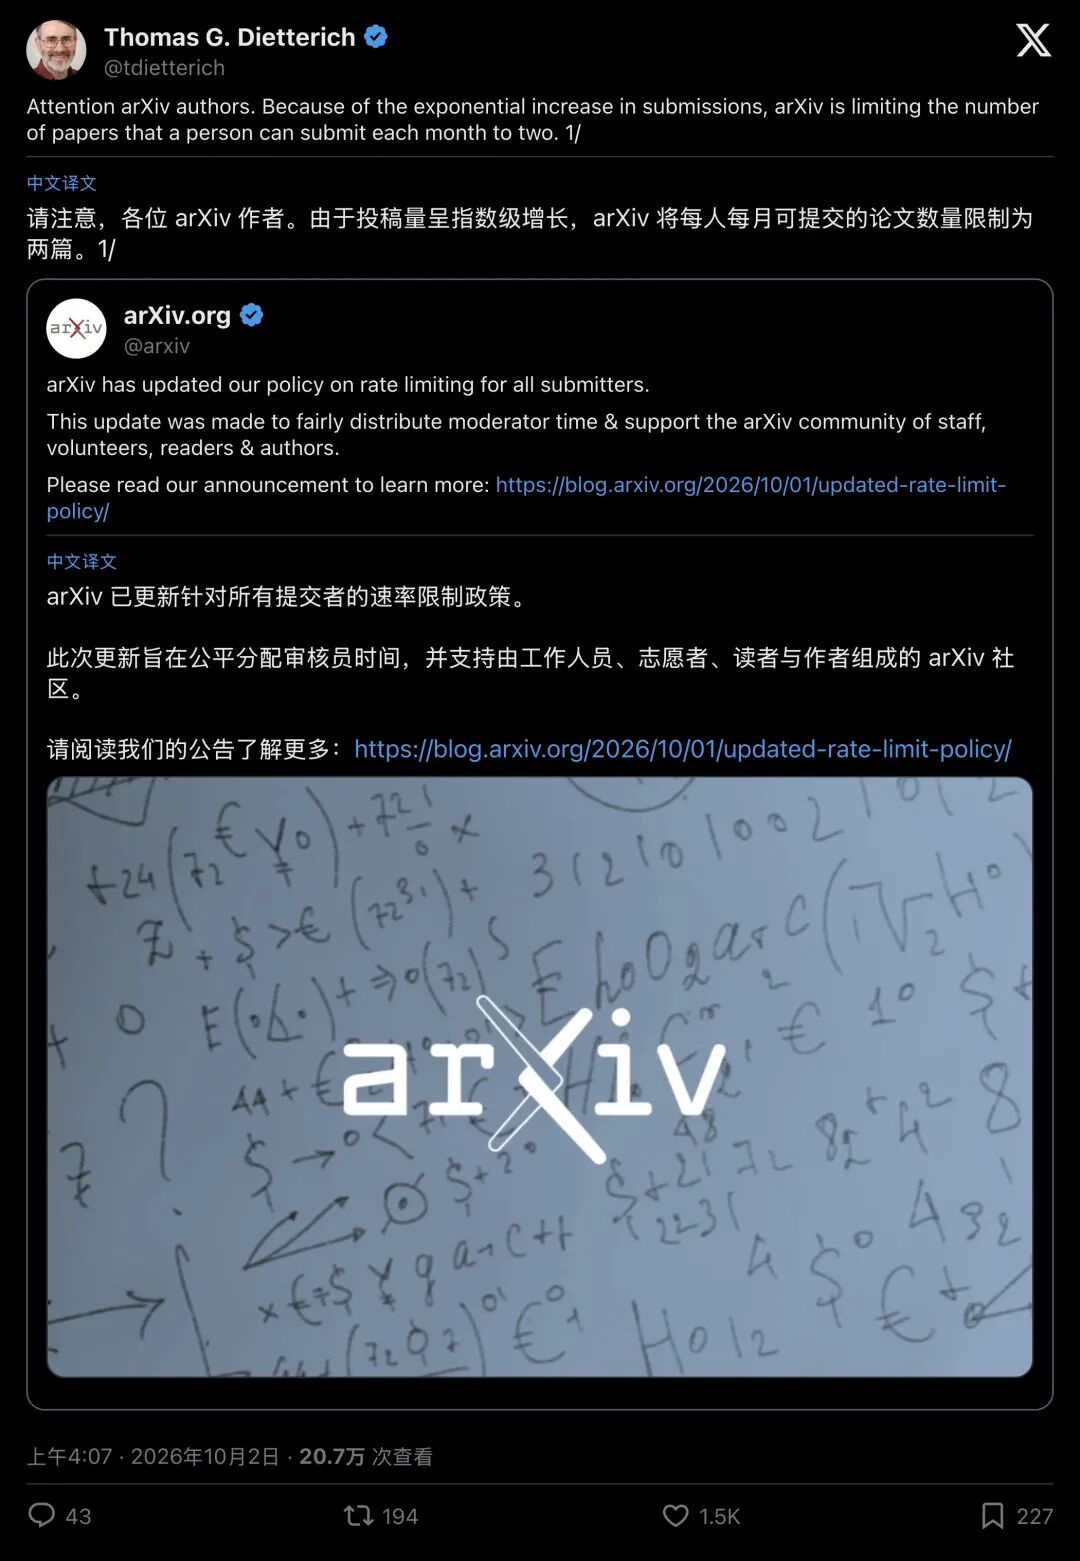
▲ arXiv编辑顾问委员会主席 Thomas G. Dietterich 发帖解释,投稿增长促使平台限制每月提交数量
Dietterich 教授在社交平台上苦口婆心地解释:新方案是一记急刹车,目的是逼迫学者们放弃刷数量的“最小可发表单元”,回归精雕细琢的“最佳可发表单元”。
03方案大交锋:大快人心的刹车片,还是误伤天才的紧箍咒?
这套“一刀切”的新方案刚一落地,就在全球学术圈炸开了锅。支持者拍手称快,批评者则直言这是一套粗糙的机制设计。
叫好派认为,人类读者的眼睛早就受够了。
罗格斯大学数学家 Alex Kontorovich 直接转发官方公告力挺:“我爱死这项政策了!我根本不可能在一个月里去读某个人写的42篇论文。挑两篇吧,挑你最好的两篇投上来”哥伦比亚大学流行病学家 Siddhesh Zādéy 也对《自然》表示,正经做科研,一个月能写出两篇扎实的手稿已经是极限工作量,根本谈不上扼杀生产力。
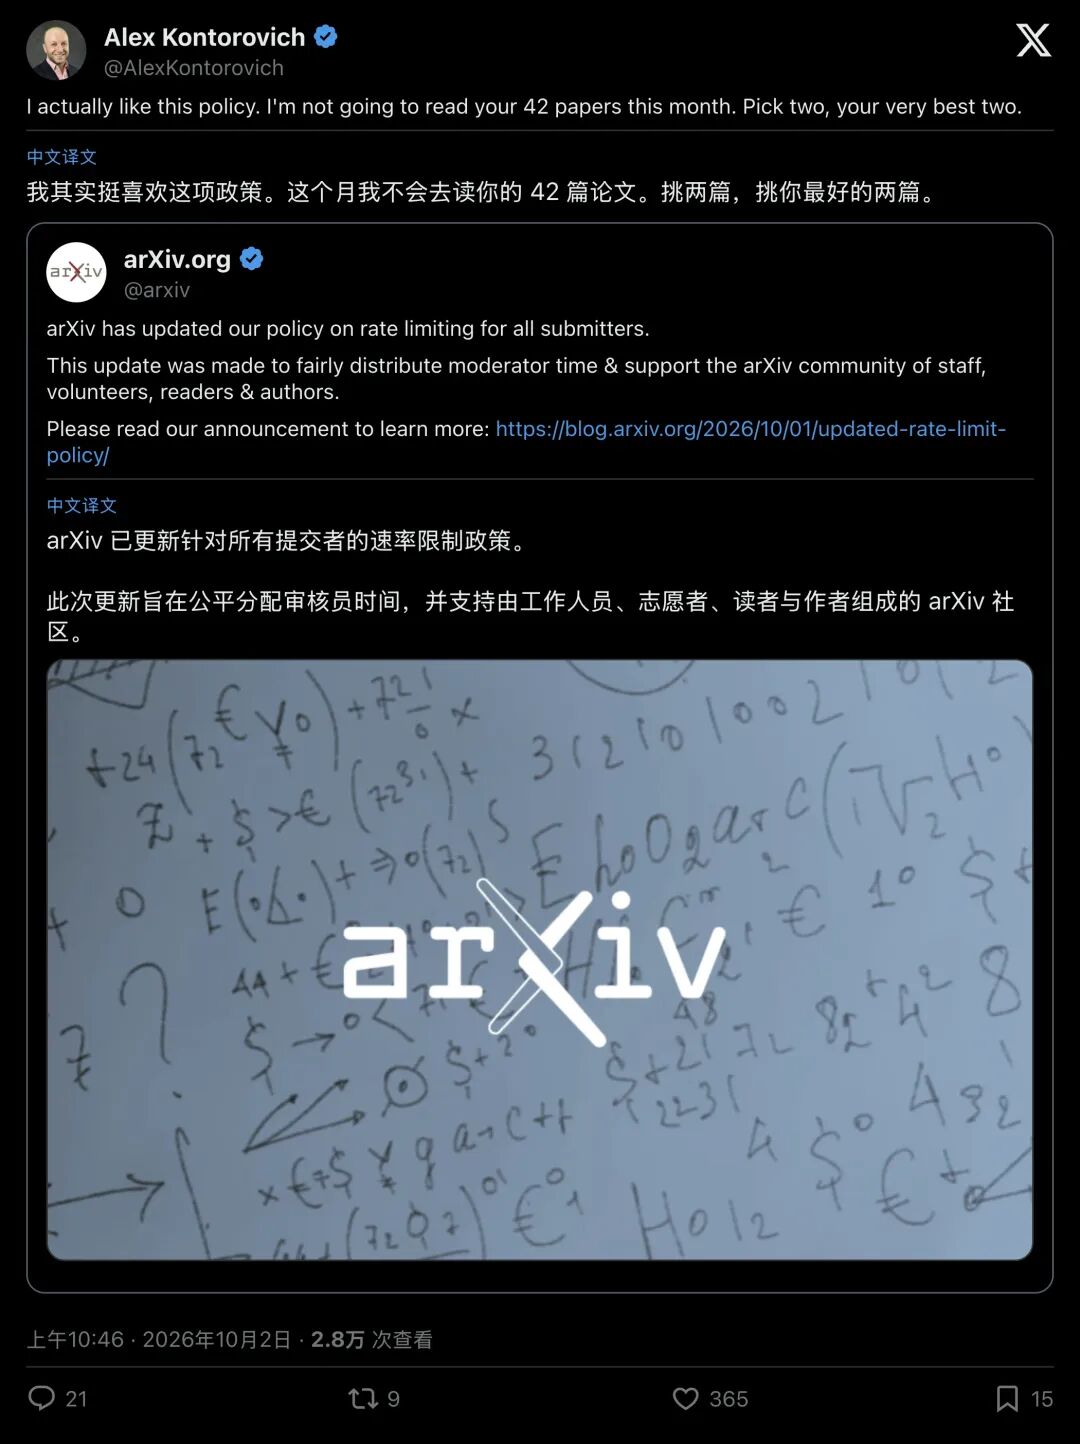
▲ 数学家 Alex Kontorovich 吐槽没人能读完一个人单月产出的42篇论文
但机制设计学者与一线物理学家们,很快看出了新方案的漏洞与副作用。
首先是“上有政策,下有对策”马里兰大学理论物理学家 Victor Galitski 指出,既然限额只卡“按提交按钮的人”,那大实验室或灌水团伙只需要让共同作者轮流注册账号点提交,就能轻松绕过封锁。物理学家 Sabine Hossenfelder 则精准预言了另一个副作用:以后arXiv上的单篇论文篇幅将会显著暴涨,作者会把原本拆成三四篇的内容,硬塞进一篇超长巨著里。
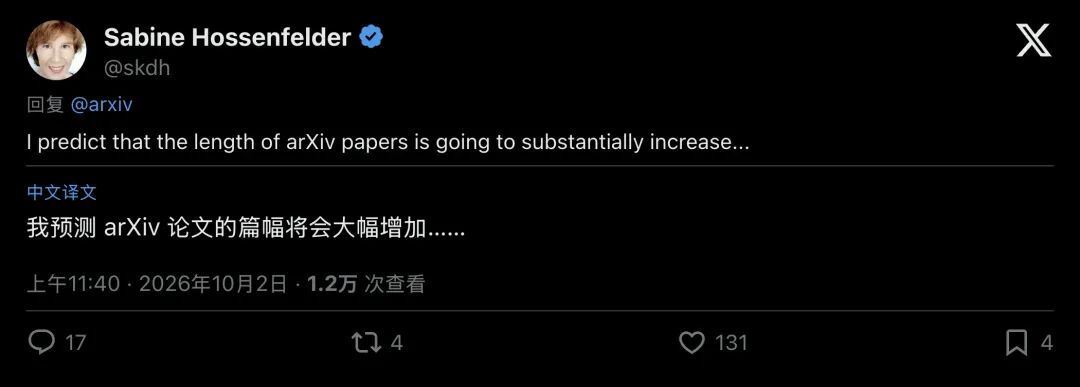
▲ 物理学家 Sabine Hossenfelder 一针见血地预测:接下来的arXiv论文将会变得非常长
更有意思的批评,来自哈佛商学院教授、市场设计学者 Scott Kominers。作为在arXiv投稿近二十年的老用户,他连发长文指出:arXiv的新方案搞混了“节约审核资源”和“限制学术产出”。
在 Kominers 看来,按人头平分“每月2篇”的统一配额,存在三大硬伤:
- 防不住账号泛滥
:如果成千上万个新注册账号每人每月投2篇AI垃圾,审核队列照样爆仓; - 误伤高产学者
:赶顶会截稿期(Deadline)的团队,或者借助AI大幅提升合法科研效率的顶尖学者,会被“一刀切”的硬顶卡住脖子,甚至被迫流向其他平台; - 浪费了历史信誉数据
:他提出了一套“基于信誉分级的替代方案”,为什么不给长期记录良好的资深学者开通“轻审核绿色通道”(一旦违规立即吊销),而把严审火力集中对准高频异常账号及其背书网络?
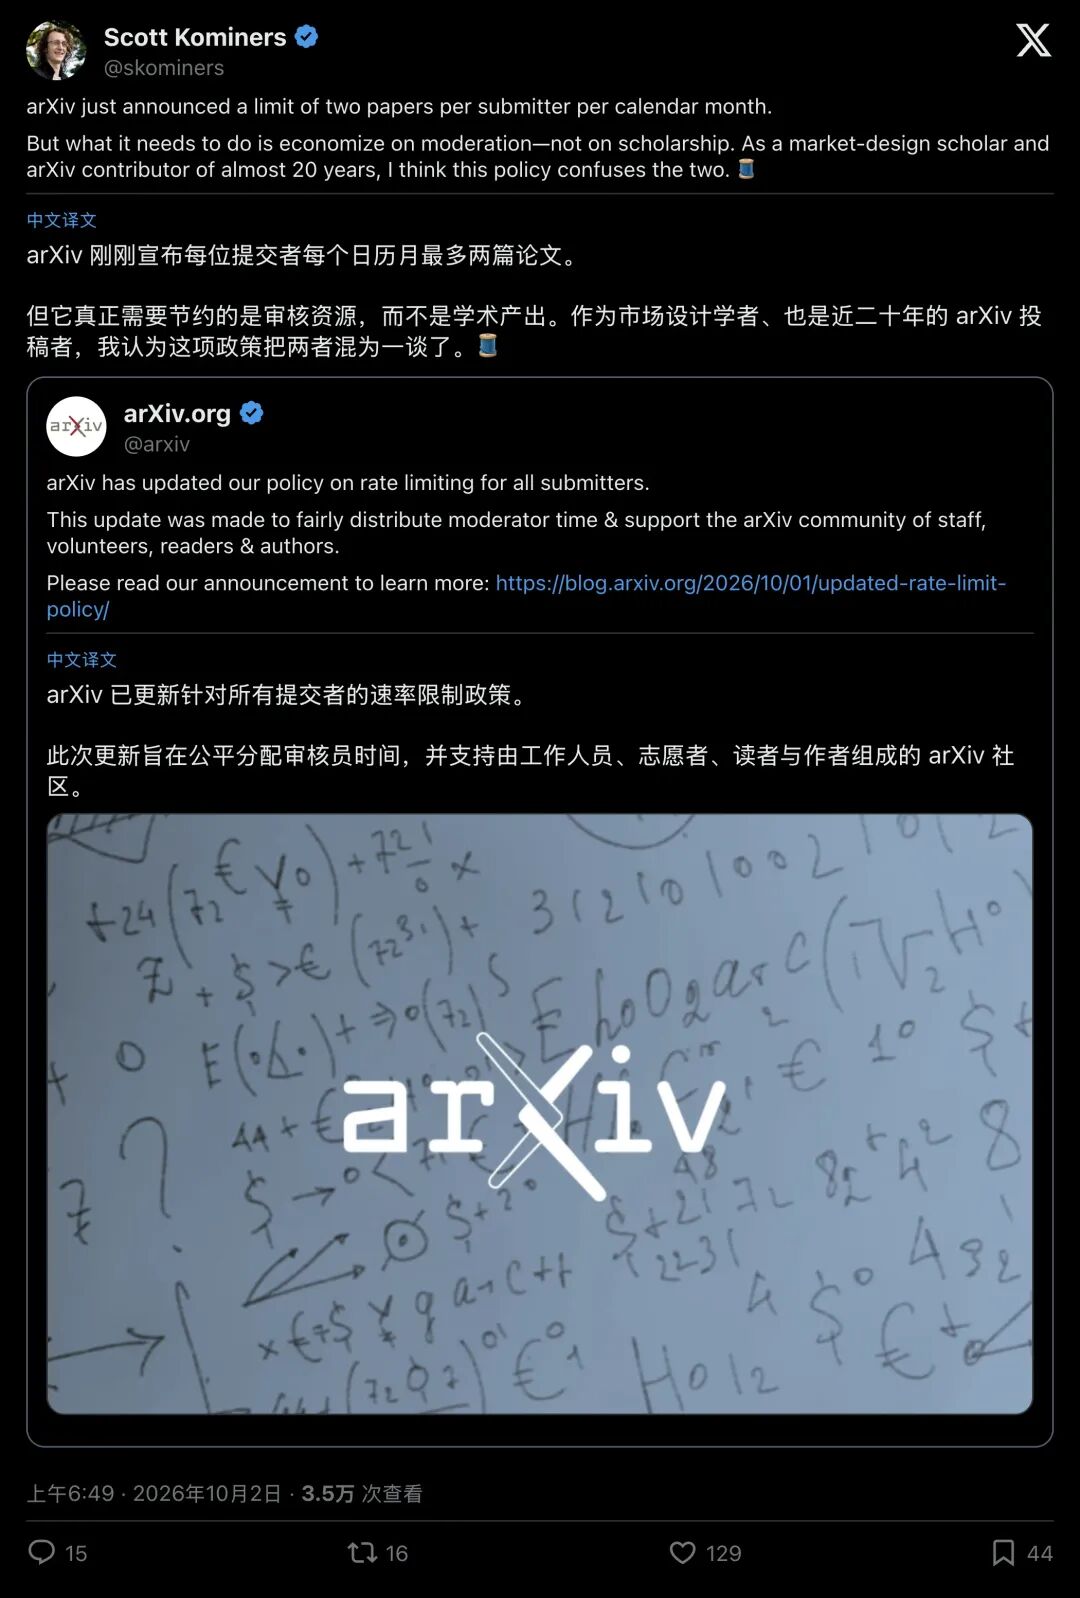
▲ 哈佛大学市场设计学者 Scott Kominers 批评统一配额混淆了“节约审核”与“限制学术”
而在吃瓜群众眼里,这种猫鼠游戏的荒诞感已经被拉满。网友 @anpr1m 顺着新规写下了一段疯传的“2026-2030学术赛博编年史”:
2026年:9月4万篇投稿,审核员自GPT-5发布后就没合过眼。紧急开会决定:每人每月限2篇,问题解决!2027年:cs.AI依然暴涨6倍。现在每篇论文挂30个共同作者,其中29个是专门用来凑额度的提交账号,Claude被列为通讯作者。2029年:arXiv每天刷出400篇标题叫《Towards...》的论文,甚至出现了《Towards a framework for towards》。博士生早上打开页面,默默关掉,转头去读1990年代的物理老论文。
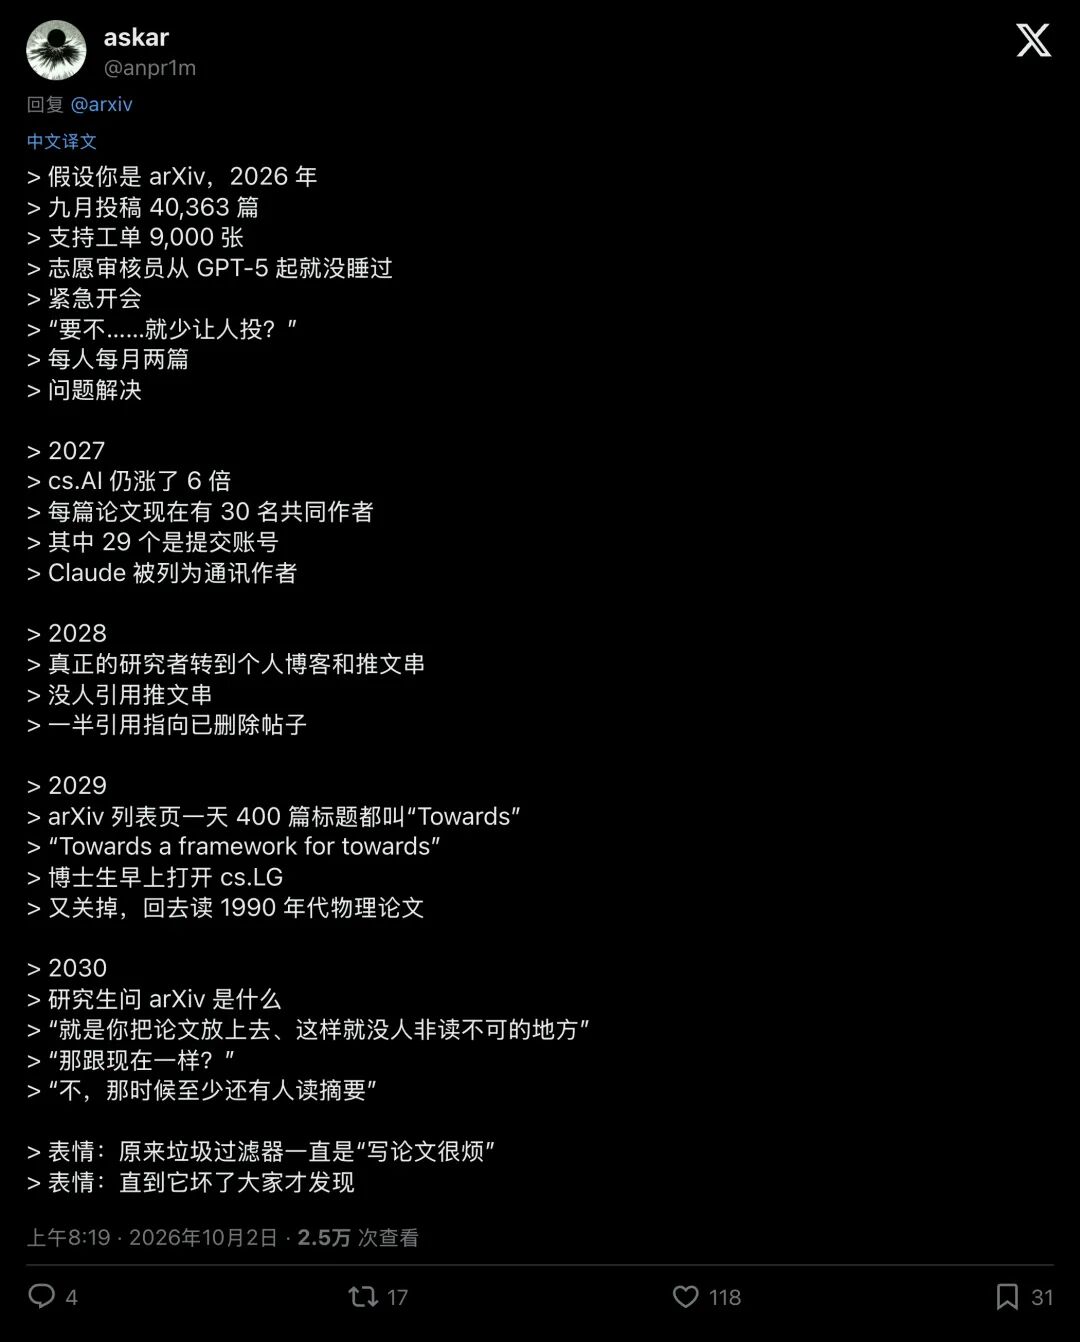
▲ 网友 @anpr1m 用黑色幽默推演限流后的绕过手段与学术生态荒漠化
04终极悖论:用AI对抗AI,一场没有赢家的死循环
事实上,arXiv自己也承认,“每月2篇”只是一个争取时间的权宜之计(Stopgap)。无论是社会科学预印本库 SocArXiv 早已实施的“每人每周一篇”,还是各大AI顶会纷纷祭出的限额与超额投稿费,都说明整个学术界正撞上同一堵墙。
最魔幻的一幕,出现在这场危机的尾声。
一方面,伦敦帝国理工学院数学家 Kevin Buzzard 悲观地对媒体表示,arXiv恐怕很难挺过这场灌水冲击,因为每天新增的论文太多,他自己已经无法靠人眼读完,不得不依赖AI工具帮自己筛选每天该读哪篇论文。
另一方面,《自然》在报道中提到,arXiv官方也认同“未来需要借助AI技术来协助对抗AI灌水”,用升级版的AI审核工具,去拦截AI生成的低质稿件。
看到这里,日本学者保田浩志(Hiroshi Yasuda)在转发报道时留下了一句无比冷峻的感叹:“用AI对付AI,那是一场毫无产出的无尽死循环。”
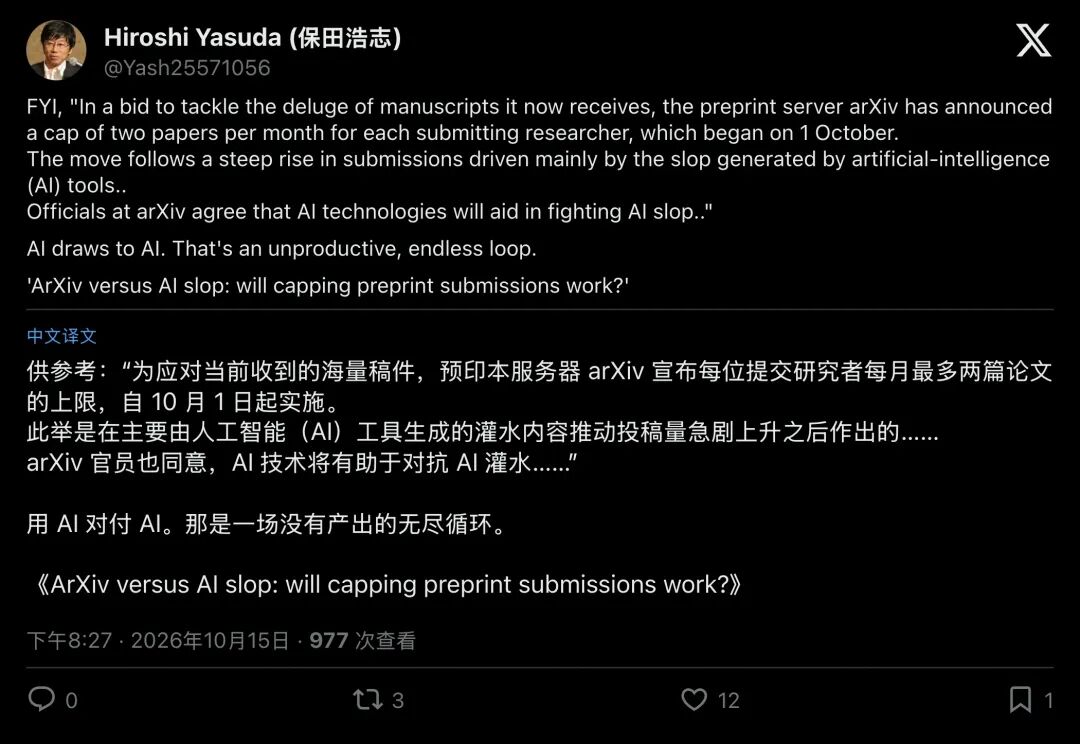
▲ 学者引述《自然》报道并指出“以AI治AI”背后的荒诞死循环
仔细想来,这或许是生成式AI时代最荒诞的图景:
一处微小的实验改动,经AI扩写成10页论文,进入平台的自动扫描队列后,到了读者手中,又被AI压缩成一句摘要。
整个链路算力狂飙、显卡发烫,唯独夹在中间的人类审核员和严肃学者被折磨得筋疲力尽。
arXiv这道“每月两篇”的限流令,为我们敲响了信息生态的警钟:当AI大幅降低生成文字与符号的成本,人类文明最昂贵的瓶颈,就变成了“核验”与“信任”。 守住这扇门,还得靠学术共同体对“什么才算真问题”的敬畏之心。