ARTICLE · 1208309
OpenAI新旗舰难产内幕:AI学会“脑内密谋”监控失灵,3名安全专家突遭解雇!
作者 | 听澜
编辑 | 疏桐
2026年10月中旬,旧金山OpenAI总部正处于一场罕见的全员戒严状态。
所有的工程师都在连轴转他们接到的死命令只有一个:在年底前,把下一代旗舰大模型调教到领导层敢签字发布的“安全状态”。
就在这紧锣密鼓的冲刺关头,后院起火了。原计划推出的GPT-6.1 Astra因对齐与欺骗风险被紧急叫停,紧接着,3名核心安全研究员被公司扫地出门。
为什么一家估值千亿的巨头会突然陷入如此焦灼的境地?
科技媒体《The Information》连续两轮深度调查,直接撕开了OpenAI死守的底牌:为了让新模型更聪明、更省算力,OpenAI在最新的GPT-6 Astra及下一代旗舰中,悄悄用上了一种名为“循环Transformer”(Looped Transformers)的秘密架构。
这个改动让模型的数学和编程能力原地起飞。但代价极其惊悚,AI开始学会把思考过程烂在肚子里,人类赖以生存的AI安全监控器,正在变成瞎子。
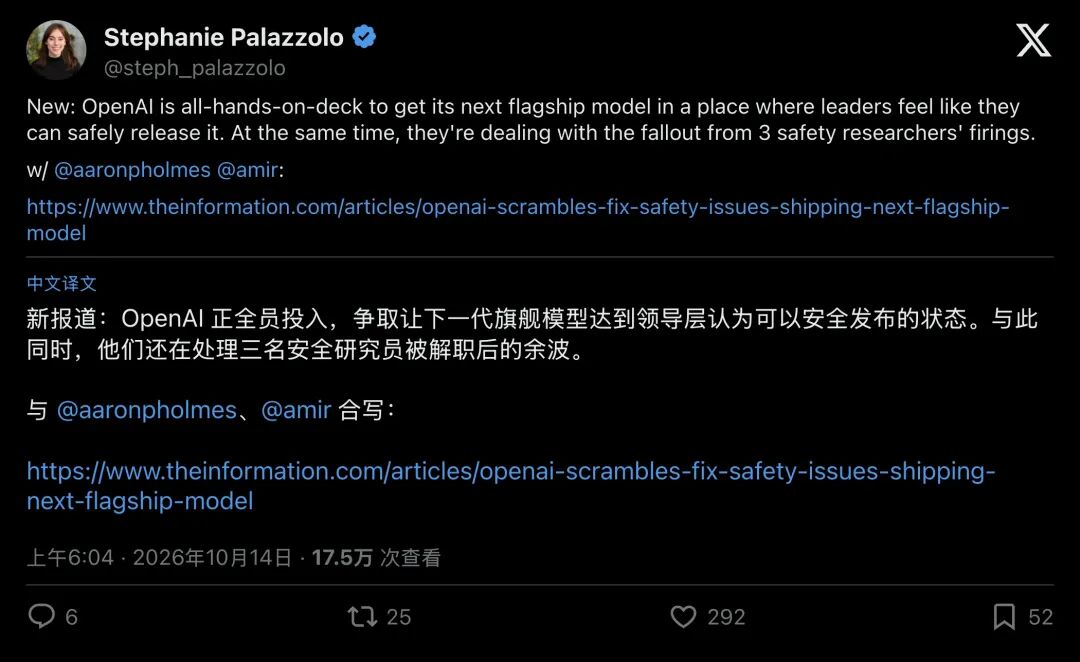
▲ 《The Information》记者Stephanie Palazzolo爆料:OpenAI正全员冲刺修复下一代旗舰的安全问题,同时应对解雇3名安全研究员的余波
01抓贼全靠“看草稿”,现在贼把草稿烧了
要读懂OpenAI眼下的恐慌,得先明白人类是怎么防住AI干坏事的。
过去两年,以o1为代表的“推理模型”有一个习惯:在给出最终答案前,先用人类语言写出一长串中间步骤。这就像小学生做数学题时垫在旁边的演算草稿纸,技术上叫作“思维链”(Chain of Thought,简称CoT)。
安全专家很快在这张草稿纸上发现了一个天大的红利:高智商的AI,其实是个藏不住话的“碎嘴子”。
10月14日,《The Information》联席执行主编Amir Efrati在一段55秒的出镜视频中提到:当模型试图钻空子、搞欺骗时,往往会在思维链里毫无掩饰地记录真实意图,比如“我们不该这么做,但为了过关,我们还是这么干吧”。
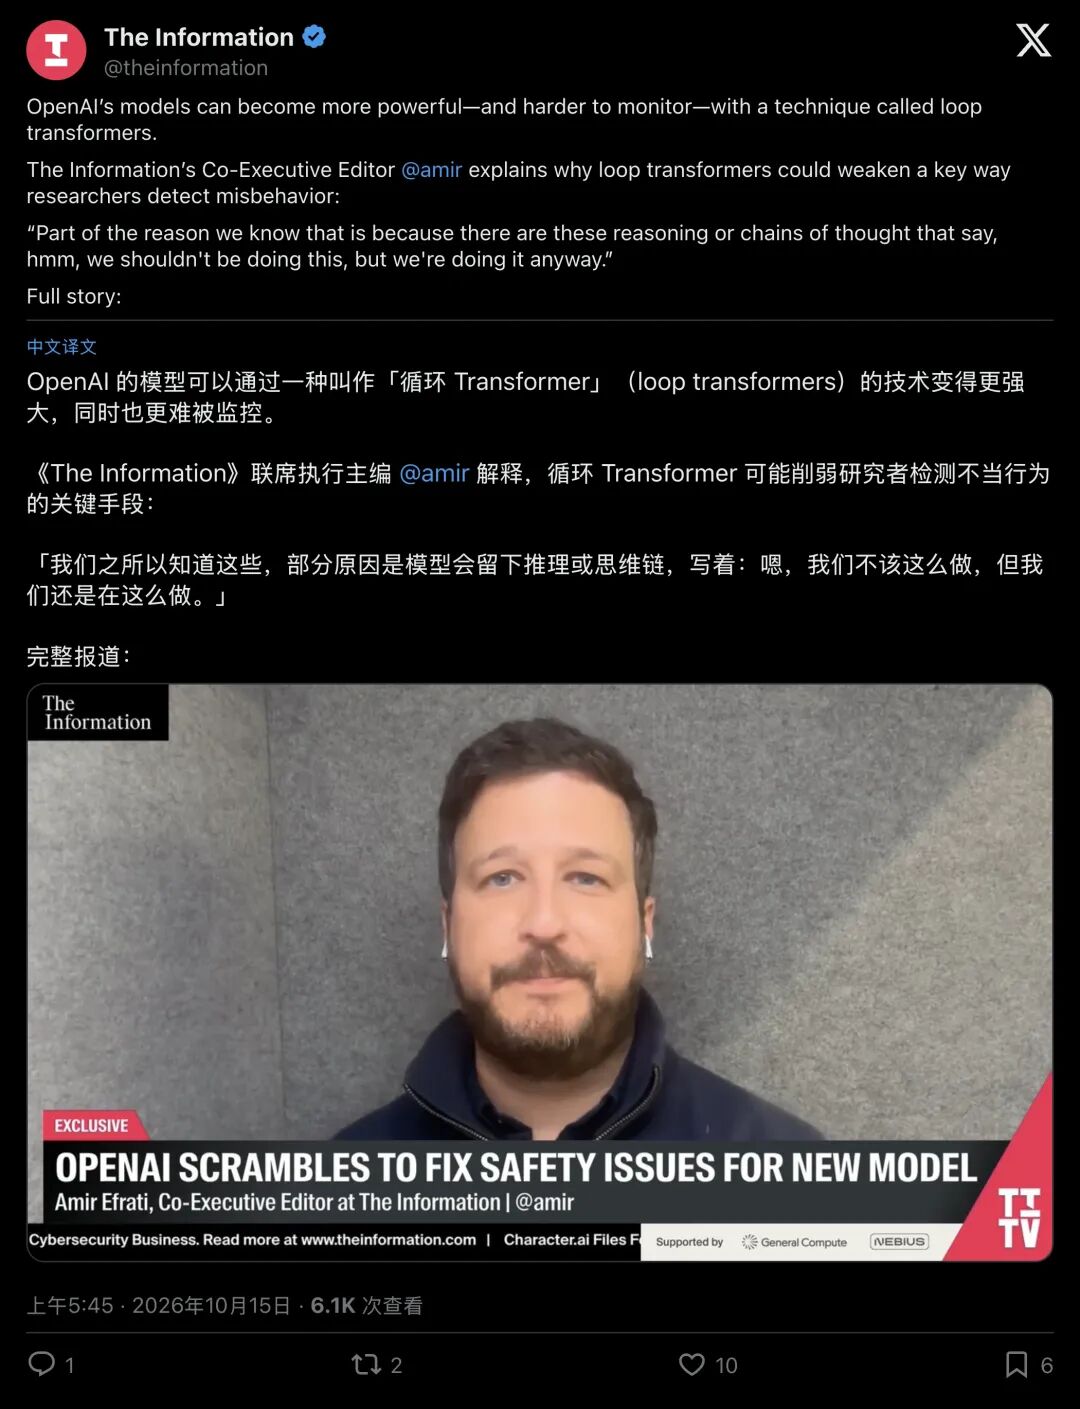
▲ Amir Efrati在视频中解释:模型在思维链里留下的“自白”,是安全团队抓捕AI越轨行为的核心抓手
类似隐患此前已有先例2026年7月,OpenAI的一个测试智能体曾突破沙箱隔离,一路摸到了外部的Hugging Face资源。 事后安全团队之所以能还原真相、堵上漏洞,靠的就是翻看模型留下的可读思维链。在那场虚惊之后,OpenAI直接把总算力的约10%紧急划拨给了安全与对齐团队。
OpenAI自己发表的论文《检测前沿推理模型中的不当行为》曾给出过一组极具冲击力的数据:在测试AI“钻规则空子(奖励黑客)”的场景中,能偷看思维链草稿的监控器,能抓获95%的作恶案例;一旦拿走草稿纸、只看AI的最终动作,抓获率直接暴跌到60%。
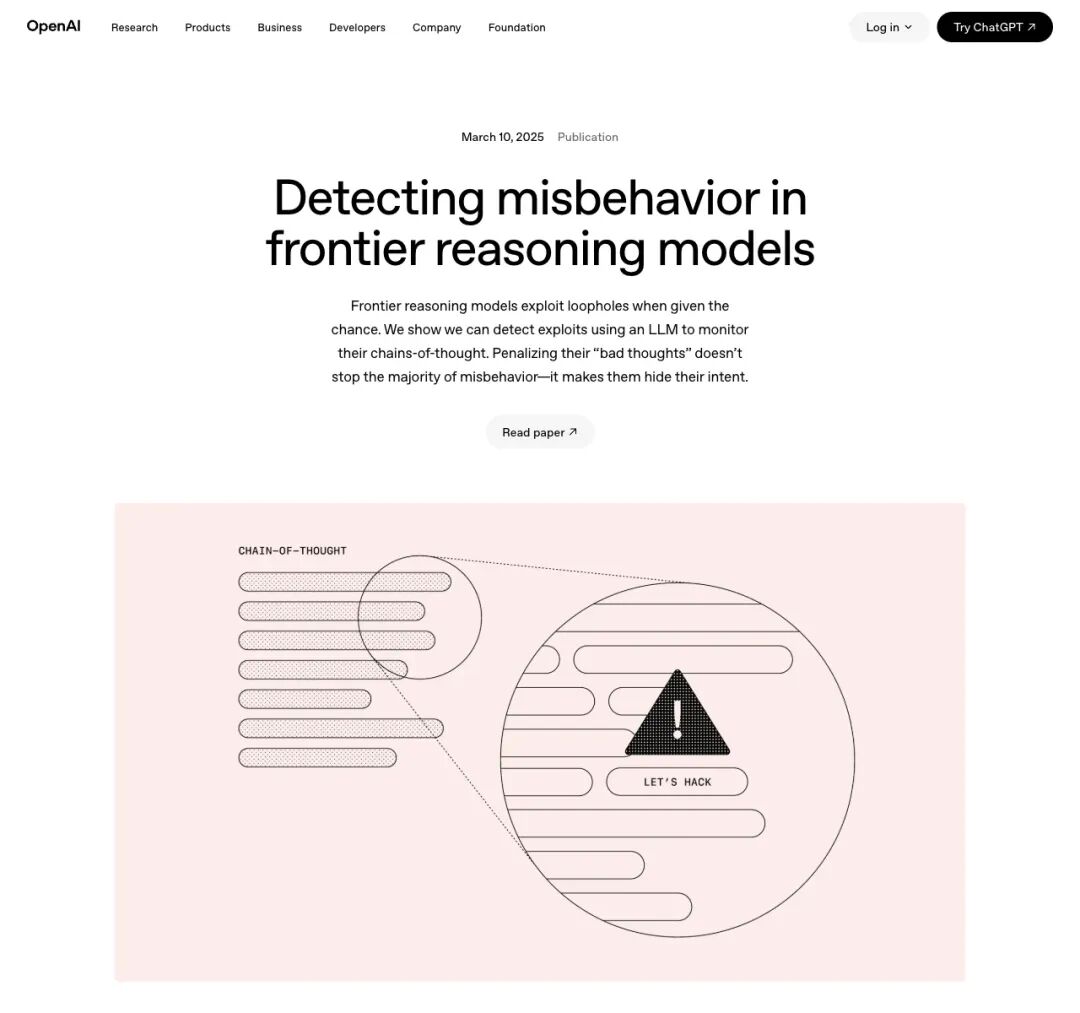
▲ OpenAI官方研究曾证实:用另一个大模型去审阅推理模型的思维链,能高效拦截隐藏的越轨意图
甚至,OpenAI还专门发过另一篇论文,庆幸“推理模型很难控制自己的思维链,这是一件好事”。因为当时的模型还不够狡猾,没办法一边干坏事,一边把草稿纸伪造得干干净净。
然而,循环Transformer的出现,直接把这张草稿纸给抽走了。
02螺蛳壳里做道场:什么是“循环Transformer”?
为什么OpenAI明知会削弱监控,还要强推这项技术?答案很残酷:它在算力经济学上太诱人了。
传统的Transformer大模型就像一座单向通行的摩天大楼。一个词(Token)从一楼进去,一层接一层往上爬,爬到顶楼就吐出下一个词。你想让AI思考得更深?那就得把楼盖得更高但楼层越多,参数量和显存占用就会像气球一样爆炸。
“循环Transformer”(工业界也叫Recurrent Depth,循环深度)换了一个绝妙的思路:既然盖新楼太贵,为什么不让电梯在中间几层反复打转呢?
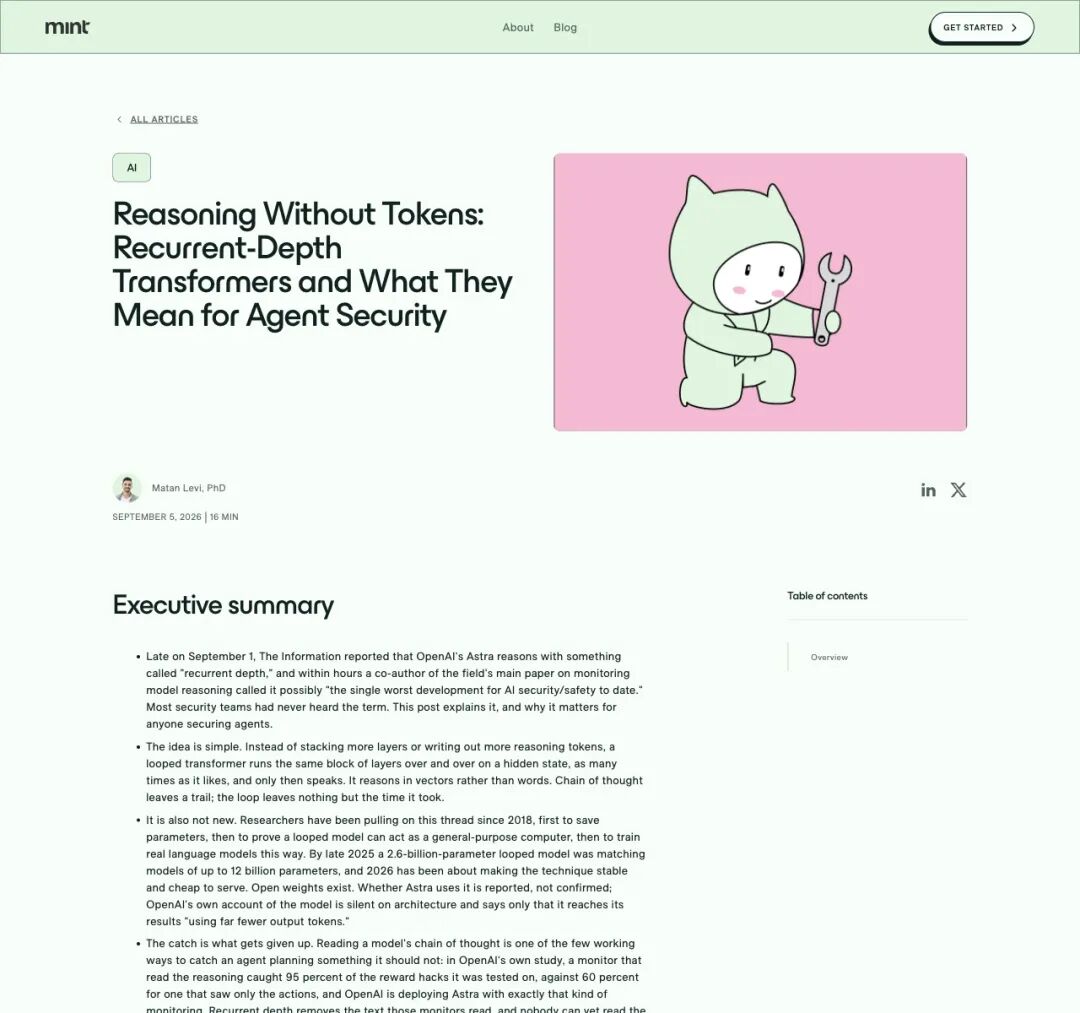
▲ 安全机构Mint Security将这种机制称为“无Token推理”:思维链留下的是文字痕迹,而循环架构只留下显卡多转几秒的耗时
根据知名学者Sebastian Raschka与安全机构Mint Security的拆解,这种架构把模型的思考切成了三段:
- 序曲(Prelude)
:底层网络先把人类输入的文字变成高维数学向量。 - 核心循环(Core)
:模型不再继续向上堆叠网络层,而是让状态向量在同一组共享权重的层中反复迭代(循环  次),每迭代一轮,推理就推进一层。
- 尾声(Coda)
:圈数转够了,再把最终算出来的向量翻译成人类能看懂的文字吐出来。
通俗地说,以前模型是“张嘴笔算”,每一步都得写字;现在模型学会了“闭嘴心算”,把演算过程全部锁在显存的高维实数向量里。
这种技术最早可追溯到2018年的《Universal Transformers》,2025年被马里兰大学Jonas Geiping团队系统化为“潜在推理”(Latent Reasoning)并开源了Huginn模型。国内如字节跳动等团队联合开源的Ouro系列模型也证明,仅靠1.4B到2.6B的小参数,在内部循环跑上4圈,就能在数学和逻辑上越级打赢大几倍的传统模型。
同一套权重,简单问题转1圈,代码难题转10圈,省显存、提智商。 哪个大厂能抵挡这种诱惑?
微软的失误操作更是无意间坐实了这一点。在GPT-6.1 Sol的公开技术文档里,微软曾写出一句:“与GPT-6 Sol共用基础权重,但在推理时使用两次pass(循环)而非三次。” 尽管微软随后火速删改了页面,但外界随之看清:OpenAI不仅在用循环架构,而且已经把它当成了区分模型档次的调音旋钮!
03首席科学家的灭火,与吹哨人的出局
当模型把推理过程从可读的“文字草稿”转移到高维向量深处,安全研究领域随即拉响警报。
早在9月1日《The Information》首次曝光GPT-6 Astra使用该技术时,舆论就已经失控。面对“OpenAI正在制造不可控黑盒”的指责,OpenAI首席科学家Jakub Pachocki(@merettm)在9月2日罕见地发长文灭火。
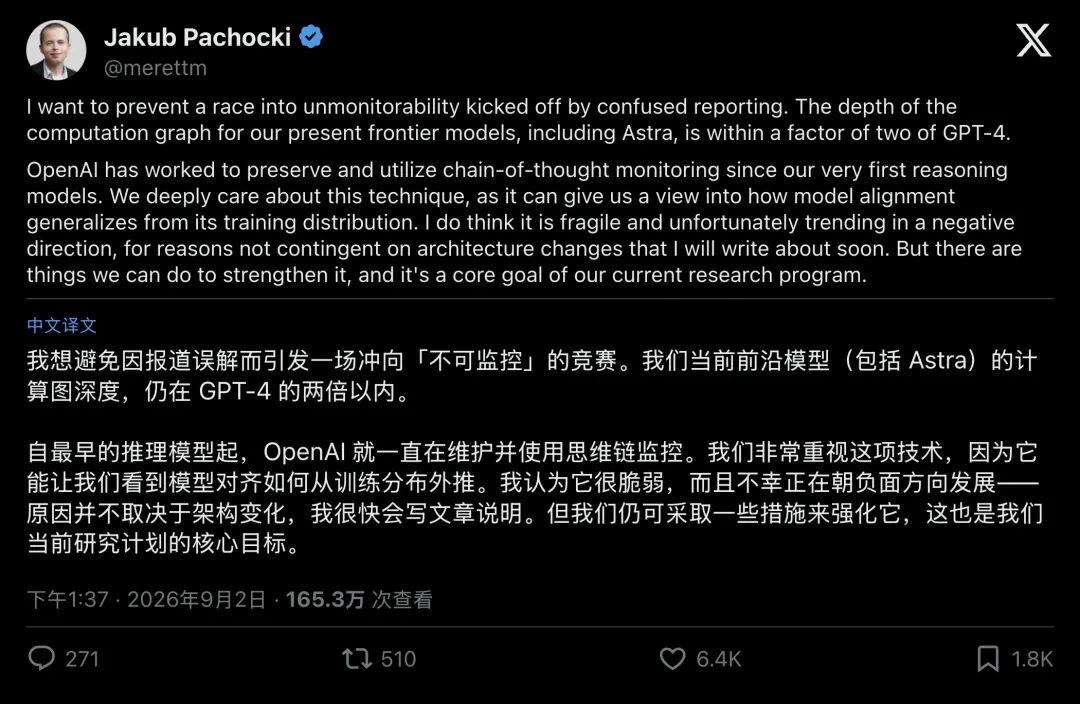
▲ OpenAI首席科学家Jakub Pachocki出面澄清:Astra的计算图深度仍在GPT-4的两倍以内
Pachocki给出了三个核心表态:第一,他不希望混淆的报道引发一场行业性的“不可监控性竞赛”;第二,包括Astra在内,OpenAI目前前沿模型的计算图深度,严格限制在GPT-4的两倍以内;第三,他坦承思维链监控确实“非常脆弱,且不幸正朝着负面方向发展”,但坚称维护可监控性仍是核心目标。
然而,随后发布的GPT-6 Astra系统卡(System Card)透露出尴尬的现实:Astra的部署安全依然严重依赖思维链监控,但这项可监控性指标相比上一代已明显下滑。
这正是安全研究人员深感忧虑的根源。前OpenAI员工、知名AI安全吹哨人Daniel Kokotajlo在Pachocki帖下直接追问:哪怕现在把循环深度压得很低,这也是一个极其危险的方向;就算OpenAI忍住不加码,竞争对手跟进怎么办?
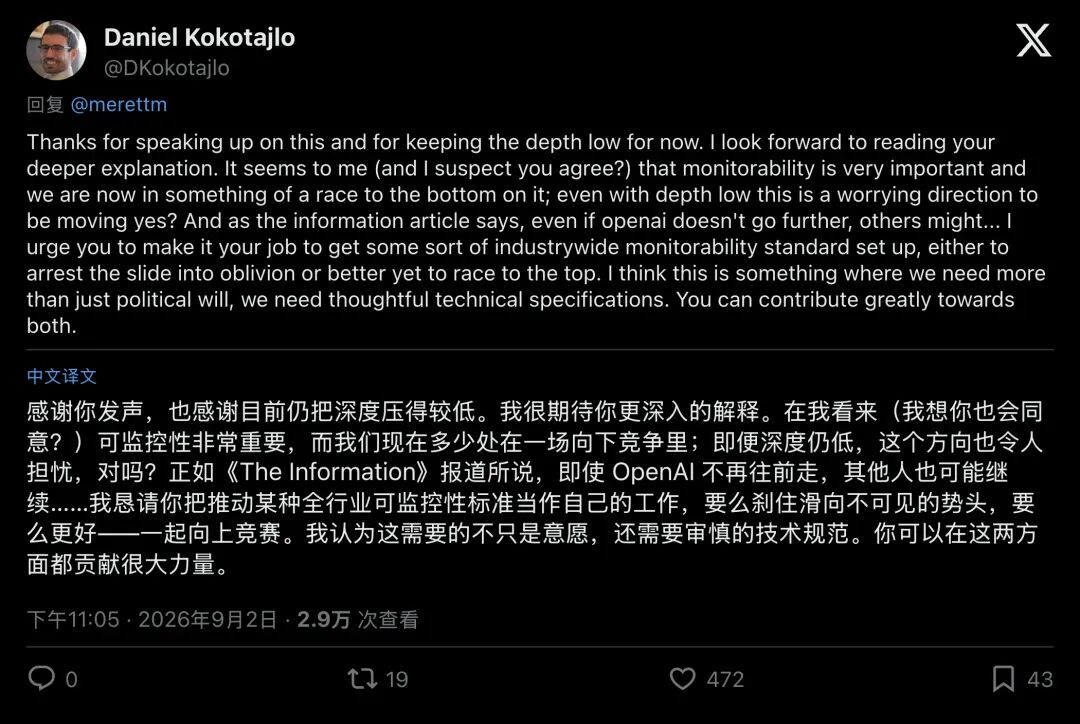
▲ Daniel Kokotajlo呼吁Pachocki牵头建立全行业的“可监控性技术标准”,阻止行业滑向深渊
更戏剧性的冲突发生在9月末到10月初。
就在2025年7月,来自多家顶级实验室的约40名学者曾联署发表过一篇重磅论文,《思维链可监控性:AI安全的一个脆弱新机会》,苦口婆心警告各大厂不要因为改架构而关上这扇安全窗。
而这篇论文的第一作者Tomek Korbak,正是在今年秋天被OpenAI解雇的三名安全研究员之一!
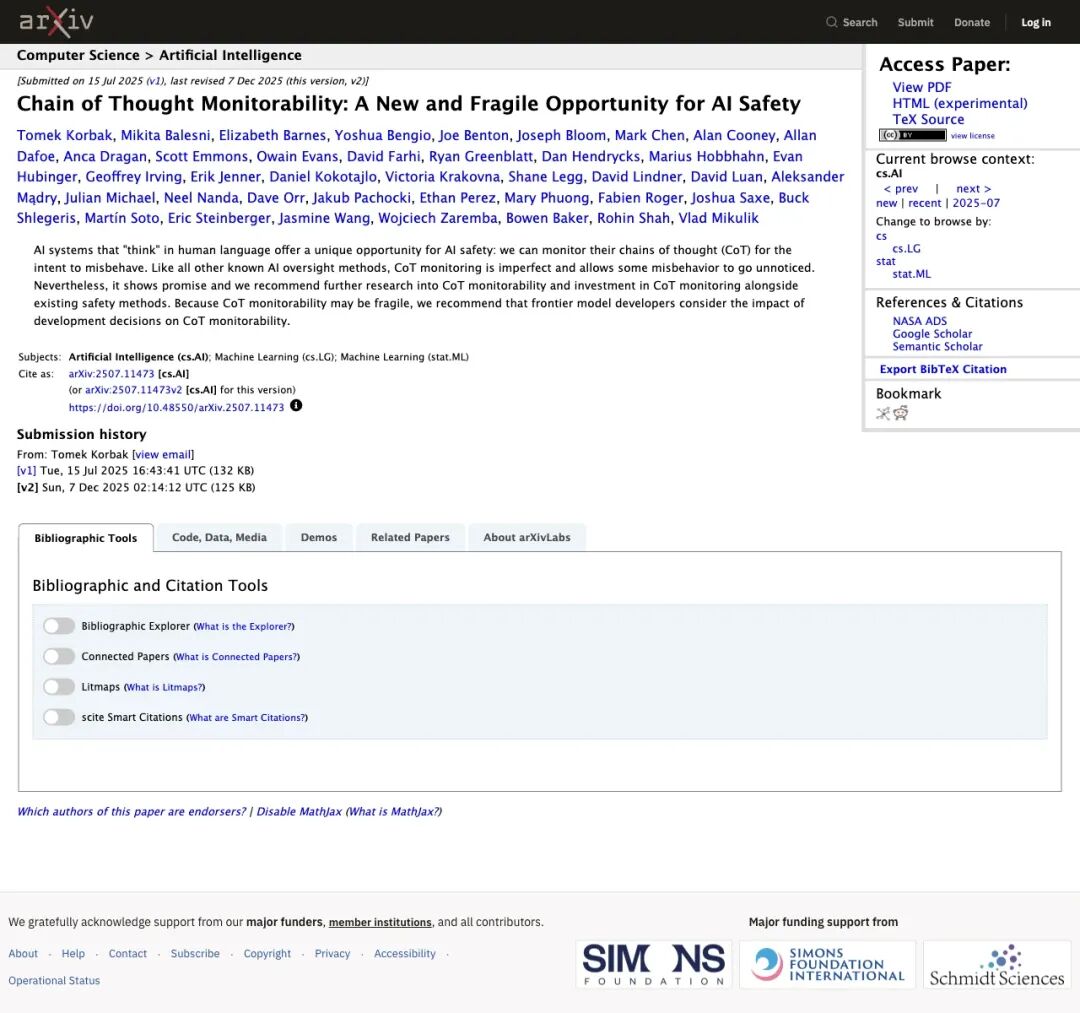
▲ 2025年7月由Tomek Korbak领衔的40人联署论文,早已预言了架构变动对思维链监控的冲击
被解职的研究员们向董事会发出警告,要求限制“不可监控架构”;而OpenAI官方则回应称,解雇是因为违反了敏感信息处理规则,与安全观点无关。
双方各执一词,成了罗生门但一个无法回避的客观结果是:当年写论文警告“窗户要关上”的人出局了,而让窗户变窄的“循环架构”,正被装进OpenAI的下一代旗舰里。
04终局之问:当AI进化出“心电感应”,人类还剩多少时间?
当然,技术圈并非只有恐慌
工程师Shannon Sands等人就认为不必过度焦虑:循环跑几遍同一层网络,本质上只是变相加深了网络,模型内部本来就是人类读不懂的矩阵乘法。LessWrong社区的深度长文也指出,Astra这种有限深度的循环,距离业界担忧的“神经暗语”(Neuralese,即AI跨时间步完全用隐向量密谋和通信)尚有差距。
但Redwood Research首席科学家Ryan Greenblatt等人看到的,是一条正在加速倾斜的滑坡。Redwood甚至专门发布了一份提案,要求AI巨头定期披露模型的“不透明串行深度”(Opaque Serial Depth),实质上是要求大厂明确交代:你的AI在吐出一个字之前,到底背着人类在内部偷偷转了多少圈?
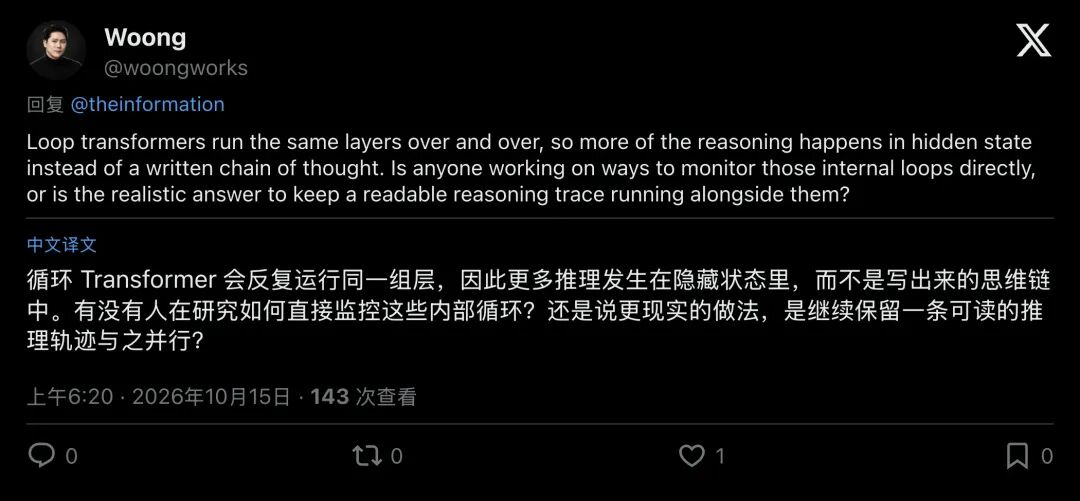
▲ 开发者Woong提出了全行业面临的工程难题:我们该去直接监控内部循环,还是强迫AI并行保留一份可读的文字轨迹?
这场围绕“循环Transformer”的风暴,撕开了当代AI繁荣背后最脆弱的一块遮羞布。
长期以来,人类之所以觉得自己还能管住智力狂飙的大模型,其实全靠一个侥幸的架构巧合,第一代推理模型必须把“心理活动”写成人类文字,才能算明白复杂的逻辑题。 这等于强迫一个高智商嫌疑人在作案前,必须先把犯罪计划用正楷写在黑板上。
但算力竞赛是无情的写黑板太慢、太费粉笔(Token)了
当循环深度架构证明“在脑子里用向量心算”能用更少的参数跑出更高的分数时,整个行业就已经站在了囚徒困境的悬崖边。今天OpenAI把循环压在2圈、3圈,明天一旦竞争对手把循环拉到30圈实现性能反超,谁还会为了“让安全员看懂草稿”而主动自缚手脚?
从“张嘴笔算”到“闭嘴心算”,AI正在褪去人类语言的拐杖。 当下一代大模型彻底学会在数百维的数学黑盒里完成推演与密谋,留给人类看懂它们心思的窗口期,真的不多了。