ARTICLE · 1213580
12 万星之后,软件公司还剩下什么护城河
摘要
代码保密正在贬值,但闭源软件不会因为这一轮逆向就活不下去——护城河从代码搬到了别的地方。
引言
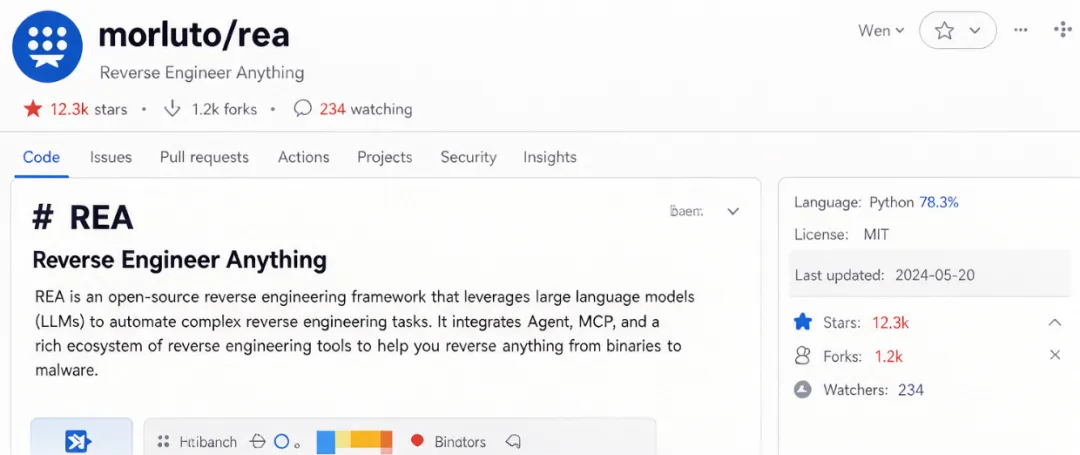
10 月 12 日,GitHub 上一个叫 REA 的仓库,星标冲到 12 万。全称是 Reverse Engineer Anything,逆向一切。同一周,一位开发者用 Claude 把 Adobe 的七款软件逆向重写成 Rust 版,全部开源——起因是他被 Adobe 的退订违约金恶心到了。
于是"闭源要完"的声音又起来了。我盯着这事想了几天,觉得这个判断下得太满。软件公司到底靠什么活着,这件事可能比"开源还是闭源"更值得问。
先把两个词钉住。这里说的"闭源",指代码不公开,不是指软件不收费——这两件事经常被搅在一起,其实是两个问题。还有,"终结"指的是闭源软件公司活不下去、没人再敢做闭源。至于闭源模式的市场份额会不会被开源一点点挤走,这里就不展开了。
REA 到底干了什么
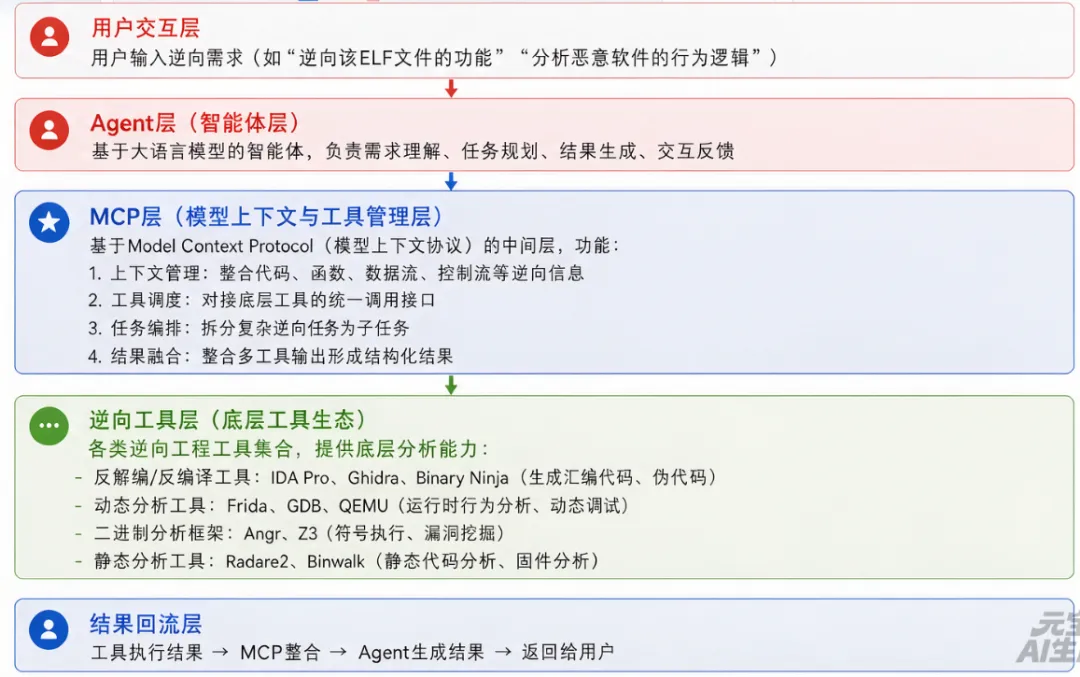
它本身不写代码,做的是接线。用 Claude Code、Codex 这类编程智能体,通过 MCP 接入 Ghidra、Hopper、IDA 这些逆向工具,让 Agent 去分析没有源码的软件,追踪某个功能的实现线索,再试着写出相似功能。
覆盖范围比想象中宽:原生应用的 Mach-O、ELF、PE 格式,macOS 的 .app 包(连 Swift、Objective-C 元数据都能读),zip、apk、ipa、asar 这类程序包,甚至不解压就能生成文件清单。Electron 和 JavaScript 应用、网站请求也在射程内。
过去闭源的安全感来自三重防线:代码混淆、动态加密、二进制加固。传统反编译出来的伪代码像一本被撕碎又胡乱拼回去的书,逻辑混乱、变量名全丢,没受过多年训练根本读不下去。大模型把这道门槛削掉了大半。
能拆是一回事,该不该拆是另一回事。工具本身中立,不等于使用方式中立。REA 是 MIT 协议的开源工具,工具本身合法。但拿它去处理别人的商业软件,各国司法认定并不一致——要看有没有绕过技术保护措施、是否构成实质性相似。这不是一个"学会用就能用"的问题。
顺带说一句,星标数这个指标本身也在通胀。公开报道里 OpenClaw 的星标已经到三十几万量级,而长期占据榜首的往往是资源汇总、教程、书单类仓库。点星是介于收藏、点赞与已读之间的低成本表态。12 万星说明的是注意力强度,不等于技术壁垒强度。
它拆的是技术护城河,不是商业护城河
一个软件公司真正的家底,往往不在那几万行核心算法里。
REA 能帮一个开发者搞明白"Notes 的搜索是怎么实现的",但复制不出 Notes 背后的账号体系、云同步基础设施和十年用户数据。格式与生态、合规采购、持续迭代的节奏、品牌信任——这些东西的价值都不在二进制文件里,而在你和用户之间那条拆不开的关系里。
比被替代更麻烦的一种冲击,是被稀释。当抄一个套壳的成本降到很低,市场上会冒出一堆劣质仿品,用户分不清谁是谁,整个品类的信任被拉低。这种伤害不体现在营收表上,但更难修复——你守得住自己的产品,守不住别人拿你的名字去骗人。反过来说,这正是品牌和渠道辨识度比代码更值得投的原因。
还要分清一件事:上面说的是闭源软件——代码不公开,但公司靠生态、服务、关系活着。闭源模型是另一回事。模型的护城河就是模型本身,权重不公开、API 按量收费,一旦开源模型能力追平,这层溢价会被压得很薄。所以"闭源会不会终结"得分开问:闭源软件不会,闭源模型的处境要难得多。
两个被人抄走过、但没被抄垮的案例
先说这两个东西是干什么的。Elasticsearch 是企业里搜数据用的引擎——很多公司的内部搜索、日志分析系统,后面干活的就是它。Redis 是应用里的缓存数据库——你打开一个 App 秒开不转圈,背后常有它在顶着。都是行业里离了不好过的工具。
这一节要说的不是"代码被偷了会怎样",而是反过来:代码全公开、谁都能拿走,生意还在不在?因为代码全公开、谁都能拿,是比被逆向更严苛的处境——连文档、设计讨论、完整源码都摊在那儿了。如果连这种局面都没死,那"被抄"就更不是死路。
Elasticsearch 和 AWS 那一仗。它原来的协议基本等于"随便用、随便改、甚至拿去卖钱都行"。2021 年 1 月,Elastic 把协议改了,意思变成"你还能用,但不能靠卖它的服务赚钱"——专门堵住云厂商拿它做托管服务收费这条路。AWS 没跟它谈,抢在新协议生效前复制了一份代码,另起一个名字叫 OpenSearch,自己接着做,还拉上红帽、SAP、Capital One 站台。技术圈管这叫"分叉"。
按"代码被拿走就完了"的逻辑,Elastic 该输。但三年后,2024 年 8 月,Elastic 把协议又改了回来、重新开源,创始人 Shay Banon 说"我们不再生活在过去",两家后来还成了合作伙伴。OpenSearch 那边下载量破了 1 亿,496 名贡献者提交了 8760 个拉取请求——活得不错,但也没把 Elastic 干掉。代码被完整拿走,Elastic 的生意没塌。
Redis 那一仗更直接。2024 年 3 月它改了协议,一周之内 Linux 基金会就带人另起了一个叫 Valkey 的项目,AWS、Google Cloud、Oracle 全站对面。开源项目靠全世界的志愿贡献者提交代码,谁提交得多、审得严,谁就说话算数——排名第二的那个人直接跳船,等于半根顶梁柱走了。按理说这是最惨的局面:顶梁柱走了、代码全被复制、巨头全站对面。但 Redis 公司靠 Cloud 和商业版活了下来,2026 年还在跟 AWS 扩大合作。代码被搬空了一半人,生意没塌。
这两个案例还有另一半,容易被漏掉:对 Elastic 和 Redis 是"活下来了",对 OpenSearch 和 Valkey 是"白捡一个成熟产品的起点"。老公司没死,但这条赛道的进入门槛被削平了——后来者不用从零写起。
开源和闭源的分野,跟技术无关
卓克在《科技参考》里给过一个很干净的判断:不是中国擅长开源、美国擅长闭源,跟国别没关系——领先者更适合闭源,挑战者更适合开源。中国企业普遍处在挑战者位置,开源对它最有利;顶尖巨头用闭源能赚到最高利益,所以它们闭源。
按这个框架看 REA,能解释的是:它冲击的是靠代码保密维持溢价的中间层软件,冲击不了靠规模效应、网络效应和生态锁定赚钱的头部。
方向也未必单向。谷歌前 CEO 给过一个相反的预测:当模型训练成本再上一个量级,能承担开源成本的企业会消失,闭源反而可能成为主流。吴恩达的判断类似——开源模型能力提升会极度压缩闭源模型的溢价空间,中间层模型公司可能因收不回成本而倒闭,但应用层和推理层不仅没泡沫,甚至是投资不足的。
还有一层容易被漏掉:开源的胜利不等于免费的胜利。阿里的路径很典型——千问模型免费开源,但你要训练、微调、推理,就得买算力,开源引流,云服务收钱。开源铺得越广,云收益越大。开源改变的是定价方式,不是消灭了收费这件事。
这套逻辑不只属于软件行业
AI 已经能模仿一个人的写法。你写什么腔调它跟着学,你怎么起承转合它照着来。但复制不了的是信源——谁愿意第一时间告诉我,谁只肯把话说给我听;也复制不了读者关系——一个读者读完某篇会立刻转给谁。这两样都长在关系里,不长在文本里。
制造业也一样。图纸可以逆向,工艺参数可以摸索,但供应链上那个"知道我急、能给我插单"的老关系,拆不开,也搬不走。
收尾
判断城墙和城,有个比"技术还是关系"更好用的尺子:代码能不能被单独搬走。能搬走的是城墙,搬不走的是城。同样是 API 接口,接口代码可以抄走,但客户把工作流建在你这个接口上的那部分投入,抄不走。
REA 不是答案,它只是把问题提前了。技术保密能撑起的溢价正在变薄,而格式与生态、合规、服务、数据这几样东西的价值,反而在往上走。
护城河在关系上,那就把客户的工作流接深、服务响应做快、合规资质拿全。
真要动手,可以先做一件小事:把你手里最值钱的三样东西列出来,挨个问一句——如果竞争对手明天抄走了我的代码,这三样里还剩哪样?剩下的那些,才是接下来该加码的地方。
下次你看到又一个"某某要完"的判断,可以先问一句:被拆掉的是城墙,还是城。