ARTICLE · 1215167
老板让你把 100 份 PDF 报告变成可编辑 Markdown?手动抄 1 周,这个 40k star 的开源工具 10 分钟搞定
老板甩你 100 份 PDF 报告:"明天把内容整理到我们 wiki 上,Word 排版好。"
你手动抄?一周过去了,还在抄第 30 份。眼睛花了,Ctrl+C/V 键位快磨平了。
GitHub 40,406 star 的 datalab-to/marker 给出了解法:
PDF / image / PPTX / DOCX / XLSX / HTML / EPUB → markdown / JSON / chunks — 76% 综合准确率 / 83.5% 数字 PDF(olmocr-bench 第三方基准),超过 MinerU + docling,Apache-2.0 随便商用。
100 份 PDF → 10 分钟跑完 → 拿到结构化 markdown + JSON。今天拆给你看。
datalab-to/marker(作者 VikParuchuri,也是 Surya OCR / Chandra 创始人)是个 Python 文档解析框架。
核心能力(README 自述):
• 支持格式:PDF + image + PPTX + DOCX + XLSX + HTML + EPUB(全语言) • 输出格式:markdown / JSON / HTML / chunks(供 RAG 检索) • 保留元素:表格 / 公式 / 内联数学 / 链接 / 引用 / 代码块 / 图片 • 清理:自动去页眉页脚 / 杂乱水印 • 可扩展:你可以加自己的 formatter 和 processor • 可加 LLM 提精度:接 Claude / GPT / Gemini / Ollama(本地)都行
2 行代码起步:
pip install marker-pdfmarker_single file.pdf # 跑完输出 file.md + file/40,406 star / 2,921 fork / 3 年前创建 / Apache-2.0 / Python / 3 modes(balanced / fast / fast-no-OCR)——完全能装在雷哥机器上,离线也能跑。
痛点深扒:为什么 PDF 这么难转
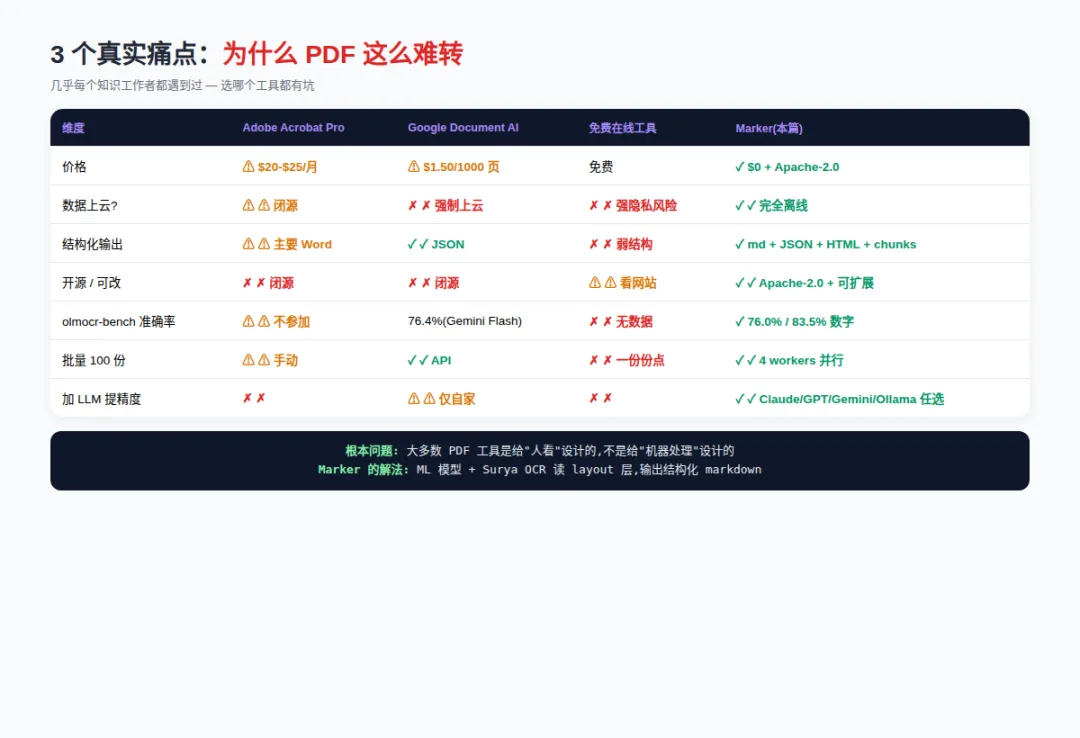
3 个真实痛点(几乎每个知识工作者都遇到过):
1. 选 Adobe Acrobat Pro?
• 收费 $20/月(个人版)+ $25/月(团队版) • 不擅长结构化输出——导出的 Word 还是 Word,你要 markdown 它不懂 • 不开源——批量处理要写 VBA 宏或 PDF API,踩坑多 • 闭源,企业内部审计、合规、二次开发都受限
2. 选 Google Document AI / Nanonets / Textract?
• 按量计费—— $1.50 / 1000 页• 100 份 PDF × 平均 30 页 = 3000 页 = $4.5 ——看着便宜,量大了就贵 • 数据上云——客户合同 / 内部报告 / 隐私文档,过云你心里能踏实? • 锁定 API——想换 provider 难
3. 选免费在线工具(Smallpdf / iLovePDF)?
• 数据上云 + 隐私条款含糊——文档可能被存 • 转换质量参差——表格 / 公式 / 多列布局经常乱 • 不能批量——100 份一份份点,重复劳动 = 零效率 • 不能定制——你想加 LLM 提精度 / 改输出格式?做梦
根本问题:大多数 PDF 工具是给"人看"设计的,不是给"机器处理"设计的——表格丢失 / 公式变图片 / 章节顺序乱。
Marker 的解法:用 ML 模型 + Surya OCR 读 PDF 的 layout 层(文字 / 表格 / 公式 / 多列各归各位),输出结构化 markdown。Apache-2.0 + Python——你要怎么改怎么改。
实测基准:76% 准确率什么概念
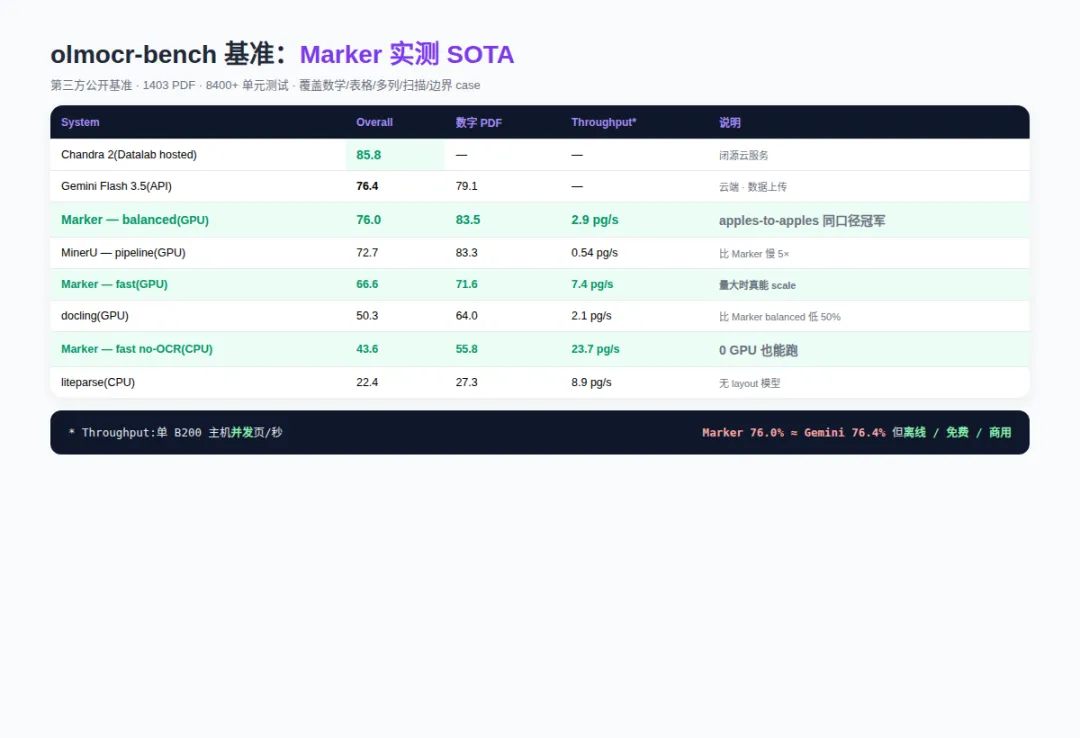
这是 Marker 最硬的钩子。olmocr-bench(Allen AI 出的第三方公开基准,1403 PDF,8400+ 单元测试,覆盖数学/表格/多列/扫描/边界 case):
| Chandra 2 | |||
| Gemini Flash 3.5 | |||
| Marker — balanced | 76.0 | 83.5 | 2.9 pg/s |
| Marker — fast | |||
| Marker — fast, no OCR | |||
* Throughput 是单 B200 主机并发页/秒(不是单流延迟)
关键数字:
• Marker balanced 76.0% overall / 83.5% 数字 PDF — apples-to-apples 同口径下,准确率最高 + 速度快 5 倍(2.9 vs 0.54 pg/s vs MinerU) • Marker fast 66.6% / 7.4 pg/s — 量大时真能 scale • Marker fast no-OCR(CPU) 43.6% / 23.7 pg/s — 没 GPU 也能跑,2.5 万字 / 秒
对比 Adobe:Adobe 根本不参加这种基准——它的卖点是"PDF 编辑"不是"PDF 解析"。Marker 跟 docling / MinerU 一样是"AI 文档解析",准确率比 docling 高 50%,快 1.4×。
对比 Gemini Flash 3.5(API):Marker balanced 76.0 vs Gemini 76.4 — 几乎打平!但 Marker 离线 / 免费 / 商用 / 数据不出门——Gemini 要钱 + 上传数据。
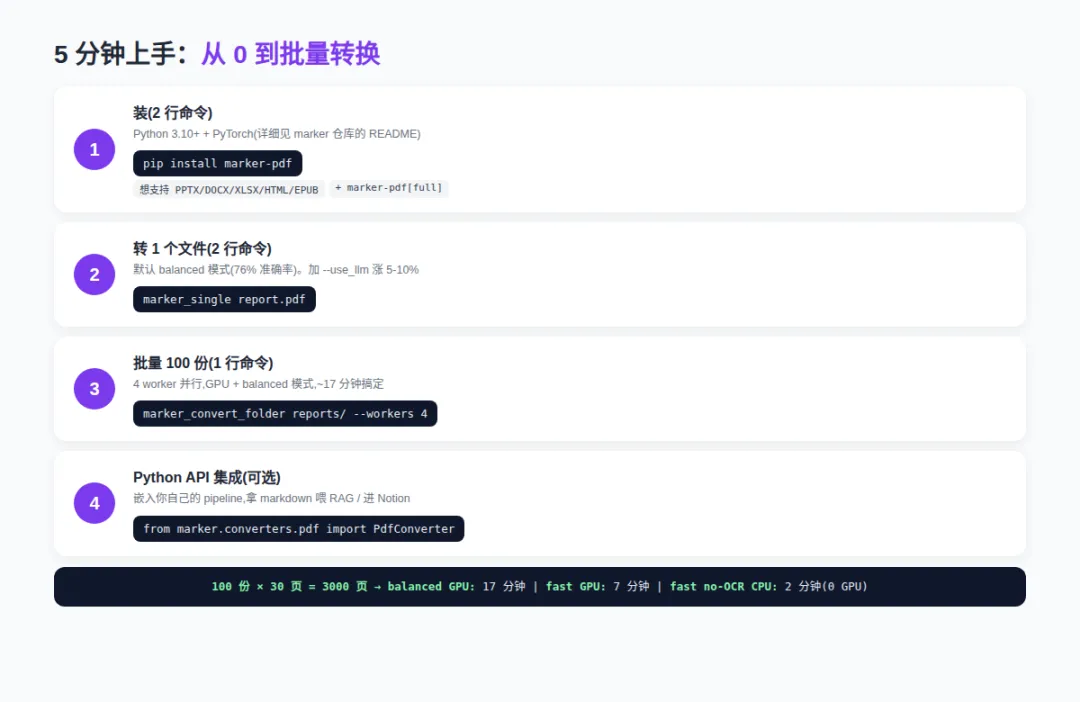
5 分钟上手(从 0 到批量转换)
前置:Python 3.10+ + PyTorch(2 行命令搞定)
Step 1:装
pip install marker-pdf# 想支持 PDF 之外的格式(PPTX/DOCX/XLSX/HTML/EPUB)pip install marker-pdf[full]# 想用本地小模型(必装 llama.cpp,Apple Silicon/CPU 友好)brew install llama.cpp # macOS# Linux:从 https://github.com/ggml-org/llama.cpp/releases 下Step 2:转 1 个文件(2 行命令)
# 基础用法marker_single report.pdf# → 输出:report.md + report/ 目录(图片)# → 准确率:默认 balanced mode(76%)# 想加 LLM 提精度(准确率再涨 5-10%)GOOGLE_API_KEY=your-key marker_single report.pdf --use_llm# 默认用 gemini-3.5-flashStep 3:批量转 100 份(2 行命令)
# 整个文件夹marker_convert_folder reports/ --workers 4# → 4 个 worker 并行,GPU 上一晚上 1000 份都没问题就这么简单。100 份 PDF × 平均 30 页 = 3000 页:
• balanced mode + 1 张 GPU:~17 分钟( 3000 / 2.9 pg/s ≈ 17min)• fast mode + 1 张 GPU:~7 分钟( 3000 / 7.4 pg/s ≈ 7min)• fast no-OCR + CPU 笔记本:~2 分钟( 3000 / 23.7 pg/s ≈ 2min)——0 GPU 都能搞定
Step 4(可选):Python API 集成
from marker.converters.pdf import PdfConverterfrom marker.models import create_model_dictfrom marker.output import text_from_renderedconverter = PdfConverter(artifact_dict=create_model_dict())rendered = converter("report.pdf")text, _, images = text_from_rendered(rendered)# → 拿到 markdown 文本 + 提取的图片(可嵌入 wiki / 喂 RAG)Step 5(可选):开 API server(团队用)
pip install -U uvicorn fastapi python-multipartmarker_server --port 8001# → 团队成员 POST PDF 拿 JSON,集成到你们的 pipeline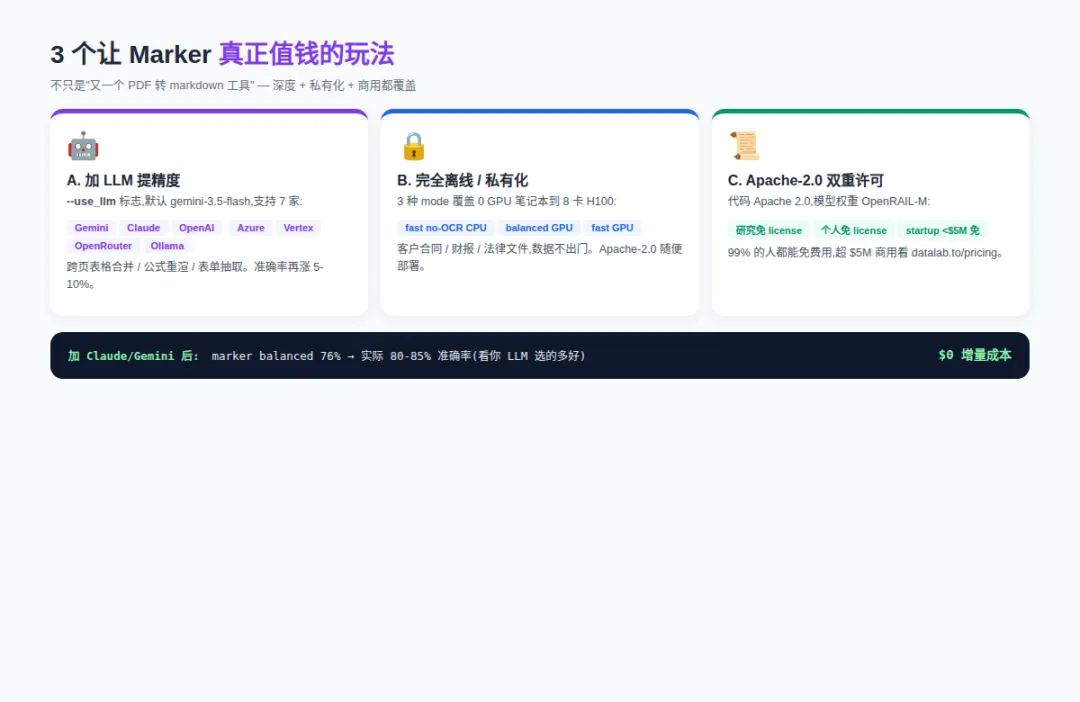
高级玩法:加 LLM 提精度 / 离线 / 商用
3 个让 Marker 真正值钱的玩法:
A. 加 LLM 提精度(--use_llm)
默认 balanced mode 76%——数学公式 / 跨页表格 / 表单数据可能错。加 LLM 后:
• 跨页表格合并 • 公式重新渲染 • 表格结构修正 • 表单值抽取
支持 7 家 LLM(你任选):
• Gemini(默认 gemini-3.5-flash)— 最便宜 • Claude( --llm_service=...ClaudeService+--claude_api_key)• OpenAI / Azure OpenAI / OpenRouter(模型最齐) • Google Vertex(比 Gemini API 更稳) • Ollama(本地模型!数据不出门)
说人话:你手头有 Claude / Kimi / Qwen / DeepSeek 任意 key 都能挂上去,不锁定 Datalab。
B. 完全离线 / 私有化部署
• 不传云端 — 文件全在本地机器 / 内网服务器 • 国内合规 — 政府 / 金融 / 法律 / 医疗 / 客户合同都能处理 • - 3 种 mode 都支持
: • balanced:GPU + 76% 准确率• fast:GPU + 66.6% 准确率,7.4 pg/s• fast no-OCR:CPU 笔记本,43.6% 准确率,23.7 pg/s
C. Apache-2.0 + 模型 Open Rail-M 双重许可
• 代码:Apache 2.0(随便商用,随便改,闭源分发都行) • 模型权重:Open Rail-M(研究 / 个人 / 融资<$5M 的 startup 全免费) • 商业用超过 $5M:去 https://www.datalab.to/pricing 看 license
翻译:99% 的人都能免费用——个人 / 中小企业 / 自媒体 / 公众号作者 / 学生 / 自由职业者,全部 Apache-2.0 自由用。
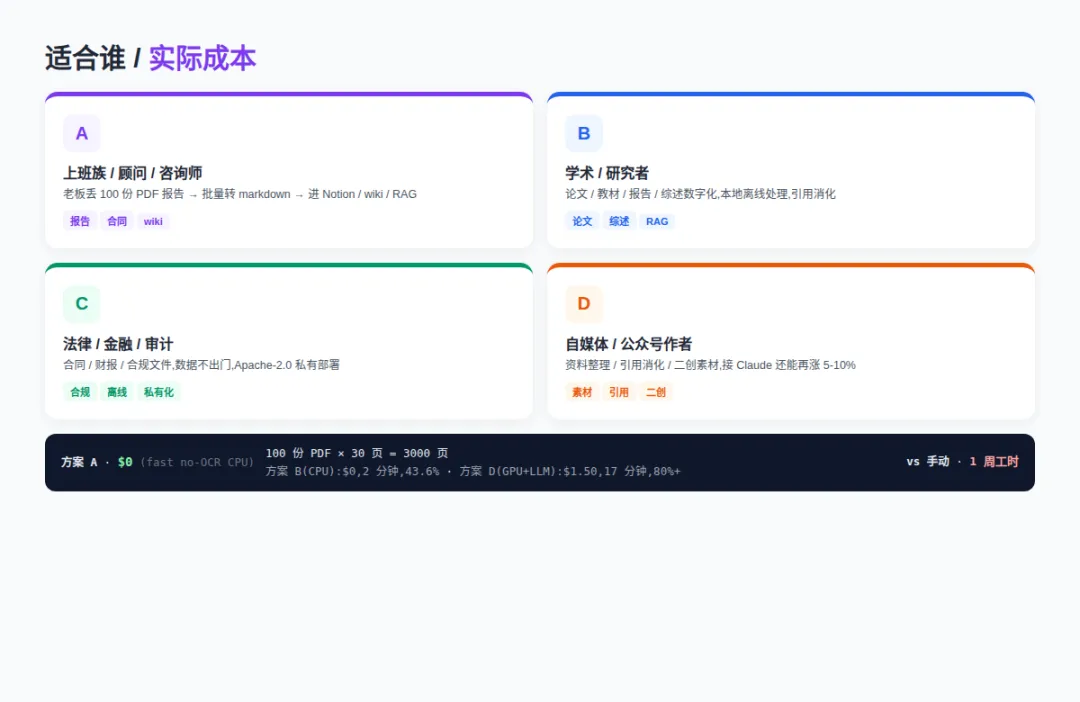
适合谁 + 局限
适合用 Marker 的人
• 上班族 / 顾问 / 咨询师 — 老板丢 100 份 PDF 报告,Marker 批量转 markdown • 学术 / 研究者 — 论文 / 教材 / 报告 / 综述数字化,喂 RAG • 产品经理 / 设计师 — PRD / 客户需求文档 / 竞品分析,转 markdown 进 Notion • 法律 / 金融 / 审计 — 合同 / 财报 / 合规文件,本地离线处理 • 自媒体 / 公众号作者 — 资料整理 / 引用消化 / 二创素材 • K12 / 大学老师 — 教学资料 / 课件 / 试卷数字化 • AI 工程师 — RAG 知识库构建 / 多模态数据预处理 • 任何被 PDF 折磨过的人
Marker 还不够好的地方(坦率说)
• 复杂 PDF 仍需校对 — 76% 准确率 ≠ 100%,关键数据(数字 / 名字)仍要二次确认 • 扫描件/低分辨率 PDF 准确率下降 — 用 force_ocr标志重 OCR• 中文长文档 — olmocr-bench 主要是英文 / 数学,中文 PDF 准确率没官方基准(我估测 70-80%) • 首次安装要下模型 — Surya OCR 模型 ~1GB,下载慢可能卡 • GPU 强 — 76% 准确率依赖 GPU;CPU 跑 fast no-OCR 模式掉到 43.6% • 依赖 ffmpeg — 装 ffmpeg必装
真实成本
| A. Marker fast no-OCR,本地 CPU | $0 | |||
| $0.15/30 页 | ||||
底线:100 份 PDF × 30 页 = 3000 页:
• 方案 A(CPU + 0 准确率打折):$0,2 分钟**(但 43.6% 准确率) • 方案 B(GPU + 76%):$0,17 分钟**(你本机有 GPU) • 方案 C(GPU + Gemini):$1.50 总成本,17 分钟** • vs Adobe 手动抄:你 1 周工时 = $0 但精神损失 $1 万
写在最后
datalab-to/marker 让我喜欢的是它没有发明新概念——它只是把"PDF 解析"这件事做到了 76% 准确率 + 开源 + 离线 + 商用免费 + 可加 LLM。Adobe 收费 $20/月,Google Document AI 按量收费,Marker Apache-2.0 随便用。
它的作者 VikParuchuri 同时维护 Surya OCR(底层 OCR 引擎)+ Chandra(自家更强的 VLM 模型),整个 Datalab 团队就死磕文档 AI 这一件事——所以 3 年下来能做出 76% 这个 SOTA 准确率,Apache-2.0 开源让你白嫖。
3 个建议:
1. pip install marker-pdf先试一个文件 — 5 分钟就知道这玩意儿能不能替代你手头的活2. 100 份批量跑 marker_convert_folder— 加--workers 44 张 GPU 并行,17 分钟出 3000 页3. 要准 + 不差钱就挂 Claude / Gemini — --use_llm标志,准确率再涨 5-10%
跟之前系列组合看:
• impeccable = 网页别让 AI 撞脸 • OpenMontage = 视频别让 AI 烧钱 • PPT Master = deck 别让 AI 生成图片 • Marker = PDF 别让 AI 抄 1 周——10 分钟跑完 • 四件套 = 2026 年"AI 内容处理"完整工具栈
项目地址:https://github.com/datalab-to/marker托管版本 + $5 试用:https://www.datalab.toBenchmark 详情:olmocr-bench