ARTICLE · 1218012
视频终于有了源码:当 AI 不再“拍”视频,而是“写”视频
先说一个容易被讲错、但必须讲清楚的区别。
那支被马斯克转发的 AI 音乐 MV,公开提示词里确实写了:Opus 调用 Seedance 生成画面、ElevenLabs 生成声音、fal 跑视频生成,再用 JavaScript 把动态图形一层层叠上去。在这条流程里,Opus 干的是导演和剪辑的活——它决定每个镜头用什么素材、怎么接、哪里重来。但画面本身,是 Seedance 这个视频模型“拍”出来的,不是代码“画”出来的。这叫编排式混合制作:通用大模型统筹,专业视频模型出底层画面,代码负责上层结构和合成。
而另一批作品走得更远:它们让大模型直接写出 HTML、Canvas、SVG、Three.js 代码,浏览器在无头环境里逐帧渲染,FFmpeg 拼成 MP4。整条流程里,没有任何一个视频生成模型参与。画面不是被“生成”的,是被“画”出来的,只不过画笔从手换成了代码。
这两件事经常被混为一谈。混在一起讲,会让人误以为“纯代码”也能凭空画出电影级真实画面。其实不是。“代码生成视频”是一个伞形概念,下面至少有两条不同的路。
两条路线,两种世界观 今天主流的 AI 视频生成,以 Seedance 为代表,底层逻辑是像素原生:模型在海量视频数据上学会了“一帧长什么样”,然后从噪声中一步步去噪,把像素堆出来。它的强项清晰而无可替代:真实感、光影、人物、氛围。你给它一句“雨夜霓虹灯下的出租车”,它能还你一个像从电影里截出来的镜头。
但这条路线有一个结构性的天花板,和画质无关:它的输出是一堆像素,不是一个工程。 你不满意,只能改提示词,重新“抽卡”。你看到一个数字写错了,想改那个数字——对不起,整段重绘。
代码路线走的是相反的方向。Remotion 用 React 组件写视频,每一帧是一个纯函数,给定同一个时间点 t,永远渲染出同一帧。Motion Canvas 用 TypeScript 的 generator function 编排动画,写起来像剧本:第一步发生什么,停顿多久,下一步接什么。HeyGen 开源的 Hyperframes 把 HTML 当作视频源码,CLI 默认非交互,专门喂给 Claude Code、Cursor 这类编程 Agent。a16z 在一篇被广泛讨论的文章里把分歧说得很干脆:像素原生解决的是生成问题,代码原生解决的是生产问题。
但代码路线内部也要再分一层。
一条是纯代码渲染。 GitHub 上有一个 awesome-opus-5.5-video 的汇总仓库,收录的是画面完全由 HTML、Canvas、SVG、Three.js 在浏览器里实时画出来的短片。典型流程是:Opus 写出场景代码 → 页面暴露一个 seek(t) 函数,每一帧只由时间 t 决定 → Playwright 无头浏览器逐帧截图 → FFmpeg 拼成 MP4。全程没有视频生成模型。那条“全程不得使用 Seedance 之类视频生成模型”的挑战规则,针对的就是这条路的纯粹性测试。
另一条是编排式混合。 同样被马斯克转发的 anabology 那支反乌托邦微电影,走的是这条路的变体:Opus 负责分镜和调度,关键帧底图交给 Midjourney 生成,最后靠代码把静态图编排成连贯影片。Midjourney 是图像模型,不是 Seedance 那样的视频模型;运动、转场、节奏全部由代码控制,而不是由一个视频模型去“想象”每一帧的像素。
所以更准确的表述是:代码生成视频不是要替代扩散模型去“拍”真实画面,而是让视频的结构和运动第一次变得可编程。 纯代码路线能画的是结构性的东西——图表、文字、几何、UI、抽象动效;它画不了 Seedance 那种真实影像的质感直觉。两条路线不是一回事,把它们混为一谈,反而削弱了“代码作为一个新可选项”的真正含义。
“能改”这件事,被严重低估了 大多数 AI 视频的讨论停留在“像不像”“美不美”。但真正在生产环节里泡过的人知道,一条视频的生命周期里,“第一版”占的时间不到三成,剩下七成全是改。
像素路线的改法,是重来。代码路线的改法,是改一行。
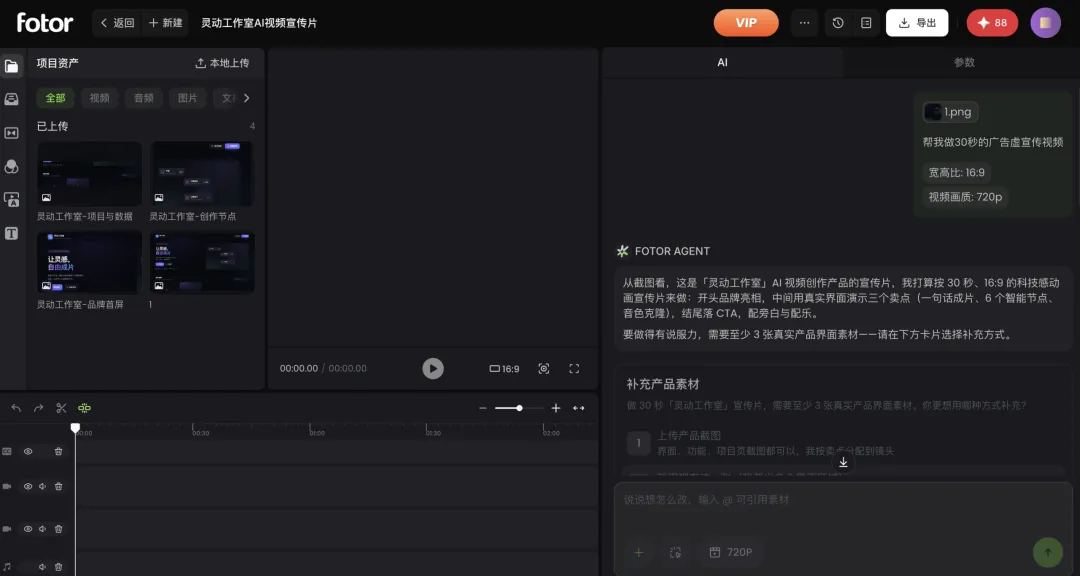
数字错了,改数据源里那个变量;颜色不对,改 CSS 里那个 hex 值;节奏慢了,改时间轴上一个 duration 参数。Fotor Agent 把这件事产品化之后,生成的“视频”实际上是一个多轨工程,文字、数据、图形、配色、配音各占一条轨道,每个元素都可以单独拖拽修改,不需要整条重新渲染。这不是“体验优化”,这是生产关系的变化。视频从一个不可逆的渲染结果,变成了一个可版本控制、可 diff、可批量实例化的代码制品。
批量这件事的想象空间被严重低估了。Remotion 的开发者社区里已经在跑这样的流程:一个 React 组件模板,传入不同的数据,批量渲染出几十条个性化广告变体、财报视频、年度回顾。代码路线下的“一千条视频”,成本结构和“一条视频”没有本质区别——因为你写的不是视频,是生成视频的程序。
诚实地说,它做不了什么 如果这篇文章只讲代码路线的好话,它就不值得写。
代码生成视频的边界和它的优势一样清晰:它能画“可计算的东西”,画不了“感受得到的东西”。数据图表、流程节点、文字动效、抽象几何、UI 演示——这些内容的本质是结构化的,可以用坐标、参数、时间曲线精确描述,代码路线在这个光谱上碾压像素路线。但一旦你要的是演员脸上那一丝疲惫,雨滴打在车窗上那种随机而温柔的反光,两个人对视时空气中微妙的张力——代码给不了。扩散模型在海量真实影像里泡出来的那种“质感直觉”,是程序员写多少行 shader 都补不上的。
所以更准确的描述不是“谁取代谁”,而是视频创作的光谱上多了一个新物种。以前你只有一支“摄影师”队伍,现在你多了一支“工程师”队伍。拍品牌情绪片,找摄影师;做产品更新说明里那 30 秒的 MG 动画,找工程师。两个队伍干的本来就不是同一件事。
真正的信号:视频开始像软件一样被对待了 a16z 那篇文章里有一句话,我认为是整个讨论里最值得被记住的:“设计师需要的不是一张 UI 截图,而是 HTML/CSS 和 React 组件;动画师需要的不是一段视频,而是关键帧、时间曲线和可修改的运动参数”。
过去十年,视觉 AI 的进步几乎全部押在“让像素更像真的”这一个方向上。代码生成视频的出现,把这个单一叙事撕开了一个口子:视觉内容的价值,不只在它“看起来怎样”,还在它“之后能被怎样使用”。一张椅子的渲染图不是椅子,只是椅子的图片。一个视频的 MP4 不是视频资产,只是视频的最后一帧快照。真正能在生产链里流转的东西,得有结构,有层级,有接口。
你不需要成为程序员才能用上这条路。Fotor Agent 这类工具已经把“写代码渲染”包装成了自然语言对话,国内可用,零门槛,成本压到每秒几毛钱。但你确实需要开始用工程师的方式想问题:我要的到底是“一条视频”,还是一个“能反复产出视频的系统”?
这个问题没有标准答案。但工具箱里多了一把螺丝刀,总归不是坏事——尤其当你发现手里那个拧不动的螺丝,本来就不该用锤子去敲。
而这次修正本身也说明了一件事:“代码生成视频”最迷人的地方,不是它多像电影,而是它终于让视频有了可以被拆开、被修改、被版本控制的源码。 只是别忘了,源码之上还有摄影师。两者各干各的活,比硬说谁能替代谁,要诚实得多。
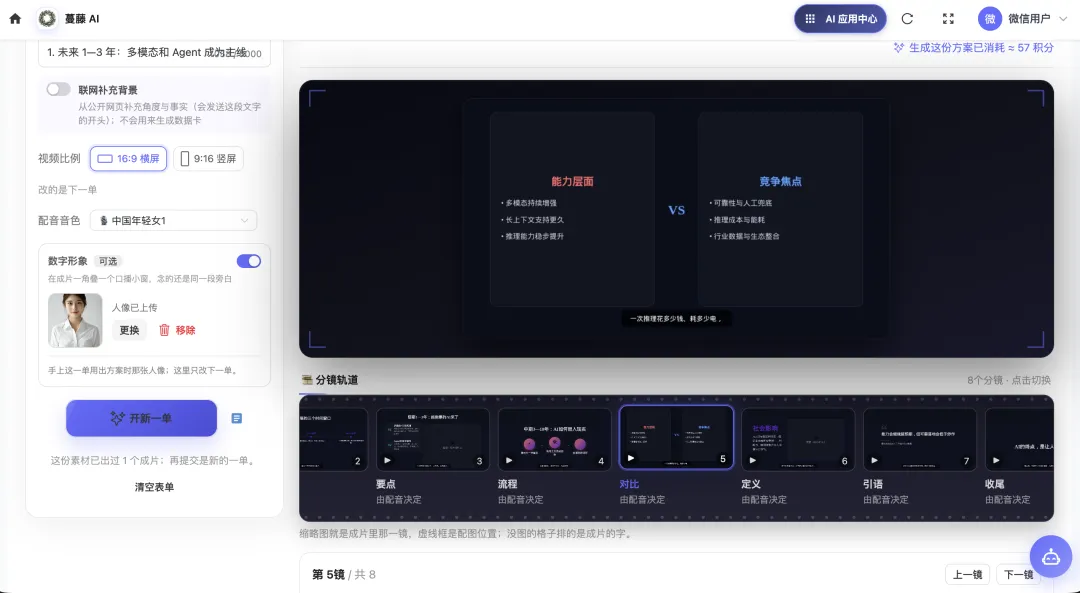
为了让代码生成视频走得更远,蔓藤AI 很早也推出了AI视频编程服务:用户提供文档,链接,数据报表,文本内容,系统就能自动提取内容,根据类型生成不同的视频,比如报表解说,产品宣传视频等。
在系统内部,它会自动选择不同的镜头和模板,在最后开始渲染前,用户还有修改和确认的机会。
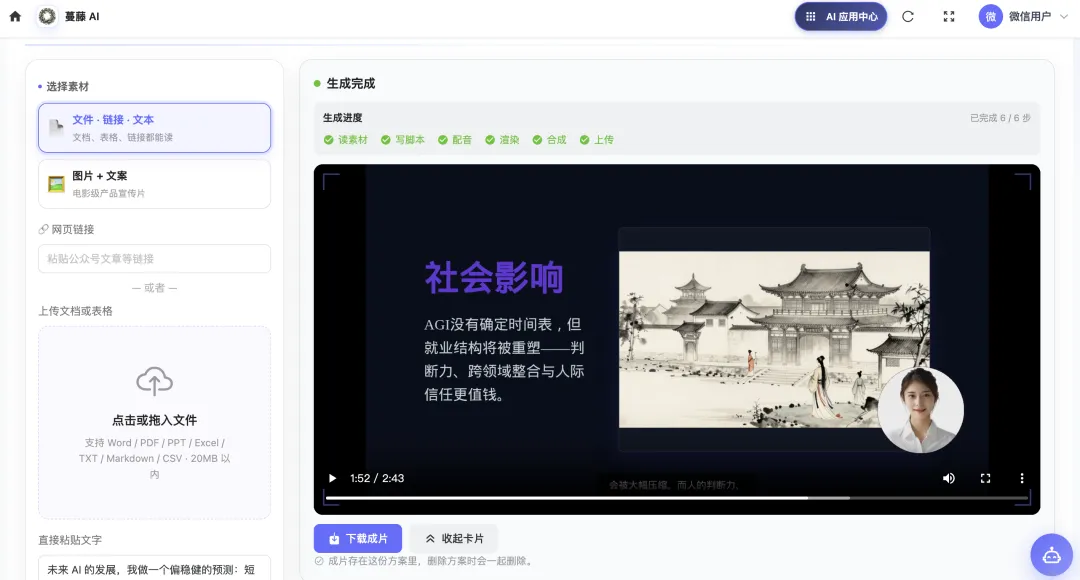
它还支持设置讲话人和声音:
https://www.mindtechassist.com/motion-short