ARTICLE · 1218971
你的 AI 读不懂 PDF?微软开源的MarkItDown 把文档变成AI看得懂的纯文字格式
你有没有过这种经历:手头一堆 PDF、Word、PPT,想让 AI 帮忙总结一下,或者从里面找点东西,结果要么传不上去,要么传上去读出来的全是乱码,表格也散了架。问题的根源不是 AI 笨,而是这些文件太"花"——排版、字体、图片、表格缠在一起,机器啃起来很吃力。
微软做了个"文档搬运工"
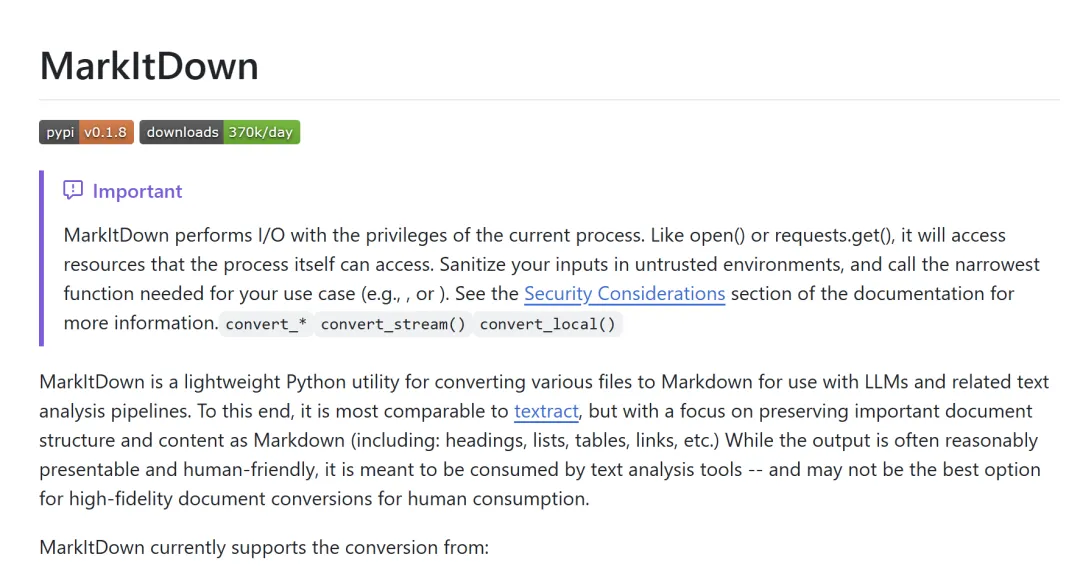
微软出了一个小工具叫 MarkItDown(名字就是 "Markdown it down" 的意思)。它干的事很单纯:把各种文档统一转成 Markdown。Markdown 你可以理解为"带极简记号的纯文字"——用 # 表示标题、用 - 表示列表、用 | 表示表格,人能读,机器更读得顺。
一份顶一抽屉格式
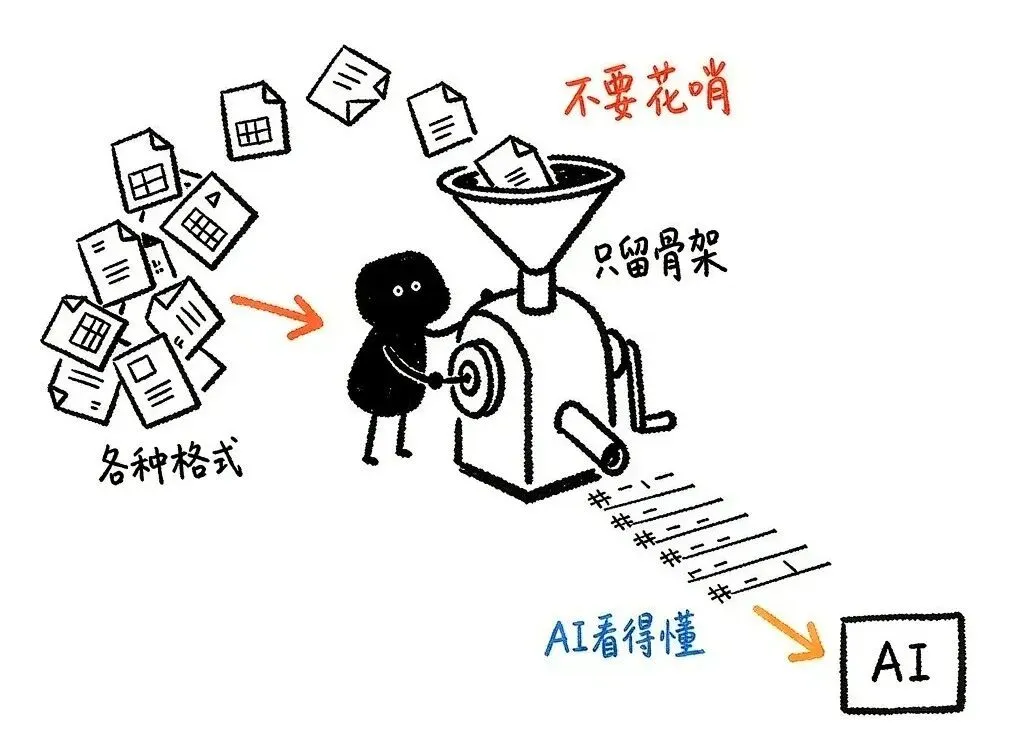
它认的格式多到离谱:PDF、PPT、Word、Excel 自不必说,图片能读 EXIF 信息和 OCR 文字,音频能转写语音,连 HTML、CSV、JSON、XML、压缩包、YouTube 链接、电子书 EPub 都吃得下。基本你硬盘里常见的文档类型,它都能吐成文字。
骨架不丢,还不花哨
转的时候它刻意保住文档的结构:标题层级、列表、表格、链接,都原样变成 Markdown 标记。丢掉的只是那些对"读懂内容"没用的排版装饰。这一步很关键——AI 要的是语义骨架,不是漂亮的版式。
一句命令,塞进脚本就能用
装好之后,命令行敲一行就能转,或者写几行 Python 当库调用。没有界面、不重,放进自己的自动化流程里很顺手。而且它免费开源、能跑在你自己电脑上——文件不用上传到别人的服务器,这点对处理敏感资料的人很关键。
它要的不是"漂亮",是"机器读得动"
重点来了,也是最容易被误解的地方:MarkItDown 不是给你做"一模一样漂亮排版"的工具。它要的不是还原版面,而是"AI 读得懂"。所以它的产物是干净、结构化的纯文字,专门喂给大模型和文本分析流程。你拿它和那些追求高保真的文档转换器比"谁排得漂亮",是比错了赛道。它解决的从来不是"人看着爽",而是"机器读得动"。
如果你要更高质量的提取,它还能接微软的 Azure 内容理解服务,把字段抽得更准——但那属于加餐,核心那一套本地就能跑。
会敲命令,就能拿走
门槛很低:pip 装一下,命令行一行把文件转成 Markdown,或者直接 import 进 Python 用。不需要会深度学习,会敲命令就够。它开源在 GitHub 上,仓库里还有更多格式和用法示例。
项目地址:https://github.com/microsoft/markitdown
先跑起来,再慢慢搞懂。