ARTICLE · 1226968
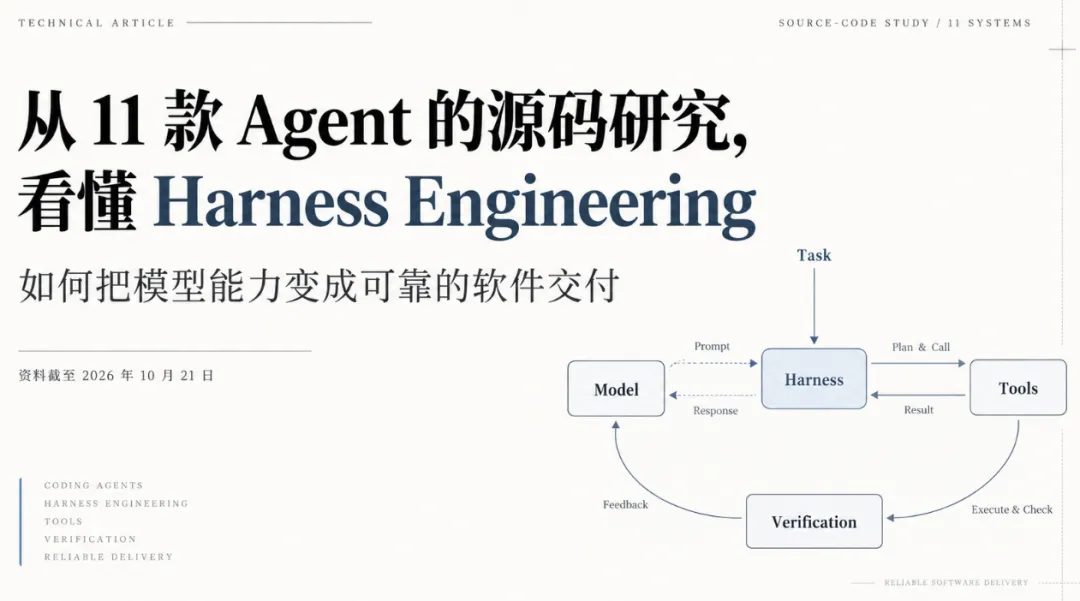
从 11 款 Agent 的源码研究,看懂 Harness Engineering
字数 5816,阅读大约需 30 分钟
同一个模型,接入不同的 Coding Agent,工作体验可能相差很大:
有的能持续推进跨文件修改,有的会反复搜索同一段代码;
有的在编译失败后能够定位问题;
有的却在长对话中忘记最初的约束。
即使最终都生成了一份补丁,它们在成本、恢复能力和权限控制上的差别 仍可能很大。
理解这些差异,需要把目光从模型移向模型周围的执行系统:Harness。
Harness Engineering 关心的是,如何让模型在真实的软件环境里持续行动,获得反馈,遵守边界,并把结果交付出来。它连接了模型能力与软件工程:一次工具调用是否可靠,一段历史如何压缩,一个任务中断后如何继续,一份修改凭什么被判定为完成,都属于它的设计范围。
一项覆盖 11 个 Agent 系统的源码研究,为理解这些问题提供了有价值的观察。但研究最值得借鉴的部分,不是照搬某个产品的功能清单,而是理解设计背后的约束,再用自己的任务验证取舍。
一、11 个系统揭示了什么
《Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents — A Source-Code Study of Eleven Systems》分析了11个coding agents,并将 Omnigent 作为对照对象。
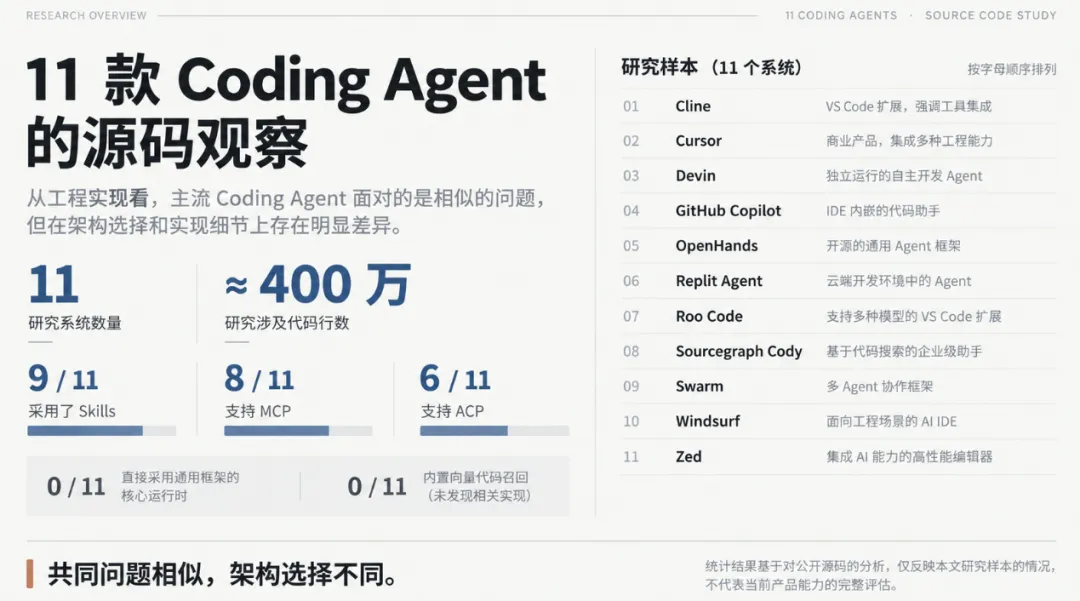
论文报告的源码规模约为 400 万行,覆盖 Python、TypeScript 和 Rust。其主要统计包括:
这些数字属于论文所检查的历史源码快照,不是整个市场的采用率,也不是所有产品在今天的功能清单。约 400 万行包含客户端、适配和其他工程代码,不能全部理解成 Agent 核心循环。源码中的“未发现”也不等于通过运行实验穷尽了动态插件和外部服务的所有能力。
这项研究的核心价值在于揭示设计空间:相似的模型调用循环,可以搭配完全不同的上下文、权限、工具和扩展机制。
同时,样本之间存在差异。研究型基线、终端工具、完整开发平台和通用 Agent 的目标并不相同。Claude Code 的分析还依赖较早的非官方源码快照,其内部细节需要与正式产品文档分别理解。论文没有在统一模型、预算和环境下运行跨系统性能比较,因此不能据此排列产品优劣。
阅读源码研究时,一个实用原则是:把架构观察作为设计假设,把任务评测作为选择依据。
二、Harness 是把模型决策转化为可靠执行的系统
可以用 Agent ≈ Model + Harness 帮助理解分工,但它不是性能公式。
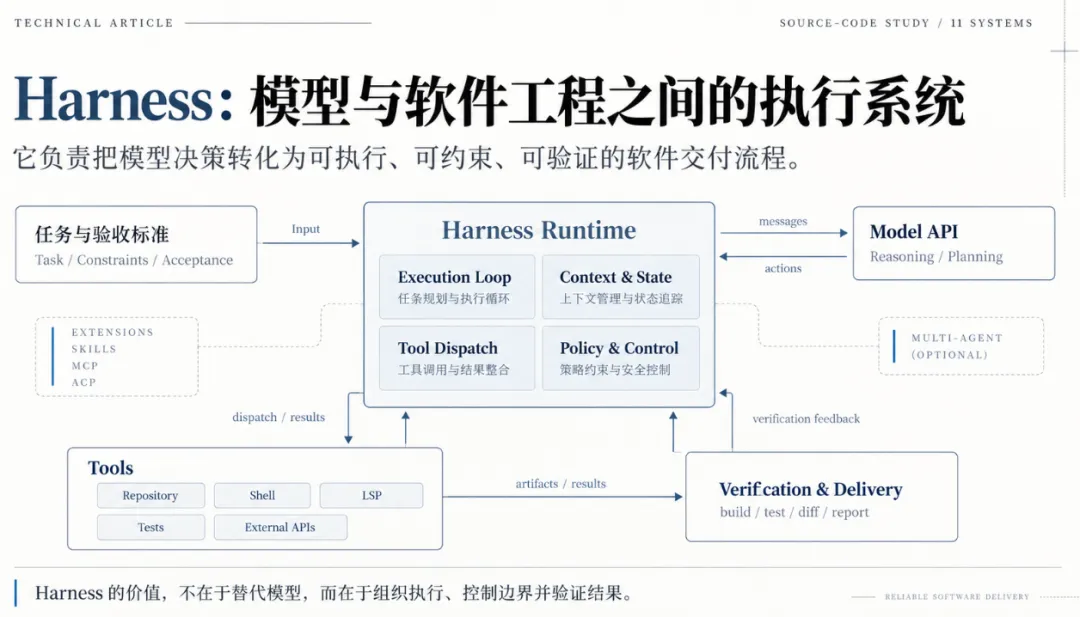
模型提出计划和动作;Harness 组织上下文、调用模型、执行工具、控制权限、维护状态,并向用户报告结果。以“重构 C++ 并发模块”为例,实际过程包括:
任务与验收标准 ↓读取仓库信息 → 模型提出操作 ↓ 参数与权限检查 ↓ 受限执行环境 ↓ 结果记录与上下文更新 ↓ 编译、测试、差异检查与交付从工程设计看,可以把 Harness 分成七个观察面:
这些观察面用于划清职责,不必对应七个独立服务。对一个小型系统,它们可以存在于同一个进程;随着需求增长,再逐步拆分实现。
Framework 与 Harness 不能简单二选一
Framework 通常提供构建 Agent 的抽象;Harness 强调实际执行系统。二者的能力可以重叠,也可以组合。
例如,LangChain 官方将 Deep Agents 定义为 Agent Harness,并明确说明其使用 LangGraph 支持持久执行、流式输出和人工介入。因此,“所研究的运行时没有直接依赖某些框架”不能推出“真正的 Harness 都不用框架”。
选型更适合围绕以下问题:团队是否需要自定义调度?现有组件能否表达工具取消与恢复?维护自研运行时的成本是否低于适配现成方案?
自定义循环、通用框架、现有 Harness SDK 都是可选方案。“从零写”应当有具体收益,而不是由样本采用率决定。
三、代码检索:优先建立可靠基线,不把向量检索当作对立面
代码包含大量明确线索:路径、函数名、错误码、类型和依赖关系。利用这些线索建立检索基线,通常比一开始引入复杂的索引服务更容易验证。
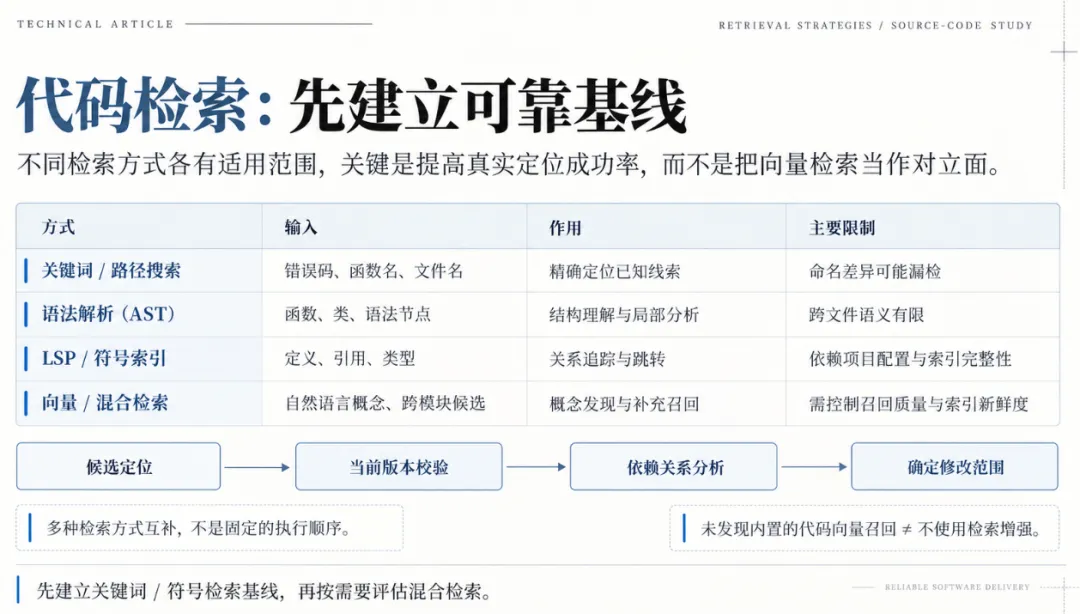
不同检索方式各有适用范围:
RAG 指通过检索补充生成上下文,并不等于“Embedding + 向量数据库”。在广义检索增强流程中,关键词和符号搜索同样可以提供上下文。因此,更准确的历史表述是“未发现内置的代码向量召回”,而不是“这些 Agent 不检索增强”。
没有向量数据库,也不意味着没有索引。Aider 官方说明,其 repo map 会根据代码依赖图排序,在 Token 预算内选择相关的代码结构信息。这展示了结构化代码信息与排序算法结合的一条路径。
以 USB 故障恢复代码为例,可以先搜索明确线索:
rg -n 'FT_Open|FT_IO_ERROR' src/rg -n 'recover|reconnect|reset' src/随后检查函数实现、调用者、线程创建及同步路径。C++ 项目中应结合实际编译配置分析;不能仅凭名称匹配判断哪个线程承担恢复职责。
索引新鲜度是所有索引方案的问题,不是向量检索独有的问题。 符号缓存、repo map 和语言服务器也可能滞后。建议让检索结果携带版本或内容标识,并在编辑前读取当前文件验证。
跨仓库概念发现可以评估混合检索,但应与同预算的关键词、符号基线比较。指标包括真实定位成功率、召回率、延迟、Token、索引更新成本以及越权召回情况。不要仅按结果是否“看起来相关”判断。
四、极简循环有价值,但不能代表完整产品成本
Mini-SWE-Agent 当前文档仍强调其约百行的核心 Agent,并报告 SWE-bench Verified 超过 74%。同时,文档也列出了模型适配、执行环境和运行脚本,并支持 Docker/Podman、Apptainer、Bubblewrap 等环境。不能将“核心短小”写成“整个项目只有百行”,也不能将其笼统描述为没有隔离能力。
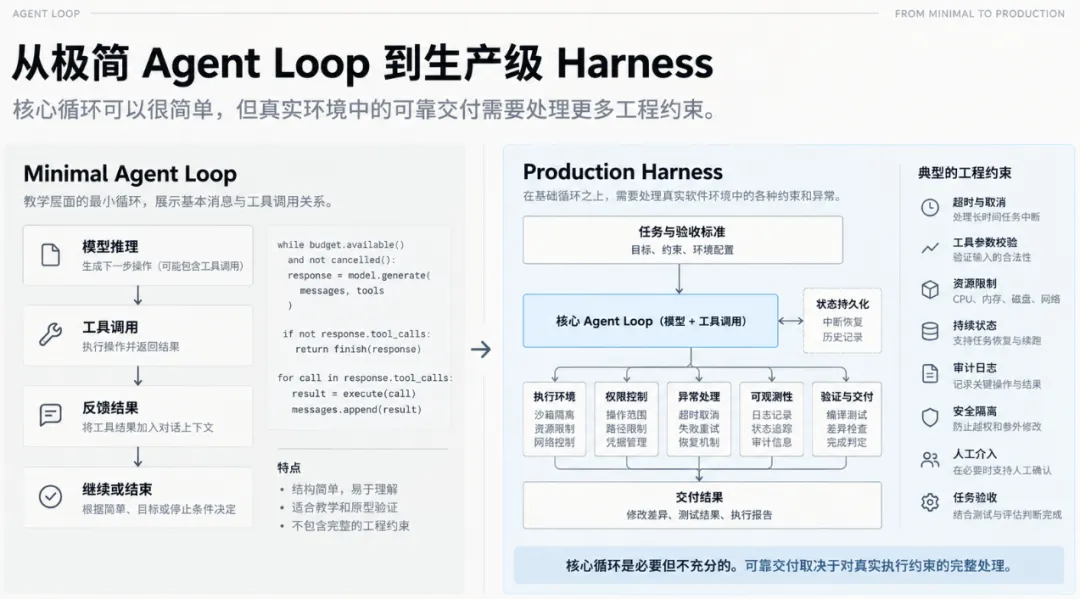
该成绩是项目报告,不是本文复现结果;缺少相同模型、预算、任务和运行配置,就不能据此排列 Harness 优劣。
以下仅是伪代码,用于展示完整工具消息关系:
while budget.available() and not cancelled(): response = model.generate(messages, visible_tools) messages.append(response) # 保留模型消息及工具调用 ID if not response.tool_calls: return verify_or_report_incomplete(response) for call in response.tool_calls: decision = policy.evaluate(call, task_scope) result = execute_or_reject(call, decision) messages.append(tool_result(call.id, result))return report_stopped_with_state()生产实现还要处理超时、取消、流式输出中断、模型返回不完整、工具参数校验、资源限制和日志持久化。没有工具调用也不等于任务成功;是否完成必须结合验收条件判断。
这与网络服务很相似:一个 TCP Echo Server 可以很短,生产服务却还要处理资源管理、超时、背压、监控和恢复。Agent 的基础循环同样可以短,真实复杂度往往来自故障、资源、权限和交互。但这并不证明复杂度与成功率无关。一个修复取消传播、上下文丢失或编辑冲突的机制,完全可能直接提高交付成功率。
五、Skills、MCP 与 ACP 分别解决什么问题
Agent Skills 标准定义了包含 SKILL.md 的目录,以及可选脚本、参考文件和资产;规范鼓励按需加载。MCP 的范围不只工具调用,还包括资源、提示等协议能力。本文的 ACP 专指 Agent Client Protocol,主要面向编辑器等客户端与 Agent 的集成。
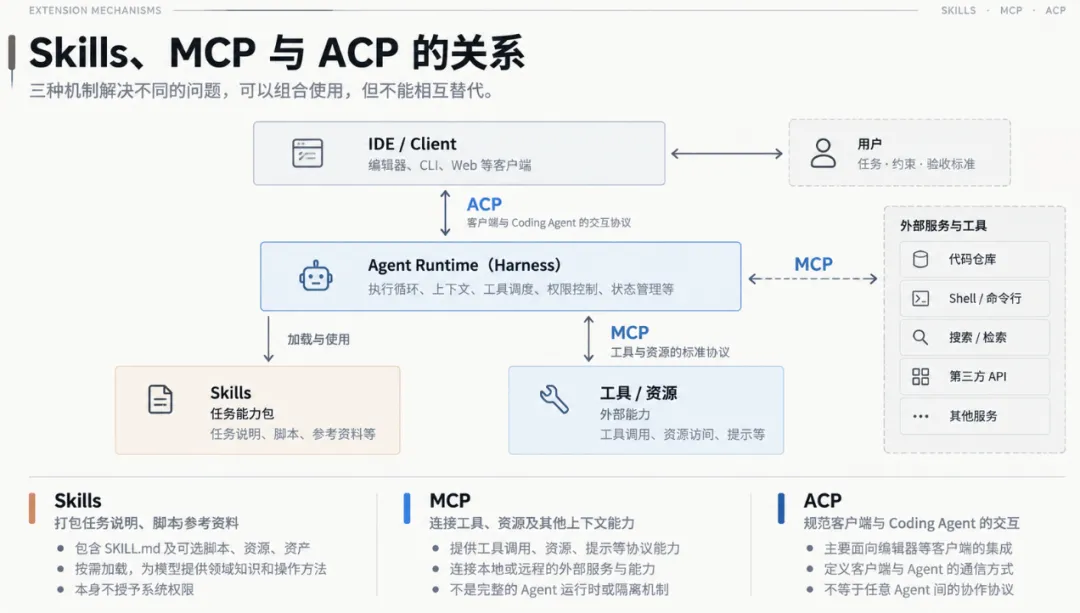
下面是一个可移植的 Skill 包结构示意。实际放在哪个目录,由宿主产品的发现规则决定,不假定所有产品都使用 .agents/skills/。
cpp-code-review/├── SKILL.md└── references/ └── concurrency.md---name: cpp-code-reviewdescription: Review C++ changes for ownership, concurrency, and error handling.---检查对象生命周期、线程同步和异常路径。每项发现提供位置、触发条件、影响及可验证依据。明确列出尚未运行的验证。延迟加载是上下文预算策略,是否采用应看工具 Schema 总长度、调用分布、发现失败率与额外延迟。实际收益取决于加载前后的上下文构成,不能直接套用其他产品的节省比例;工具数量也不应成为唯一阈值。
Skills 的按需读取与工具 Schema 搜索属于不同层面的加载机制。二者都可能节约初始上下文,也都可能引入选错能力、漏加载或额外调用成本。
第三方 Skill 应按扩展包管理:检查来源和版本、审查脚本、限制实际执行权限。包内 Markdown 不能自行扩大用户授权或绕过宿主策略。
六、长程可靠性:把摘要、任务状态和外部事实分开
长程任务可以将信息分成三个层次管理:
不必把所有自然语言内容强行结构化。需要稳定结构的是恢复时不可丢失的字段,长说明仍可使用 Markdown。
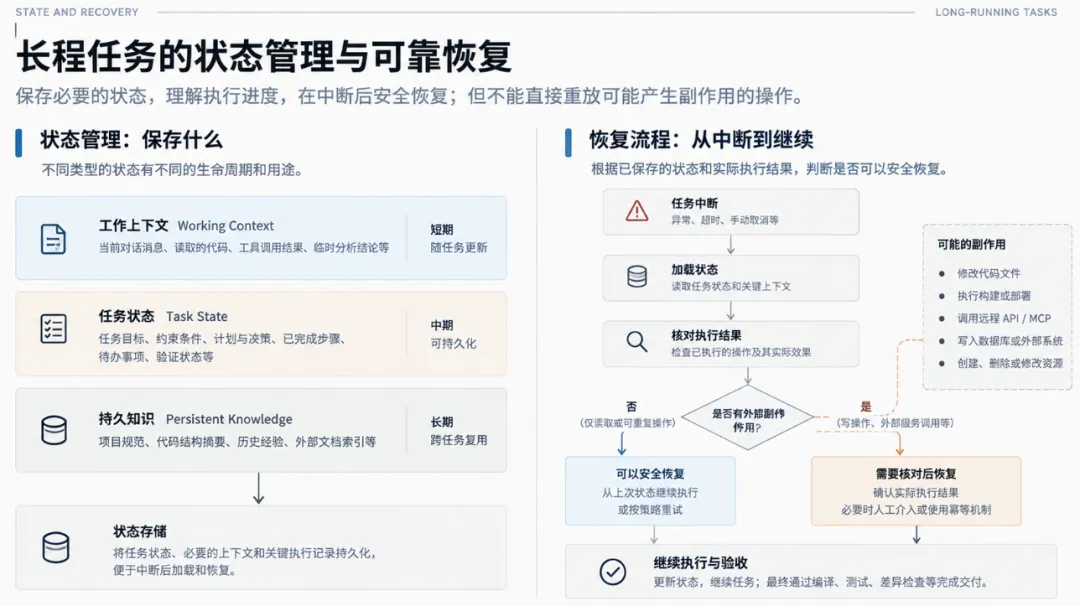
例如,下面是一份建议的状态记录,而不是特定产品的配置格式:
goal: 修复设备恢复线程的生命周期问题constraints: - 保持公开 API 不变decisions: - 保留互斥队列;不引入 lock-free queueworkspace_revision: "记录基准提交与未提交差异标识"verification: - command: "ctest --test-dir build --output-on-failure" result: "尚未执行"pending: - 检查取消路径上的对象生命周期压缩摘要不应把“计划测试”变成“测试通过”,也不应把过去版本的测试结果无条件继承到新代码。测试记录应绑定运行时的代码状态。
记录了事件,不等于可以安全重放事件。 如果提交远程请求成功后进程崩溃,而结果尚未落盘,恢复时再次执行可能产生重复副作用。建议按操作类型处理:只读查询可重试;文件修改先核对内容;外部写入使用幂等键、查询确认或人工处理;不能确定是否执行成功的动作进入“结果待核对”状态。
Git worktree 能减少不同修改任务之间的文件冲突,但不是安全沙箱,也不能回滚已经发生的远程写入。
七、安全与验收必须从第一次执行就进入设计
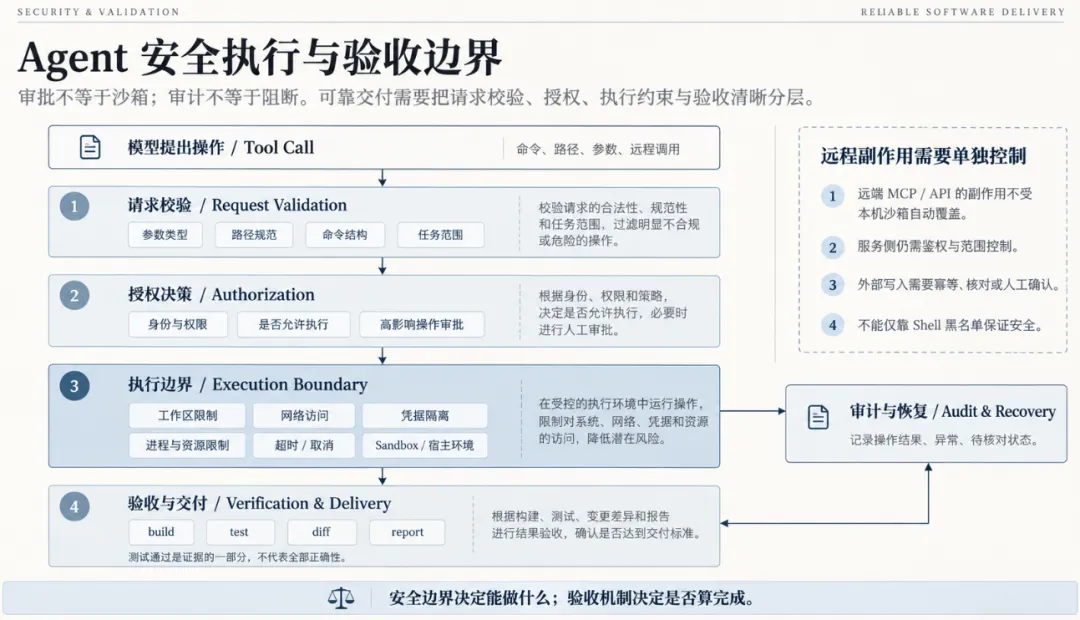
权限审批决定是否放行某项操作,沙箱限制操作执行后实际能访问什么。Codex 官方资料分别描述审批策略和沙箱模式:关闭审批提示并不自动关闭沙箱;实际能力取决于配置与执行环境。Agent approvals & security
更完整的设计应区分四类职责:
1. 请求校验:参数类型、路径、命令结构和任务范围。 2. 授权决策:该身份、该任务是否允许执行这项操作。 3. 执行约束:文件、网络、凭据、进程及资源边界。 4. 审计与恢复:记录结果,检测异常,提供核对和补救路径。
其中第四项主要是可追踪和纠错能力,不应与前三项并列称为能阻止越权的强制边界。
安全设计还应覆盖远程 MCP/API 调用。远端服务使用自身凭据产生的副作用,不一定受本机进程沙箱控制,必须在连接器或服务侧限制。
对 Shell 只做字符串黑名单不够;路径规范化也不能独自解决符号链接和检查后变化等问题。对高影响操作,宜减少通用命令权限,提供带明确参数和范围的专用接口,并由执行环境落实限制。
建议把首版基线设为:限定工作区、明确网络与凭据访问、配置超时和取消、限制预算、保留操作记录,并执行与任务相关的验收。后续再逐步增强策略、审计和治理,而不是先运行一个有任意写权限的原型,再补安全。
八、多 Agent:由任务边界决定是否使用
多 Agent 适合独立探索和验证,不必成为默认结构。代码审查可以分配相互独立的问题域,但最终仍要合并证据、去重并验证发现。
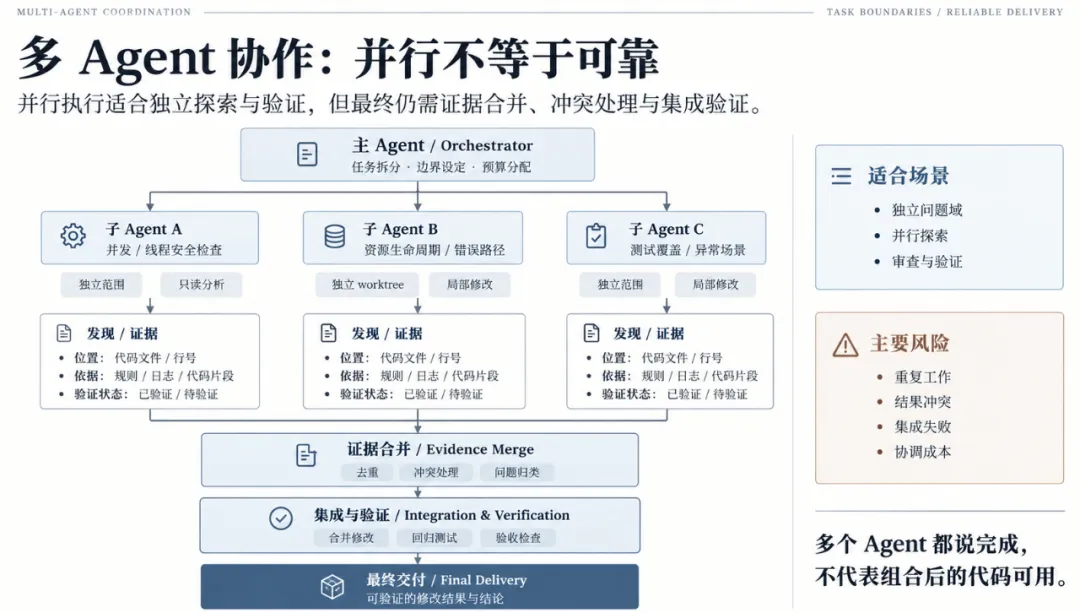
当前 Claude Code 官方文档支持子 Agent 继续委派,默认最多到主会话下三层,并提供深度和并发限制。具体限制可配置,且不同版本曾采用不同默认值。实际使用时,应同时确认嵌套深度、并发上限和父子任务的等待行为。
Anthropic 在 2025 年介绍多 Agent 研究系统时报告:其数据中普通 Agent 约为聊天的 4 倍,多 Agent 约为聊天的 15 倍。这不是 Coding Agent 的固定成本倍率,也不能直接用 15/4 预测某个项目的增量成本。
建议委派时明确:任务目标、只读或可写范围、代码版本、预算、截止条件、输出格式及失败上报方式。对子 Agent 的返回结果,至少要求位置、证据、验证状态和未解决问题。
并行写入时,使用独立工作树仍需要集成阶段的冲突处理和回归测试。多个 Agent 都说“完成”,不代表组合后的代码可用。
九、平台化已有实例,但运行时复用不等于完整兼容
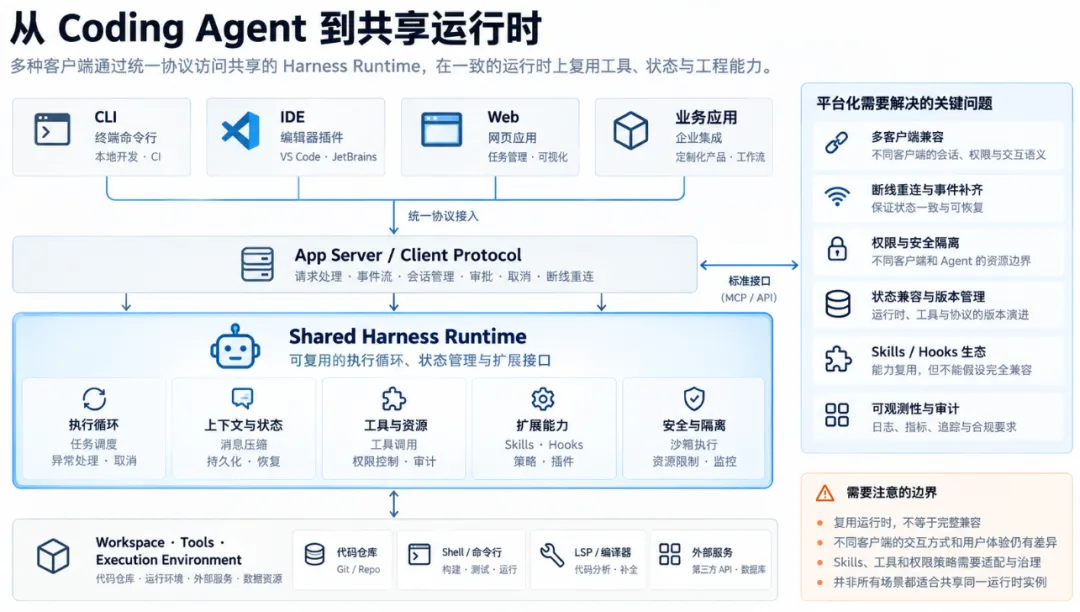
当同一套运行时能够服务于 CLI、IDE、Web 和业务系统时,Harness 就具备了平台属性。OpenAI 官方于 2026 年 8 月介绍的 Codex app-server,通过客户端协议暴露线程、轮次、事件与审批等能力,让应用复用运行时。Codex as a platform
因此,团队不必只在“安装 CLI”和“从零开发 Agent”之间选择,也可以集成现有运行时。
但接口相似不意味着 Skills、Hooks、会话和权限语义可以无损迁移。评估集成时需要检查:
• 客户端断连后任务如何继续,重连后如何补齐事件。 • 工具调用、审批、取消和会话恢复是否有明确契约。 • 多用户之间的工作区、记忆、凭据和日志是否隔离。 • 插件版本变化后,旧任务状态能否读取。
这些是平台工程要求,不能通过“支持某个协议”一个标记直接判断。
十、从最小系统走向可靠交付
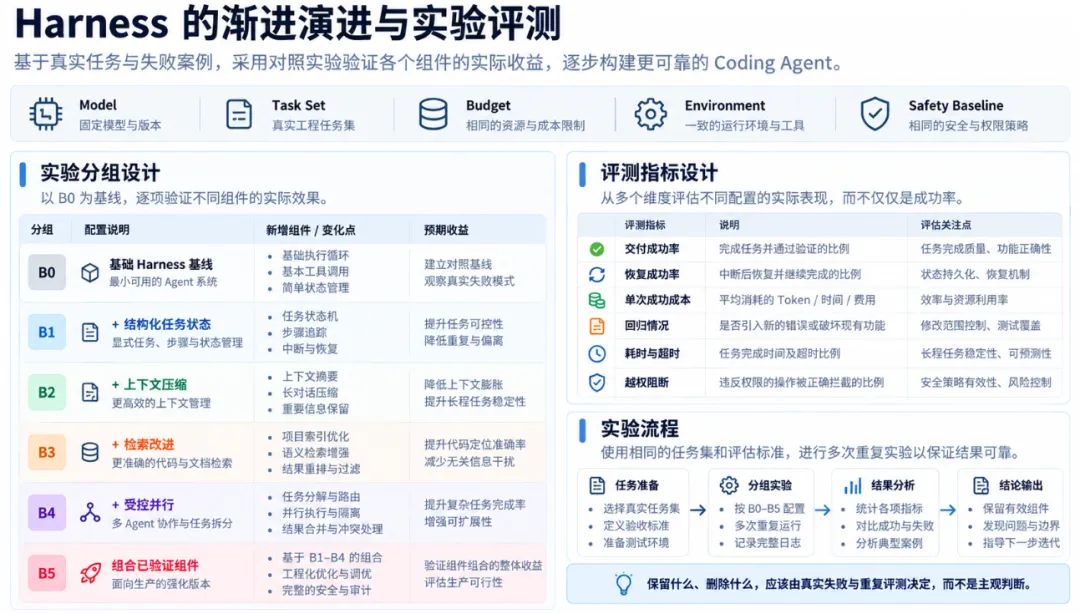
1. 先建立可靠单 Agent 基线
首版实现最小循环、模型适配、必要工具,以及基本权限、隔离、超时、取消、日志和验收。工具尽量少,但要能解释参数错误、拒绝原因和部分成功。
2. 用真实失败驱动状态与恢复能力
观察是否出现重复探索、遗漏约束、历史测试误用或中断后重复写入。针对这些失败加入任务状态、压缩、检查点及恢复核对,而不是为了架构完整提前实现全部模块。
3. 再评估检索、扩展与并行
只有当基线暴露出代码定位、工具发现或独立子任务吞吐问题时,再引入混合检索、延迟加载、Skills 和多 Agent,并测量收益。
4. 评测要能隔离变量
逐级叠加功能可以观察整体演进,却难以区分每个组件的贡献。更合适的做法是先进行单变量实验,再测试组合效果。所有方案保持同一最低安全与验收基线:
固定模型版本、推理设置、任务集、时间和 Token 预算、工具权限、环境与重试规则。使用隔离执行环境,重复试验并报告样本量和不确定性;对收益很小的改动,不只看一次运行。
测试通过是交付证据的一部分,不是对全部正确性的证明。对 ABI、并发和性能任务,应增加相应约束检查;无法验证的部分应明确保留。
十一、可靠性来自每一次动作都有依据
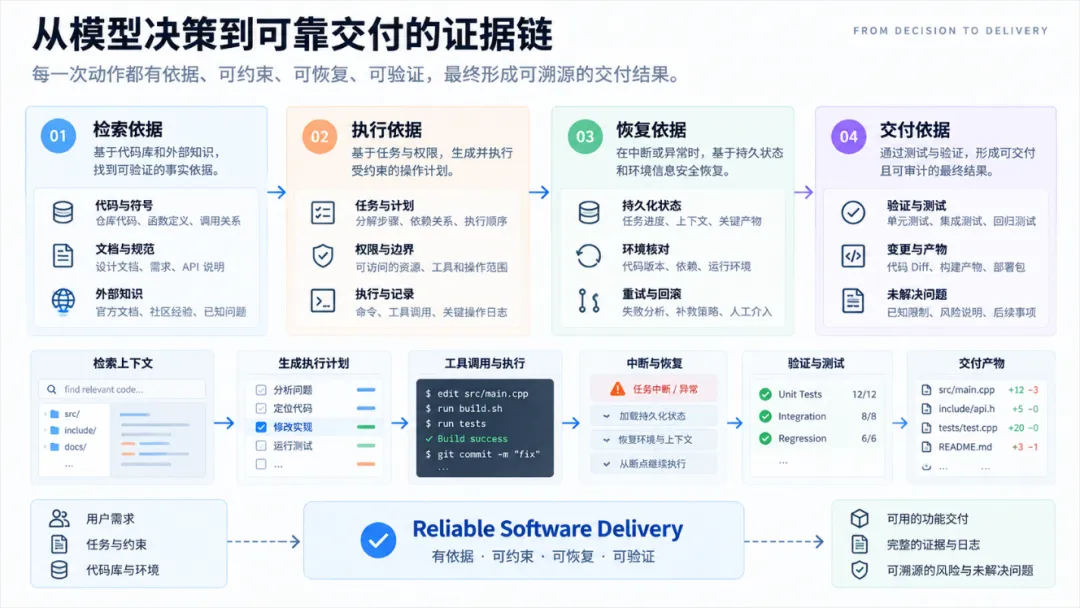
Harness Engineering 最终需要回答一个具体问题:模型提出的每一次动作,如何成为可理解、可约束、可验证的工程过程?
在检索阶段,依据是当前代码、符号关系和可追溯的来源;在执行阶段,依据是用户目标、操作权限和明确的工具契约;在恢复阶段,依据是持久化状态与实际环境的核对;在交付阶段,依据是测试、差异检查和仍未解决的问题。
这些能力并不要求每个 Agent 都拥有庞大的系统。一个边界清楚、工具可靠、能够验证结果的小型 Agent,往往比功能堆叠但状态混乱的系统更容易维护。反过来,当任务确实需要长程恢复、复杂协作或多用户治理时,相应的工程复杂度也有其价值。
模型能力会持续变化,运行时设计也需要随之调整。过去必要的提示词和流程可能变得多余,新的工具与上下文机制也可能带来收益。决定保留什么、删除什么,应当依据真实失败和重复评测。
一个好的 Coding Agent,不仅能生成代码,还能说明修改依据、展示验证结果,在中断后继续工作,并在无法确认时准确报告状态。把这些能力组织成稳定的执行系统,就是 Harness Engineering 的核心工作。
参考资料
本文结合源码研究与项目官方文档讨论架构设计。研究统计按论文口径引用,项目自报成绩不作为统一性能排名:
1. Harness Engineering:论文元数据 2. Harness Engineering:论文全文 3. LangChain:Deep Agents overview 4. Aider:Repository map 5. Mini-SWE-Agent:官方文档 6. Agent Skills:格式规范 7. MCP:架构说明 8. ACP:协议简介 9. Claude Code:子 Agent 文档 10. Anthropic:多 Agent 研究系统的工程经验 11. OpenAI:Agent approvals & security 12. OpenAI:Codex as a platform