ARTICLE · 1229607
Graphify:让 AI 助手真正读懂你的代码库
Graphify:让 AI 助手真正读懂你的代码库
你有没有过这种体验:让 Cursor / Claude Code 改一个跨文件的功能,它先花十几轮 grep、读了一堆文件,才勉强拼出调用链;下次问类似的问题,又从头来一遍。大模型每次会话都是"失忆"的,它不记得你的代码长什么样。
这个痛点 Andrej Karpathy 早就点过:应该给代码库建一份"LLM 可读的 wiki",让助手直接读地图,而不是每次重新推导结构。
Graphify 就是这个想法的开源实现——一条命令,把整个代码库(连同文档、PDF、图片、视频)变成一张可查询的知识图谱。它给你的答案是一条"路径",而不是一堆 grep 结果。项目已在 GitHub 全球趋势登顶,117 天拿到 10 万 star,跑在 20+ 个 AI 编程助手里。
一、Graphify 是什么
一句话:一个本地优先的代码知识图谱工具。在助手里敲一条 /graphify .,它会产出三个文件:
graph.html:交互式可视化,可点击节点、按社区筛选、搜索; GRAPH_REPORT.md:高亮报告——核心概念、意外连接、建议追问的问题; graph.json:完整图谱,随时拿去查询,不用再读原始文件。
它支持的助手包括 Claude Code、Cursor、Codex、Gemini CLI、GitHub Copilot、Aider、Trae 等 20 多种,macOS / Linux / Windows 通吃,一次安装即可。
二、核心原理:确定性解析 + "诚实的边"
代码解析走 tree-sitter AST,在本地确定性执行——不调 LLM、不上传任何东西,覆盖约 40 种编程语言。SQL 还有特殊待遇:表、视图、外键、JOIN 关系都是确定性抽取出来的。
最关键的 design decision 是:每条边都带"置信度标签"。
EXTRACTED:源码里明确写着的(比如一次调用、一个 import),置信度恒为 1.0; INFERRED:Graphify 依据静态证据推断出来的,带 0.55~0.95 的 confidence_score;AMBIGUOUS:不确定,会在报告里标出来等你人工复核。
这意味着 AI 给你的答案,你能看清哪条关系是"读出来的"、哪条是"猜出来的"。这才是可审计,而不是玄学。
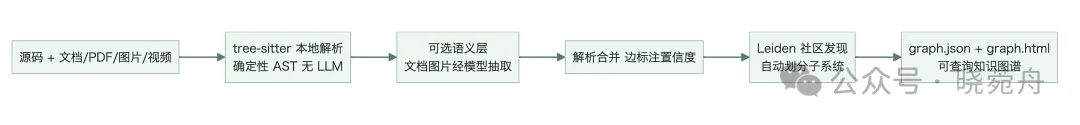
三、一张图看懂:FastAPI 代码库被画成图谱
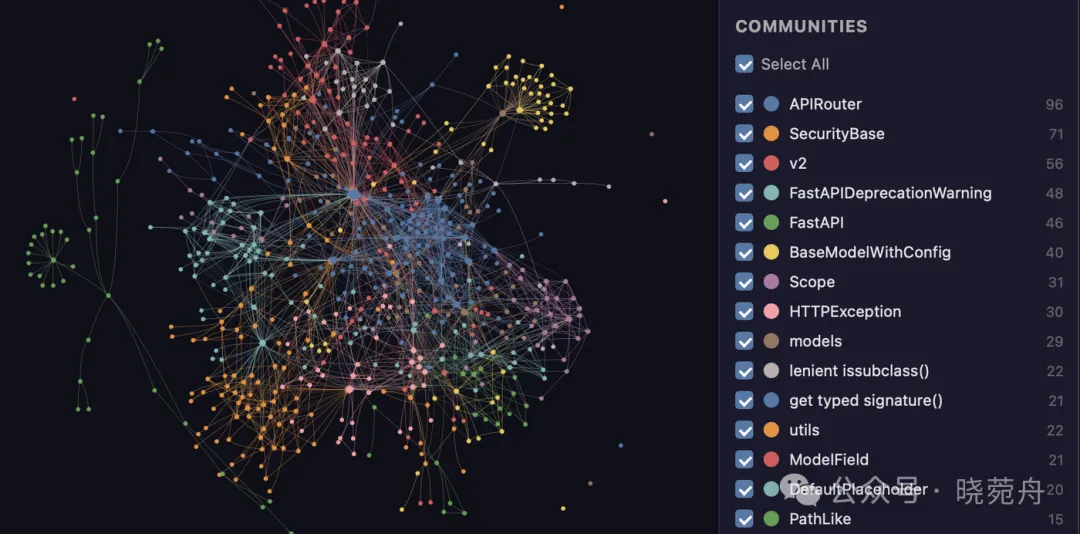
graph.html 把整个代码库画成力导向图:每个节点是一个符号(函数 / 类 / 文件),颜色是自动检测出的"社区"(子系统),节点越大表示连接越多(所谓 god node)。
你能一眼看出哪个模块是"上帝节点"——改动它,影响面最广;哪个区域是一个高内聚的模块。下面就是官方用 Graphify 跑 FastAPI 代码库得到的真实图谱:
四、三大核心能力
- God nodes
:连接最多的概念,告诉你一切流量经过哪里; - Communities
:用 Leiden 算法把图拆成子系统,自动命名(无需 LLM); - Query / Path / Explain
:问一个问题、追溯两个东西怎么连、或解释单个概念,全部基于 graph.json完成。
五、查询演示:不是 grep,是"走路径"
graphify explain "APIRouter" 直接给出节点来源、所属社区、度数和几十条连接,每条都标 EXTRACTED / INFERRED:
$ graphify explain "APIRouter" Node: APIRouter Source: routing.py L2210 Community: 2 Degree: 47 Connections (47): --> RequestValidationError [uses] [INFERRED] --> Dependant [uses] [INFERRED] --> .get() [method] [EXTRACTED] <-- __init__.py [imports] [EXTRACTED]graphify path "FastAPI" "ModelField" 则给出最短路径(3 跳),一步步点亮沿途节点。下面这张官方演示图直观展示了"路径查询"长什么样:
六、不止代码:文档、PDF、图片、视频都进同一张图
文档、论文、图片、音视频通过可选的语义层(你配置的模型,或本地 Ollama)抽取概念与关系,和代码混在同一张图里。视频 / 音频甚至用 faster-whisper 本地转写,转写 prompt 还会用你代码图里 top 的 god node 做领域聚焦。
连代码里的 # NOTE: / # WHY: 注释、ADR / RFC 引用都变成一等节点,直接和代码相连。研究笔记、论文也能丢进去按概念关系查询,而不是手动翻。
七、和 RAG / 向量检索的本质区别
EXTRACTED / INFERRED | ||
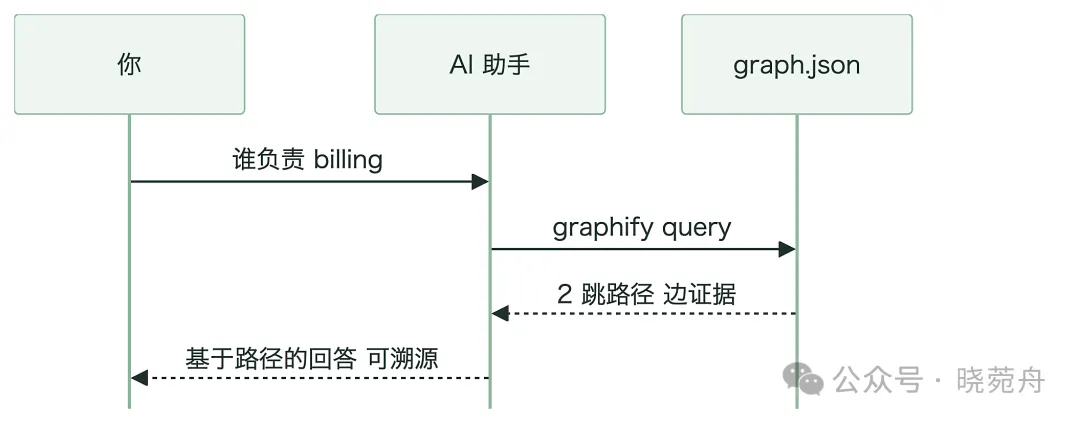
简单说:RAG 是"猜哪些块相关",Graphify 是"沿着真实的调用和 import 边走"。一个是概率,一个是路径。
八、实测数据:省 token 不是吹的
在同一 harness、同模型、同预算、由双盲评审打分的设定下:
LOCOMO(n=300)recall@10 0.497,而 mem0 0.048、supermemory 0.149; LongMemEval-S(n=50)QA 准确率 76%,与稠密 RAG 持平; 图构建的 LLM credits 是 0(对纯代码库而言)。
社区实测更直观:在 496K token 的代码库上,Claude Code + Graphify 比反复读文件少花 79× token;52 文件混合语料下,每轮查询少 71.5× token。
关键洞察:省 token 随语料规模放大。6 个文件本来就装得下上下文,Graphify 的价值在"结构清晰"而非压缩;到了大仓库,压缩红利才真正显现。
九、怎么装、怎么用
两条命令即可:
uv tool install graphifyy # 注意是两个 y,PyPI 上的真包 graphify install # 自动识别你的助手并注册 skill然后在助手里面敲 /graphify .,30 秒出图;之后用 /graphify query "..." 直接查。
进阶玩法也不少:--watch 监听文件变化做增量更新、graphify prs 做 PR 看板(CI 状态、AI 分诊、合并冲突风险)、graphify hook install 在每次 commit 自动重建图谱。
十、适合谁用
- 接手新代码库的人
:一张图 + 一份报告,比 grep 三周 + 问 Slack 快得多; - 做 PR 评审的团队
:按图影响面排序,标出多个 PR 触碰同一社区的合并顺序风险; - 准备重构的人
:先揪出 god node 和紧耦合集群,再动手解耦; - 研究者
:论文、笔记、录音丢进去,按概念关系查,而不是手动翻。
十一、隐私与许可
代码完全本地 tree-sitter 解析,确定性、无遥测、无分析——什么都不发。只有文档 / 媒体的语义层会调用你配置的模型(可换 Ollama 做到全本地)。
项目以 Apache 2.0 开源,源码可审计。你不必信官网那句"代码不出机器",自己读代码就行。
总结
Graphify 的本质,是给代码库一张"地图",让 AI 走路径而不是猜块。确定性解析保证可信,置信度标签保证可审计,本地优先保证隐私。如果你想让 AI 编程助手从"每次重新读"进化到"记得住、查得准",它值得一试。