ARTICLE · 1246864
可观测性与错误隔离:插件崩溃如何不拖垮宿主
13 讲"契约怎么谈",这一篇讲"出了事怎么不连坐"——单点故障不雪崩,是插件系统最后的体面。
引子:签好约之后,是出事别连坐
⑬ 讲"契约怎么谈"——今天写好的插件,宿主明年升级还跑得起来吗?那是静态、时间维度的治理。但还有一个更日常、也更狼狈的问题:契约谈得再好,某个插件在运行里抛个异常、跑个死循环、内存悄悄泄漏,宿主怎么做到不跟着崩?
一个插件崩,全家陪葬——这是插件系统最丢人的时刻。你精心设计了契约(⑬)、隔离(09)、权限(10)、生命周期(11),结果因为一个第三方插件的 while(true) 让整个编辑器卡死、整个设计工具白屏、整个聊天机器人失联。前面所有工程努力,在"运行时单点故障"面前都可能归零。
我把这一篇的主线概括成一句话:
可观测性让故障"看得见",错误隔离让故障"不扩散"——单点故障不雪崩,是插件系统最后的体面。
"看得见"和"不扩散"是两件事,但缺一不可:你拦不住一个你根本看不见的故障;而一个你看得见却关不进笼子的故障,照样会蔓延。下面分两条线讲透。
一、可观测性三支柱:先看得见,才谈得上拦得住
插件系统最怕的不是"出错",而是"偷偷出错"。一个插件悄悄把错误吞掉、把延迟拉高、把内存吃满,宿主毫无感知,直到某天整体雪崩——事后你连"是谁干的"都查不清。所以可观测性(Observability)是错误隔离的前置条件:你拦不住一个看不见的故障。
可观测性的定义很朴素(来源:OpenTelemetry 官方 primer):它让你"从外部理解一个系统,无需知道其内部实现,就能回答'为什么会发生这件事',并排查未知的未知(unknown unknowns)"。前提是系统被正确埋点(instrumented)——也就是持续吐出三类信号:日志(Logs)、指标(Metrics)、追踪(Traces)。
这三类信号,就是业界公认的可观测性三支柱:
- •
日志(Logs):带时间戳的记录,记录"某一刻发生了什么"。最古老也最常用,但孤立的日志缺乏上下文("它是在哪次请求里被调用的?"往往答不上来)。
- •
指标(Metrics):对数值数据在一段时间内的聚合,比如错误率、CPU 占用、请求速率。指标回答的是"系统健不健康",适合做告警阈值。
- •
追踪(Traces):分布式追踪,记录"一个请求穿过多个组件时的完整路径",由一个个 span(工作单元) 串成。它能回答"这次卡顿,卡在哪一段"——对插件系统尤其关键,因为一个用户操作往往穿过宿主内核 + 多个插件。
对一个插件系统而言,可观测性要落到每个插件身上:每个插件的错误率、P99 延迟、内存占用、以及"这次调用到底经过了哪些插件",都得能单独拉出来看。否则,一个慢插件、一个漏插件的错误,会淹没在宿主的总体指标里。
更重要的是——可观测性直接驱动自动恢复。Martin Fowler 在微服务文章里写得很直白(来源:martinfowler.com microservices):"Since services can fail at any time, it's important to be able to detect the failures quickly, and if possible, automatically restore service."(服务随时会挂,所以必须能快速发现故障,并尽可能自动恢复)。插件系统同理:你靠指标发现"某插件错误率飙了",靠追踪定位"是它哪段逻辑",靠日志还原"它抛了什么"——然后才能触发下一节的"关进笼子"。
具体落地上,成熟框架已经把"可追踪"当默认能力:VS Code 的扩展出错会通过 window.showErrorMessage 暴露并指向具体扩展;Koishi/Cordis 明确把"插件抛出的错误可以明确追踪到来源"列为可逆插件系统的优点之一(来源:koishi.chat 可逆性 cookbook)——在超 1000 个插件、依赖错综复杂时,正是这种可追溯性让"谁坏了"一查便知,而不是让坏插件的错误 silently 污染别人。
二、进程级错误边界:崩溃关在笼子里
看得见之后,是"关进笼子"。这里要分清两件事:09 讲"隔离"决定代码跑在哪、能碰什么;这一节讲"错误边界"决定它坏了之后,后果停在哪。 隔离是墙,错误边界是墙塌了之后的兜底。
最硬的错误边界,是进程级隔离——把插件放到和宿主不同的进程里,一个进程崩了,宿主的进程还活着。几个经典样本:
- •
VS Code 的 Extension Host:扩展不是跑在编辑器主线程,而是跑在独立的 Extension Host 进程里。VS Code 官方文档明确写道,Extension Host "prevents extensions from: Impacting startup performance / Slowing down UI operations / Modifying the UI" 来源:code.visualstudio.com Extension Host 文。换句话说,一个扩展再怎么作,它无法直接冻结编辑器界面、无法直接改 UI;当 Extension Host 异常时,VS Code 会提示并提供重载窗口,而不是让整个 IDE 白屏。这正呼应 09 的进程级隔离——墙在这里变成了"出事时的防火墙"。
- •
Chrome 的渲染进程:Chrome 每个标签页/扩展运行在独立的渲染进程,配合 Site Isolation(见 09 已引),一个渲染进程崩溃(那个著名的 "Aw Snap" 页)不会拖垮整个浏览器。崩溃还能通过
chrome://crashes上报 - •
Figma 的 JS 沙箱:Figma 把插件代码放在一个最小化的 JavaScript 沙箱里跑,沙箱不暴露浏览器 API(没有
fetch、setTimeout、DOM),插件只能经由figma全局对象与文档交互;且插件必须主动调用figma.closePlugin()宣告结束,若不关闭,用户会看到"Running [插件名]"提示并随时可取消。Figma 的执行模型历经 iframe → 把 JS 解释器编译成 Wasm → Realms 三次尝试,最终为稳定性采用"把 JS VM 编译成 WebAssembly"——起因是一次 Realms shim 安全漏洞的私下披露 。这个故事的启示是:沙箱不是装饰,它是"插件作恶/作死时,宿主还能活"的最底层担保。 - •
Koishi/Cordis 的可逆副作用:一个插件在加载期抛错,Cordis 的作用域(Scope)模型保证它的副作用能被
fork.dispose()一并清扫,且错误可追溯到来源(来源:koishi.chat 生命周期/disposable)。坏插件的后遗症不会残留在别的插件身上。
这里有个极贴本系列"榫卯/船舶"气质的隐喻——舱壁(Bulkhead)。Martin Fowler 在讲弹性时提到,熔断(Circuit Breaker)与舱壁(Bulkhead)、超时(Timeout)一同出自 Michael Nygard 的《Release It!》(来源:martinfowler.com CircuitBreaker + microservices)。舱壁的本来意思:船舱之间用隔板封死,一个舱进水,水不会淹了全船。套到插件系统:每个插件都该有自己的"舱壁"——独立的进程/线程/作用域、独立的资源账本、独立的错误边界,一个插件溺了,水别漫到别的舱。09 的隔离决定了"舱壁在哪",这一节的"进程级错误边界"决定了"舱壁真的封死了"。
三、弹性三件套:超时、熔断、降级
进程级隔离解决了"一个插件崩,宿主进程还活着"。但还有一类更阴险的故障:插件没崩,只是变慢了、变错了,却把宿主拖进泥潭。这时候要靠运行时三道闸门——它们同样源自《Release It!》,是被 Netflix、微服务社区验证过的老三样:
① 超时(Timeout):永远不要无限等待。 任何对插件的调用都必须有截止时间(deadline)。一个插件 30 秒不返回?直接中止,别让宿主线程干等。超时是成本最低、收益最高的一道闸——它直接消灭"一个慢插件卡死宿主主线程"的经典惨案。Figma 的异步模型 + 用户可取消 + 必须 closePlugin(),本质上就是给插件套了个"最长运行时间"的软超时。
② 熔断(Circuit Breaker):连续失败就先别打了。 如果某个插件最近一直在报错,继续调它只会反复踩雷、还可能引发连锁超时。熔断器的逻辑像电路保险丝:失败率超过阈值就"跳闸"(Open),此后一段时间直接快速失败(fail fast),给插件喘息和恢复的窗口;半开(Half-Open)后试探性放流,恢复了再合上(Closed)。Netflix 开源的 Hystrix 把这套模式工程化(来源:martinfowler.com CircuitBreaker,已 curl 存档)。Martin Fowler 还点出一个要命的事实:"synchronous calls considered harmful"——同步调用有乘法效应,系统的总宕机时间会变成各组件宕机时间的乘积。熔断,正是斩断这条连锁的剪刀。
③ 降级(Fallback / Degradation):功能缺了,体面还在。 插件挂了,别让宿主跟着白屏,而是降级处理:返回缓存/过期数据、返回一个静态默认值、或者干脆停用该功能并提示用户。Martin Fowler 举的例子很接地气:信用卡授权失败可以丢进队列稍后处理;取数据失败可以展示"够用的陈旧数据";定价折扣服务挂了,用零售原价兜底(来源:martinfowler.com microservices/resilience)。降级的核心思想——失败是常态,目标是保护终端体验,而不是甩一张"出错了"的通用报错页。
三件套分工清晰:超时挡得住"慢",熔断挡得住"连续错",降级挡得住"功能缺"。它们和第二节的进程级边界是互补的:边界管"崩了别扩散",三件套管"没崩但坏了也别扩散"。
四、资源配额与背压:内存、CPU、时间不爆
错误边界和弹性三件套管的是"逻辑故障",还有一类"资源故障"得单独拎出来:插件不崩、不慢、不报错,只是无节制地吃内存、占 CPU、刷事件。这种"安静的吞噬"最容易被忽视,却能最彻底地搞垮宿主。
- •
内存配额:一个插件若无限分配对象、缓存不释放,会悄悄把宿主推向 OOM。对策是给每个插件设内存上限(进程/作用域级 cgroup 或 heap 预算),并以 11 的生命周期
dispose保证卸载即清扫(Koishi 的可逆副作用正是此意)。 - •
CPU/时间配额:一个插件跑死循环,不该把宿主 CPU 吃满到无法响应。这又回到隔离的价值——独立的进程/线程你才能单独 kill;再加上第三节的超时,给"最长执行时间"上双保险。
- •
背压(Backpressure):若插件以远超宿主处理速度产生事件/请求(比如一个消息中间件插件疯狂 emit),宿主必须限流、丢载、或有限队列,而不是无界缓冲直到内存爆。背压本质是"上游太快时,下游说'慢点'",它是分布式系统里防止雪崩的呼吸阀。
把 09(隔离)、11(生命周期)、14(配额与背压)串起来,就是一套纵深防御:09 的沙箱决定插件"能碰什么",11 的 dispose 决定"卸得干净",14 的配额决定"能吃多少"。墙、清扫、限量,三道闸一起上,才扛得住千奇百怪的坏插件。
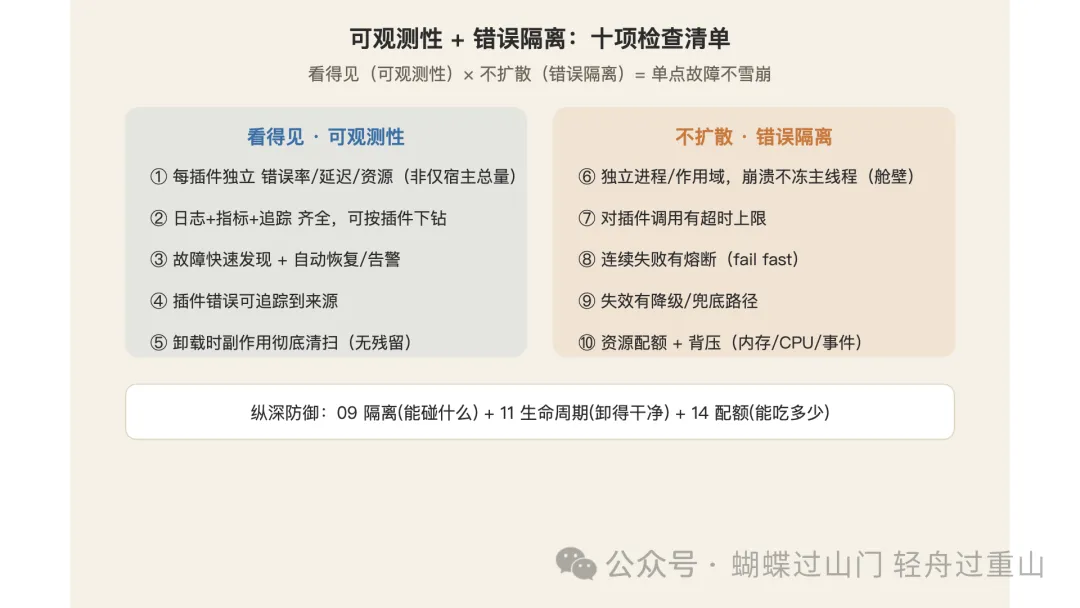
五、可观测性与错误隔离检查清单
把前面四节收敛成一份十项检查清单,给"想做/已做插件系统的人"直接对照:
- •
☐ 每个插件都有独立的错误率 / 延迟 / 资源指标,而非只有宿主总量?
- •
☐ 三类信号齐全:日志 + 指标 + 追踪,且能按插件维度聚合与下钻?
- •
☐ 插件故障能被快速发现并触发自动恢复/告警(不是靠用户投诉)?
- •
☐ 插件运行在独立进程/作用域,崩溃不直接冻结宿主主线程/界面(舱壁)?
- •
☐ 宿主对插件的调用有超时上限,不会无限等待?
- •
☐ 对连续失败的插件有熔断(fail fast)机制,斩断连锁故障?
- •
☐ 插件失效时有降级/兜底路径(缓存/默认值/功能停用提示),而非裸奔报错?
- •
☐ 每个插件有资源配额(内存/CPU/事件),并有背压防止无界缓冲?
- •
☐ 插件错误可追踪到来源,卸载时副作用被彻底清扫(无残留)?
- •
☐ 隔离、生命周期、配额三者是纵深配合而非单选一项?
七、衔接 15:系统稳了,插件怎么到用户手里
本篇我们解决了"出了一个插件崩,宿主不陪葬"——这是运行时、动态维度的韧性治理。但一个能扛住坏插件的系统,只是"建好了,别人却装不上、找不到"也没用。下一站 15《分发与市场:插件怎么找到用户,用户怎么找到插件》,我们从"抗造"切换到"触达":插件市场、分发渠道、版本分发与发现,如何把一个健壮的插件系统,真正连接起开发者与用户。14 讲的是"出事不连坐",15 讲的是"好东西别埋没"。
- 1.
observability-pillars.svg—— 可观测性三支柱:Logs(日志)/ Metrics(指标)/ Traces(追踪)并列,下附"看见什么"(错误率·延迟·内存·请求路径)。 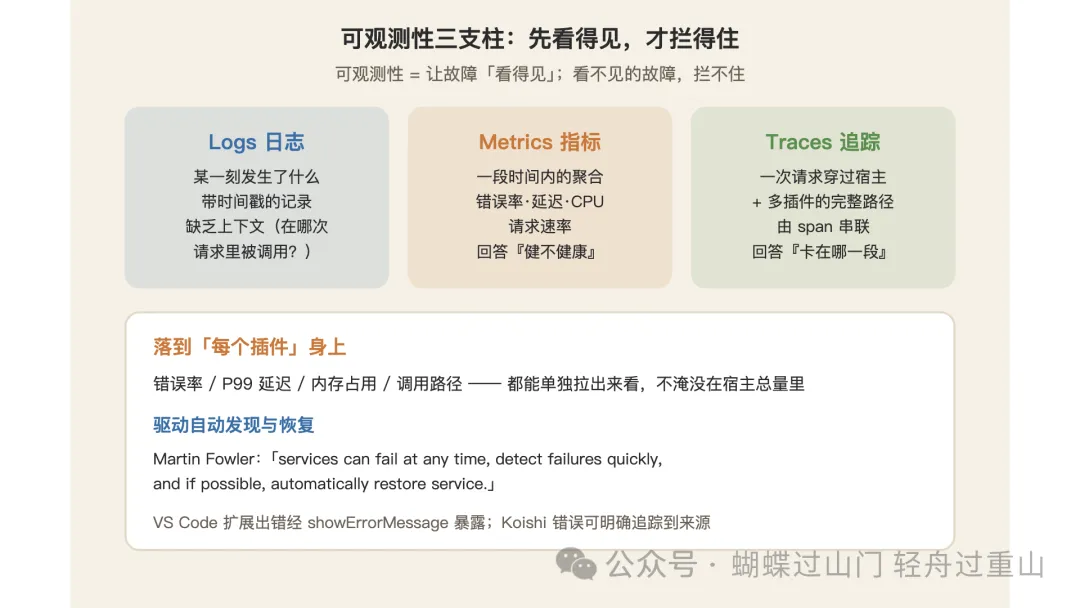
- 2.
error-boundary.svg—— 进程级错误边界 + 舱壁隐喻:宿主进程 vs 各插件舱室(Extension Host / Chrome 渲染进程 / Figma 沙箱 / Koishi 作用域),一舱进水不淹全船。 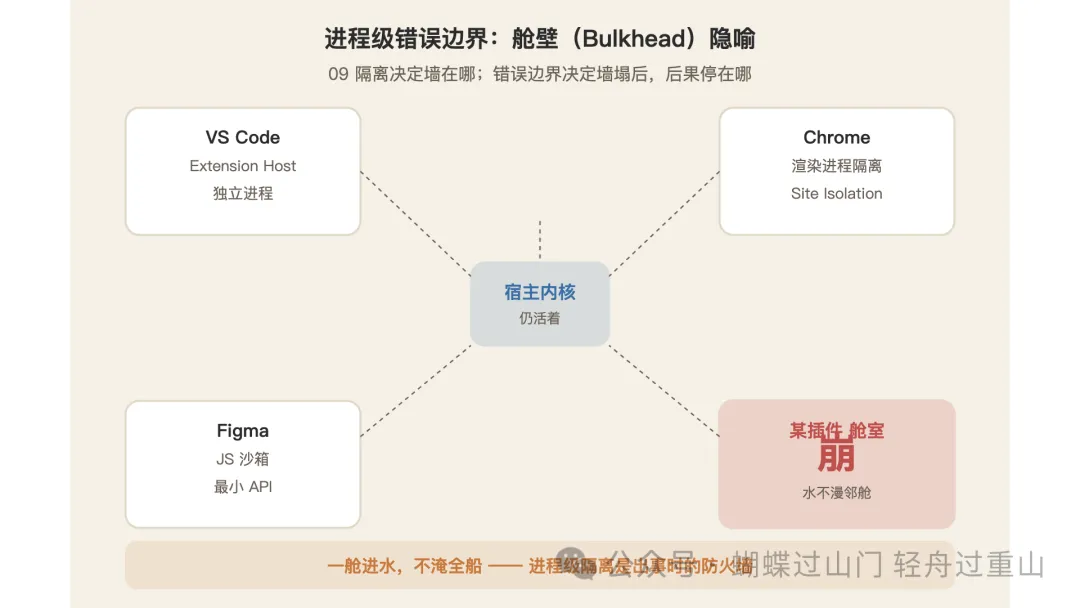
- 3.
resilience-trio.svg—— 弹性三件套:超时(截 deadline)/ 熔断(跳闸 fail fast)/ 降级(缓存/默认值兜底),附"各挡什么"。 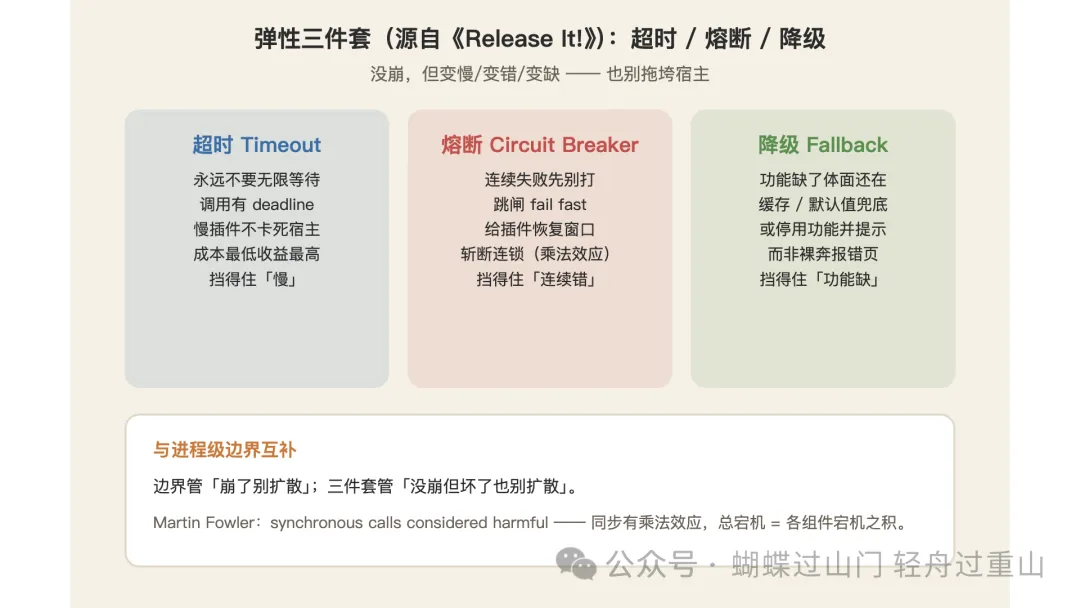
- 4.
observability-checklist.svg—— 可观测性 + 错误隔离十项检查清单(左:看得见;右:不扩散;下:纵深防御)。