ARTICLE · 1249545
手搓一个桌面 AI 创作台,附完整源码
网页版 AI 工具最烦的一点是:标签页一关,活儿就断了。于是我花了几个晚上,把文生文、文生图、文生视频,连同最难搞的分镜长视频,全塞进一个能双击运行的桌面程序里。它叫 Agnes Studio,.NET 10 + Avalonia 11,代码已开源。
01一、先看界面
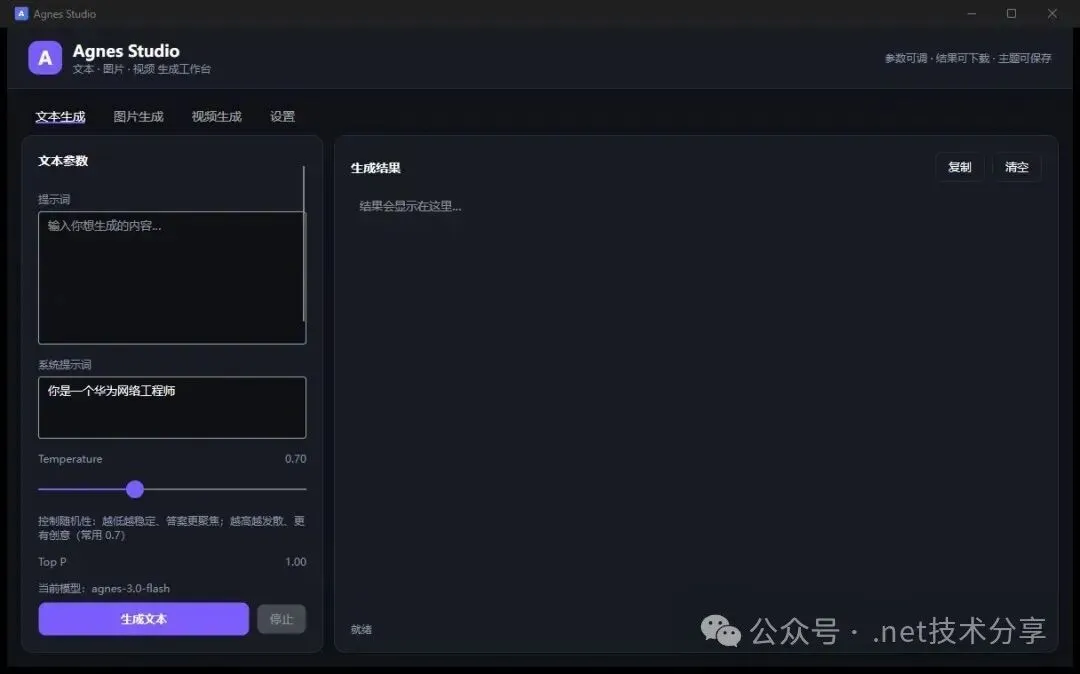
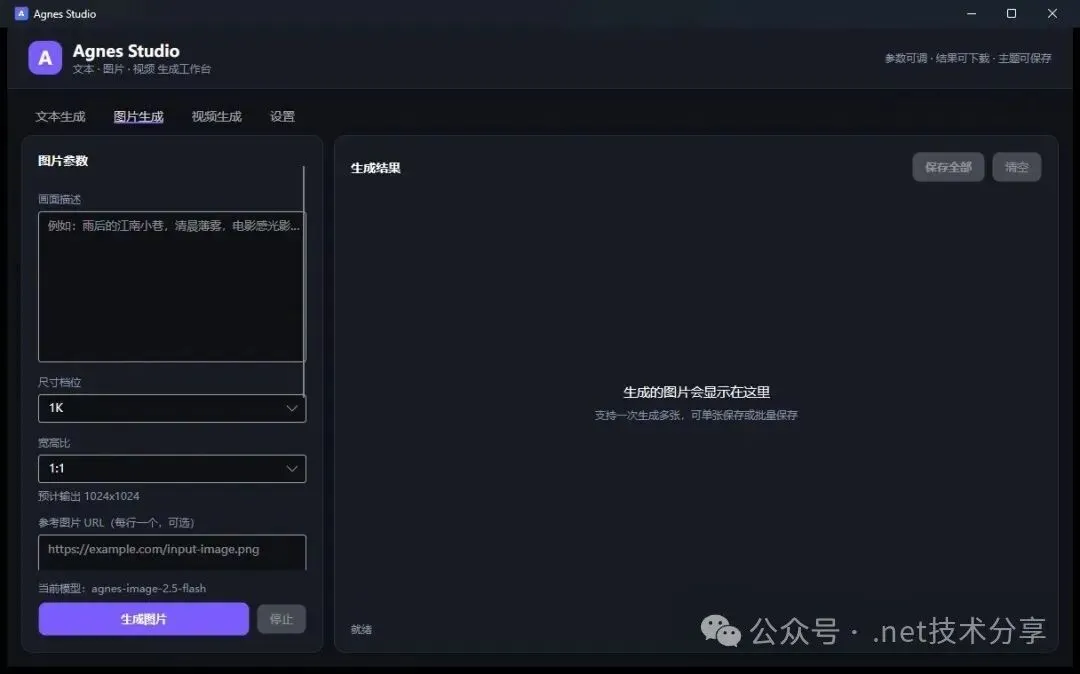
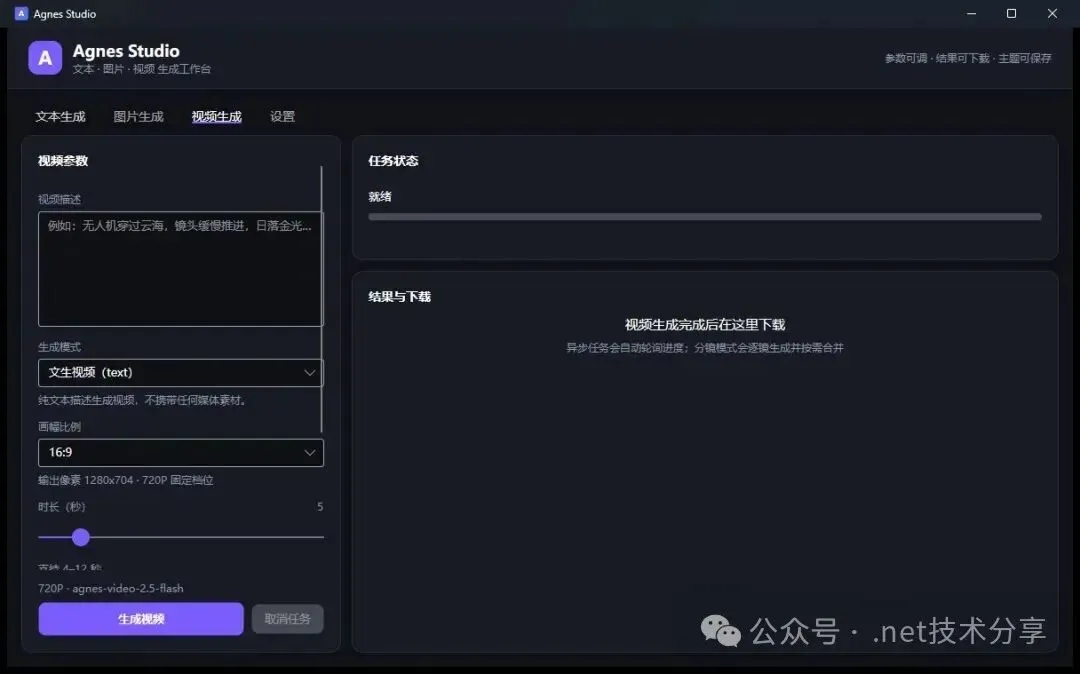
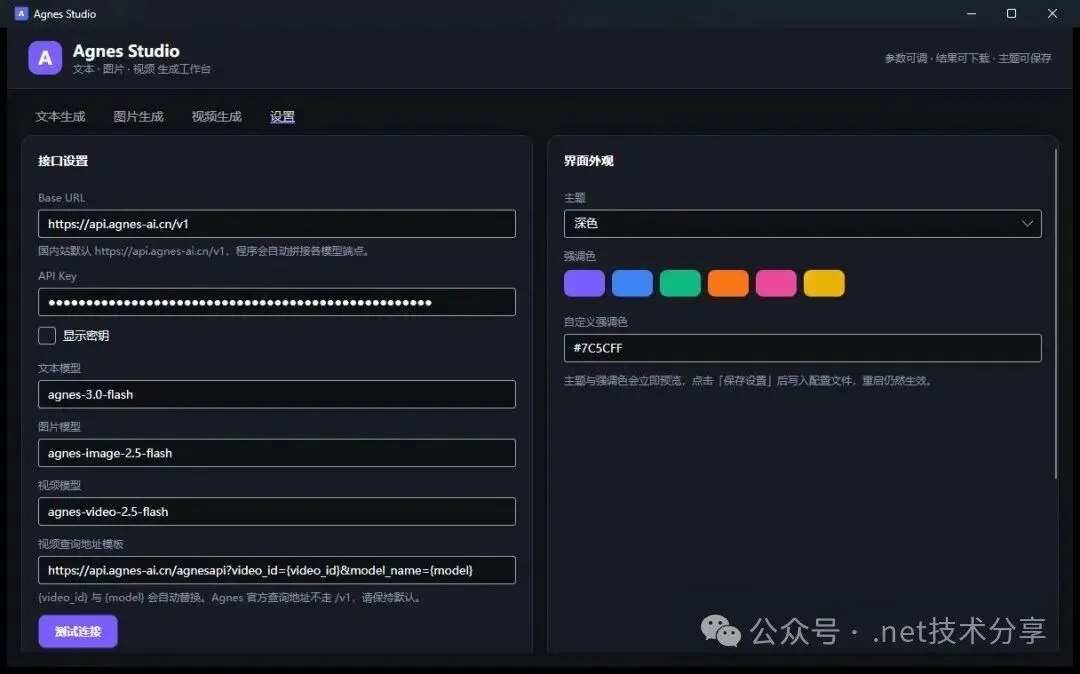
四张实拍截图:文本生成、图片生成、视频生成、设置页。深色主题,左边参数、右边结果,没有多余的按钮。顶部四个标签页切来切去,就是全部功能。
02二、技术栈
没有用 Electron,也没套 WebView,是原生渲染。冷启动一秒多,打包出来是一个 126MB 的单文件 exe,自带运行时,拷到别人电脑上双击就能跑。
▪︎ .NET 10 + Avalonia 11:一套代码跑 Windows / macOS / Linux
▪︎ CommunityToolkit.Mvvm:Source Generator 驱动,属性通知不写样板
▪︎ 手写 HttpClient + System.Text.Json:不引第三方 SDK,返回结构自己解析
▪︎ ffmpeg:分镜片段合并,优先流复制,失败再重编码
▪︎ JSON 配置持久化:主题、配色、模型名、输出目录全部落地
03三、关键代码拆解
下面五段都是真实源码,不是伪代码。公众号正文不支持代码块样式,为了排版不被打散,我用等方式渲染成图;想看文字版直接去仓库。
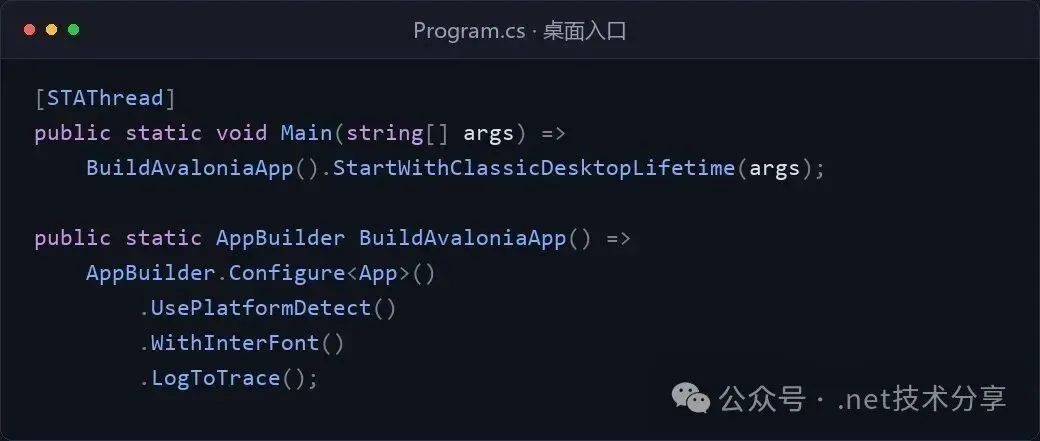
① 桌面入口只有三行。Avalonia 的启动模板短得离谱,真正的重活全在 App 初始化:读配置 → 应用主题 → 建主窗口。
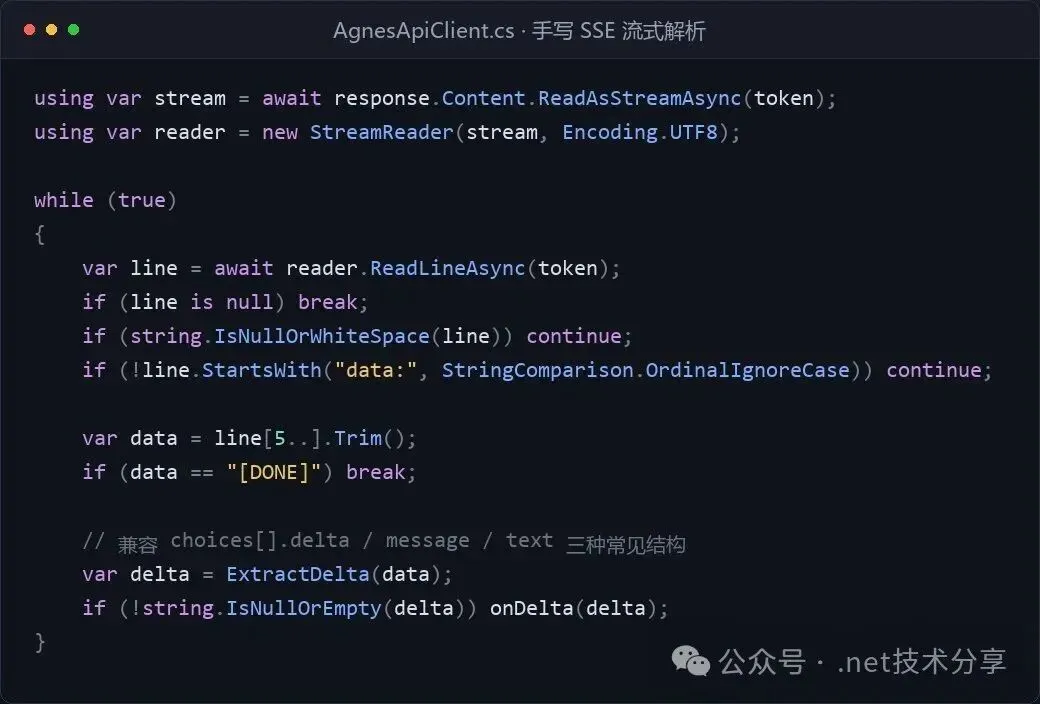
② 流式输出,自己解析 SSE。很多人直接引 OpenAI SDK,但同类接口的返回格式各家都有偏差。手写一个逐行读取的解析器反而最省心:只认 data: 开头的行,遇到 [DONE] 收工,中间的 JSON 用一层容错函数去摸出增量文本。
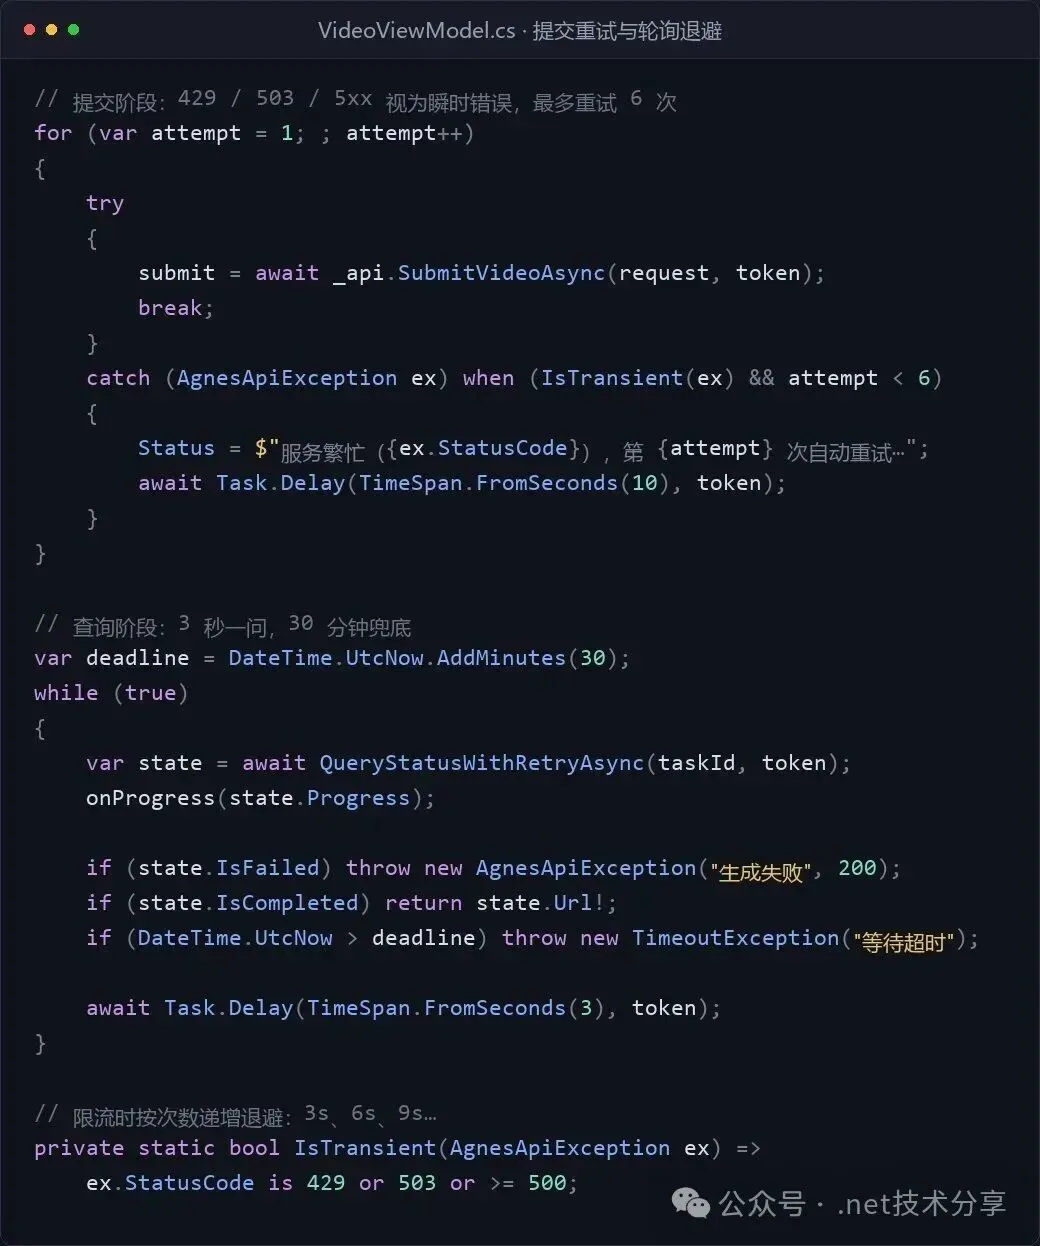
③ 视频:提交容易,等结果难。视频接口是异步的,提交只回一个 task_id。坑在轮询:网络抖动、429 限流、5xx 抽风,随便来一个界面就卡死。我的做法是把 429 / 503 / 5xx 统一定义成「瞬时错误」,提交阶段固定间隔重试,查询阶段按次数递增退避,外层再加 30 分钟兜底超时。
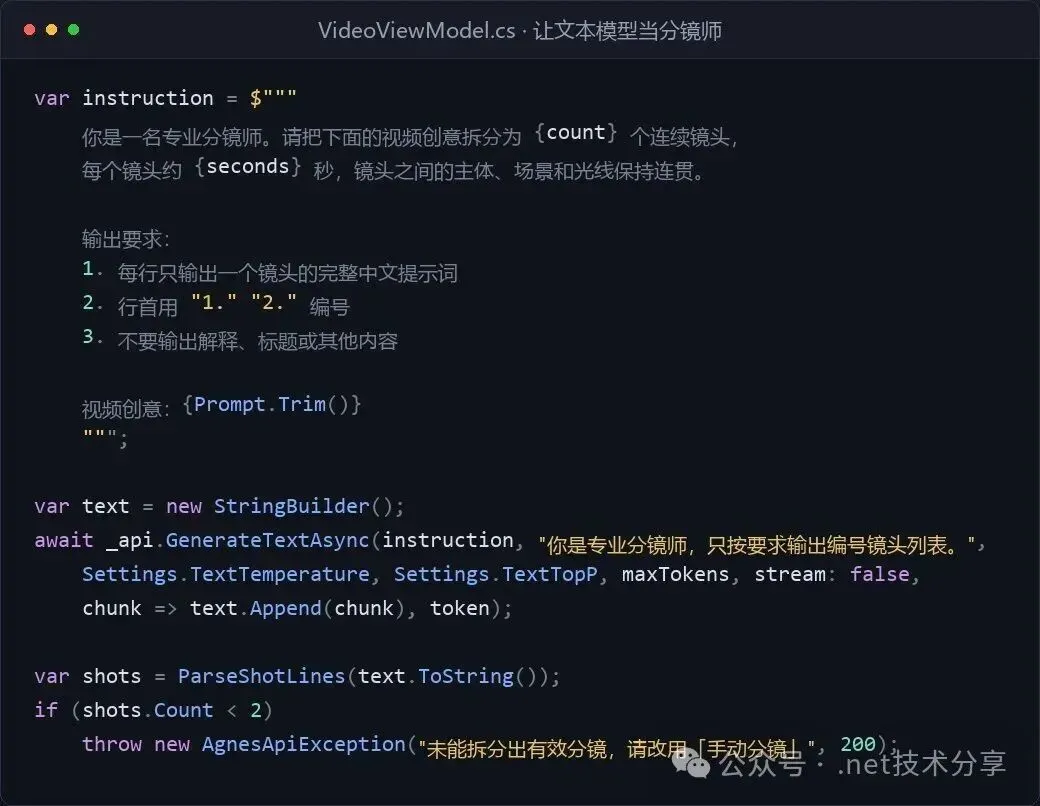
④ 分镜长视频:让文本模型当分镜师。单个视频模型一次只给几秒,想要三十秒成片就得拆:先让文本模型把创意拆成 N 个连贯镜头,再逐个提交、下载,最后用 ffmpeg 拼回去。拆分的全部秘诀就在这段提示词——约束镜头数、单镜时长、连贯性,以及「只输出编号列表」这一条,否则模型会加一堆解释,解析直接崩。
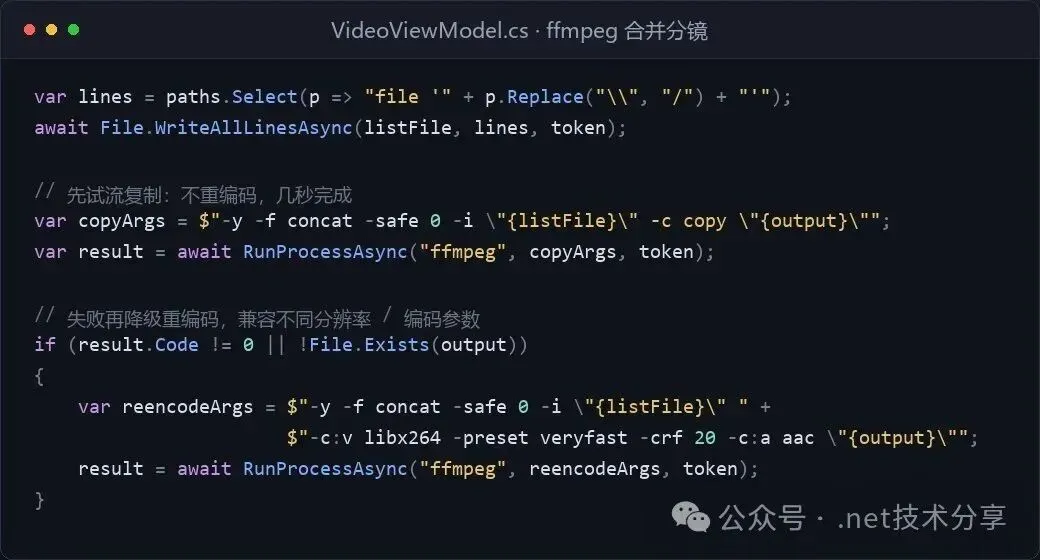
拿到 N 段 mp4 之后,合并的关键是 concat 清单。先试流复制——不重编码,几秒完事;失败再降级到 libx264 重编码,这样不同分辨率、不同编码参数的片段也能拼上。
04四、怎么构建出来
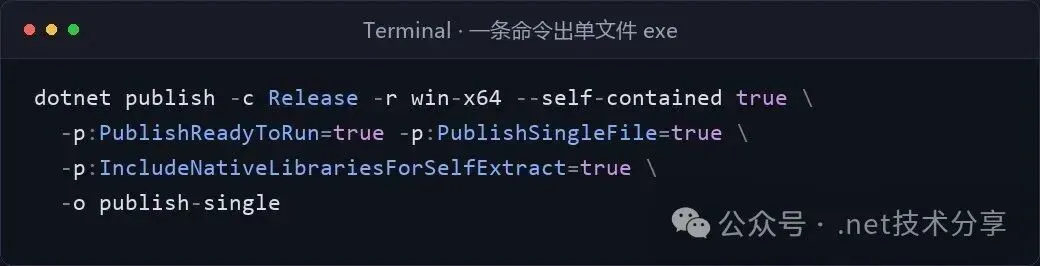
一条命令,跨平台自包含发布。加上 PublishSingleFile,产物就是单个 exe,读者不需要预装 .NET;加上 ReadyToRun,启动还能再快一截。换成 -r linux-x64 或 osx-arm64 就出对应平台的包。
05五、源码获取
仓库地址:https://gitee.com/XiongYunSehng/AgnesStudio
编译成win-X64独立程地址:https://cloud.189.cn/web/share?code=2aYry2QNBZJj(访问码:bo0z)
克隆下来直接 dotnet run 就能起。Base URL 和 API Key 在设置页里填,配置只存本地,不会上传到任何地方。
项目采用 MIT 协议开源,可以自由使用、修改、分发,甚至商用,保留版权声明即可。想改成自己的创作工具,直接 fork 走。
如果这个小工具对你有用,欢迎点个「赞」和「在看」。愿意的话也可以请我喝杯咖啡——你的一点鼓励,就是我继续加功能的动力。