ARTICLE · 1250460
AI天气预报的“盲区”被它抓到了
AI天气预报的“盲区”被它抓到了
Every Fixed Metric Has a Blind Spot: A Learned Atmospheric Critic for Scoring Forecast Realism
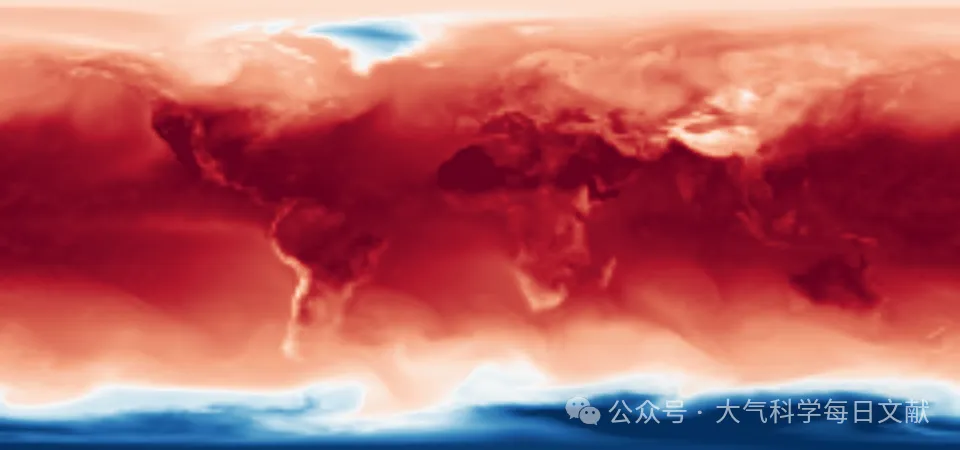
图1
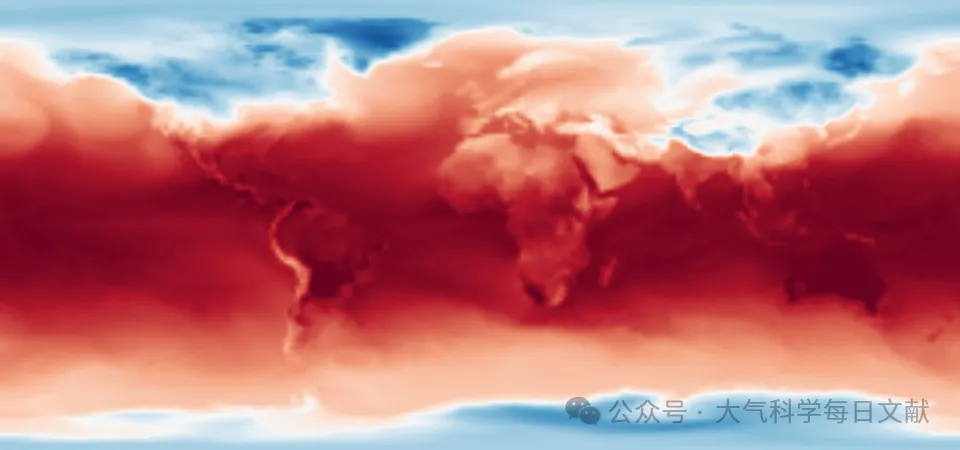
图2
研究背景
近年来,基于机器学习的天气预报模型发展迅猛。以GraphCast、Pangu-Weather、FourCastNet为代表的新一代AI模型,在RMSE等业务排序指标上已能与传统数值天气预报(NWP)比肩,而推理成本仅为后者的零头。然而,高精度并不等于高保真。这些模型在生成预报场时,常常出现各种“不真实”的结构性问题:基于图神经网络的模型容易产生周期性不规则纹理,基于Transformer的方法会出现块状拼接伪影,傅里叶神经算子则可能在极区产生畸变。 这些伪影在传统的逐点指标(如RMSE)中往往被掩盖——因为RMSE偏好过度平滑的预报场,模糊化的输出反而能获得更低的误差。为检测平滑问题,研究者引入了频谱指标;为捕捉特定伪影,又发展了多种固定变换的分布度量。但问题在于:每一种指标都预先锁定了某种表示或变换方式,这就决定了它只能“看见”特定类型的失真。换句话说,每个固定指标都有自己的盲区。
核心问题
本研究要回答的关键问题是:能否设计一种不预设失效模式的真实性评分方法,使其能够自适应地发现模型输出中任何偏离真实天气的结构?换言之,能否让指标本身“学会”识别伪影,而不是由研究者事先规定要看什么?
研究方法
作者提出了一种“学习型大气评判器”的思路。具体而言,训练一个判别器网络,其任务是区分ERA5再分析数据(真实天气)与天气预报模型的输出场(可能含有伪影)。判别器的输出logit被转化为一个类似散度的真实性评分:评分越高,说明模型输出越接近真实分布;评分越低,说明存在越明显的非真实结构。 这一设计的巧妙之处在于:判别器不需要事先知道模型会出现哪种失效模式,它会自动学习任何能将模型场与真实天气区分开的特征。无论是周期性纹理、块状伪影还是极区畸变,只要在统计上可区分,判别器就能捕捉到。 为系统评估该方法,作者在ERA5数据上施加了多种合成损坏(如模糊化、周期性噪声、块状拼接、极区畸变等),模拟不同类型的失效模式,并将学习型评判器与现有指标进行对比。随后,作者还将该方法应用于真实天气预报模型的输出,包括数值模型和多种机器学习模型,考察评分随预报时效的变化规律。
主要发现
在合成损坏实验中,学习型大气评判器成功识别了所有类型的损坏,并能按其严重程度进行合理排序。相比之下,现有基线指标虽然各有擅长,但至少在某一种损坏上完全失效——它们的盲区彼此互补,却没有一个能覆盖全部失效类型。这直接验证了“每个固定指标都有盲区”的核心论点。 在真实预报评估中,评判器给出的真实性评分随预报时效延长而下降,符合预报误差随时间增长的物理预期。更值得注意的是,该指标总体上对数值天气预报给出比机器学习模型更高的真实性评价——尽管AI模型在RMSE上表现优异,但其输出场在结构真实性上仍逊于传统方法。这一发现揭示了逐点精度与场结构真实性之间的深层张力。
创新亮点
与已有指标相比,本方法的核心创新在于“让数据说话”:不预设变换方式,不锁定检测目标,而是通过判别器自适应地发现模型输出与真实天气之间的任何可区分差异。这从根本上规避了固定指标的结构性盲区。此外,判别器模型本身相对轻量,训练成本可控。
研究意义
这项工作为天气预报模型的评估提供了一个全新的视角:除了问“预报准不准”,还要问“预报像不像”。对于AI天气模型的开发而言,该指标可以作为诊断工具,帮助研究者发现RMSE无法揭示的结构性缺陷,从而指导模型改进。对于业务应用而言,真实性评分有望成为现有评分体系的有益补充,帮助预报员判断AI产品在特定时效下的可信度。
未来展望
作者指出,当前方法的一个局限是评分依赖于判别器的选择及其最容易检测的模式,且每组比较分布需要单独训练判别器。未来工作可探索跨预报模型迁移的通用评判器(初步实验已显示令人鼓舞的结果),以及以初始状态为条件的分布比较,进一步提升评估的针对性和可解释性。
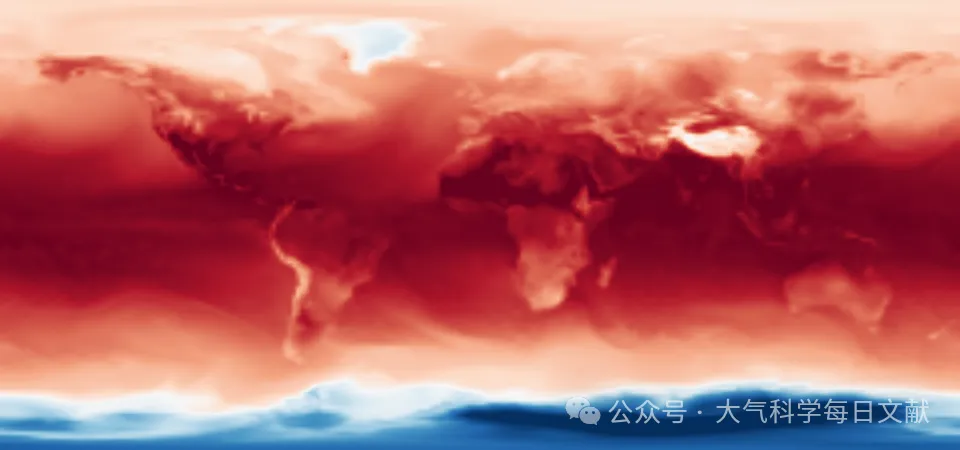
图3
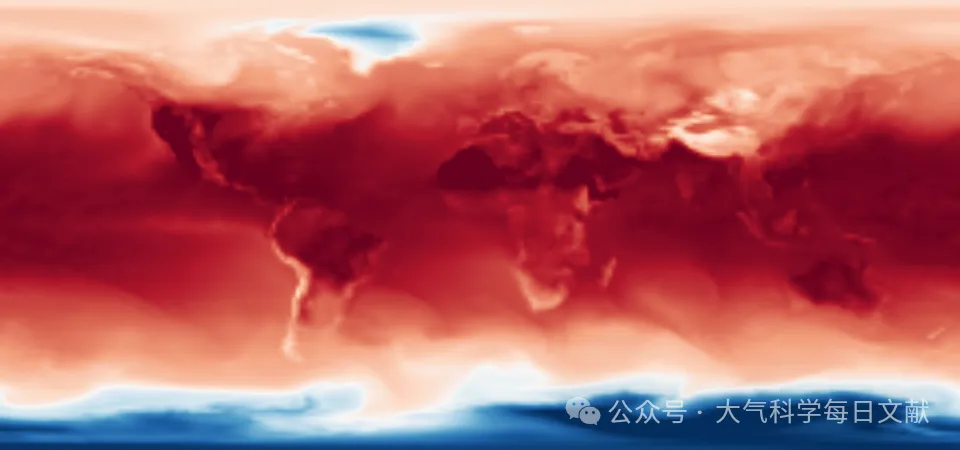
图4
📎 论文链接:http://arxiv.org/abs/2609.18381v2
📅 发布时间:2026-09-16